

一家名为 Taalas 的加拿大初创公司做了一件听起来不可能的事:把 Meta 的 Llama 3.1 8B 模型直接硬连线进了一颗芯片。他们在一块 815mm² 的裸片上,把模型权重蚀刻进 530 亿个晶体管里。
结果是每用户每秒 17,000 个 token。这比市面上其他任何方案快约 8 到 74 倍,其中包括 Nvidia 的 H200、Groq 的 LPU 和 Cerebras 的晶圆级引擎。
最有意思的一点在于,尽管是硬连线的,HC1 依然支持 LoRA 微调。这改变了我们看待微调在 AI 技术栈中所处位置的方式。
Taalas 到底造了什么
HC1 是一颗采用台积电 6nm 制程制造的专用集成电路(ASIC)。每一颗 GPU 的做法都是用通用算力从内存里读取权重来运行模型,而 Taalas 把 Llama 3.1 8B 的架构直接编译进了硅片。
关键规格:
| 规格 | HC1 |
|---|---|
| 模型 | Llama 3.1 8B(硬连线) |
| 制程 | 台积电 6nm |
| 裸片面积 | 815mm² |
| 晶体管数量 | 530 亿 |
| 吞吐量 | 每用户每秒约 17,000 个 token |
| 功耗 | 2.5 kW 整机 |
| 量化 | 自定义 3-bit 基础 + 6-bit 参数 |
| LoRA 支持 | 支持(适配器可配置) |
| 上下文窗口 | 可配置 |
该公司在 2026 年 2 月完成 1.69 亿美元融资后走出隐身状态,投资方包括 Quiet Capital、Fidelity 以及半导体投资人 Pierre Lamond;据路透社报道,这轮之后累计融资达到 2.19 亿美元。一支 24 人的团队用约 3,000 万美元的实际支出造出了 HC1,在芯片项目动辄九位数预算的领域里,这是个相当扎眼的数字。所有数字均为 2026 年 2 月的数据。
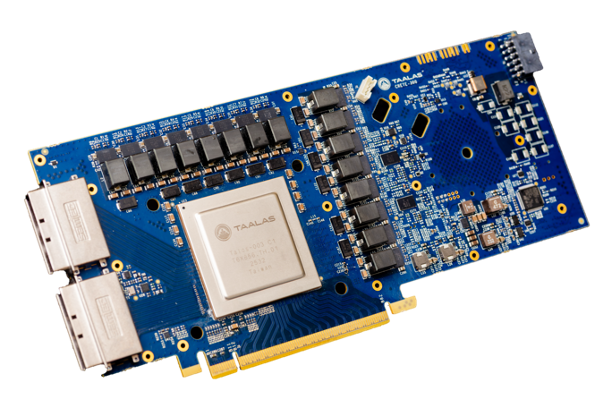 来源:Taalas。图片转载用于编辑评论,所有权利归 Taalas Inc. 所有。
性能差距大得离谱
基准数字把 HC1 放进了一个和现有推理硬件完全不同的档次:
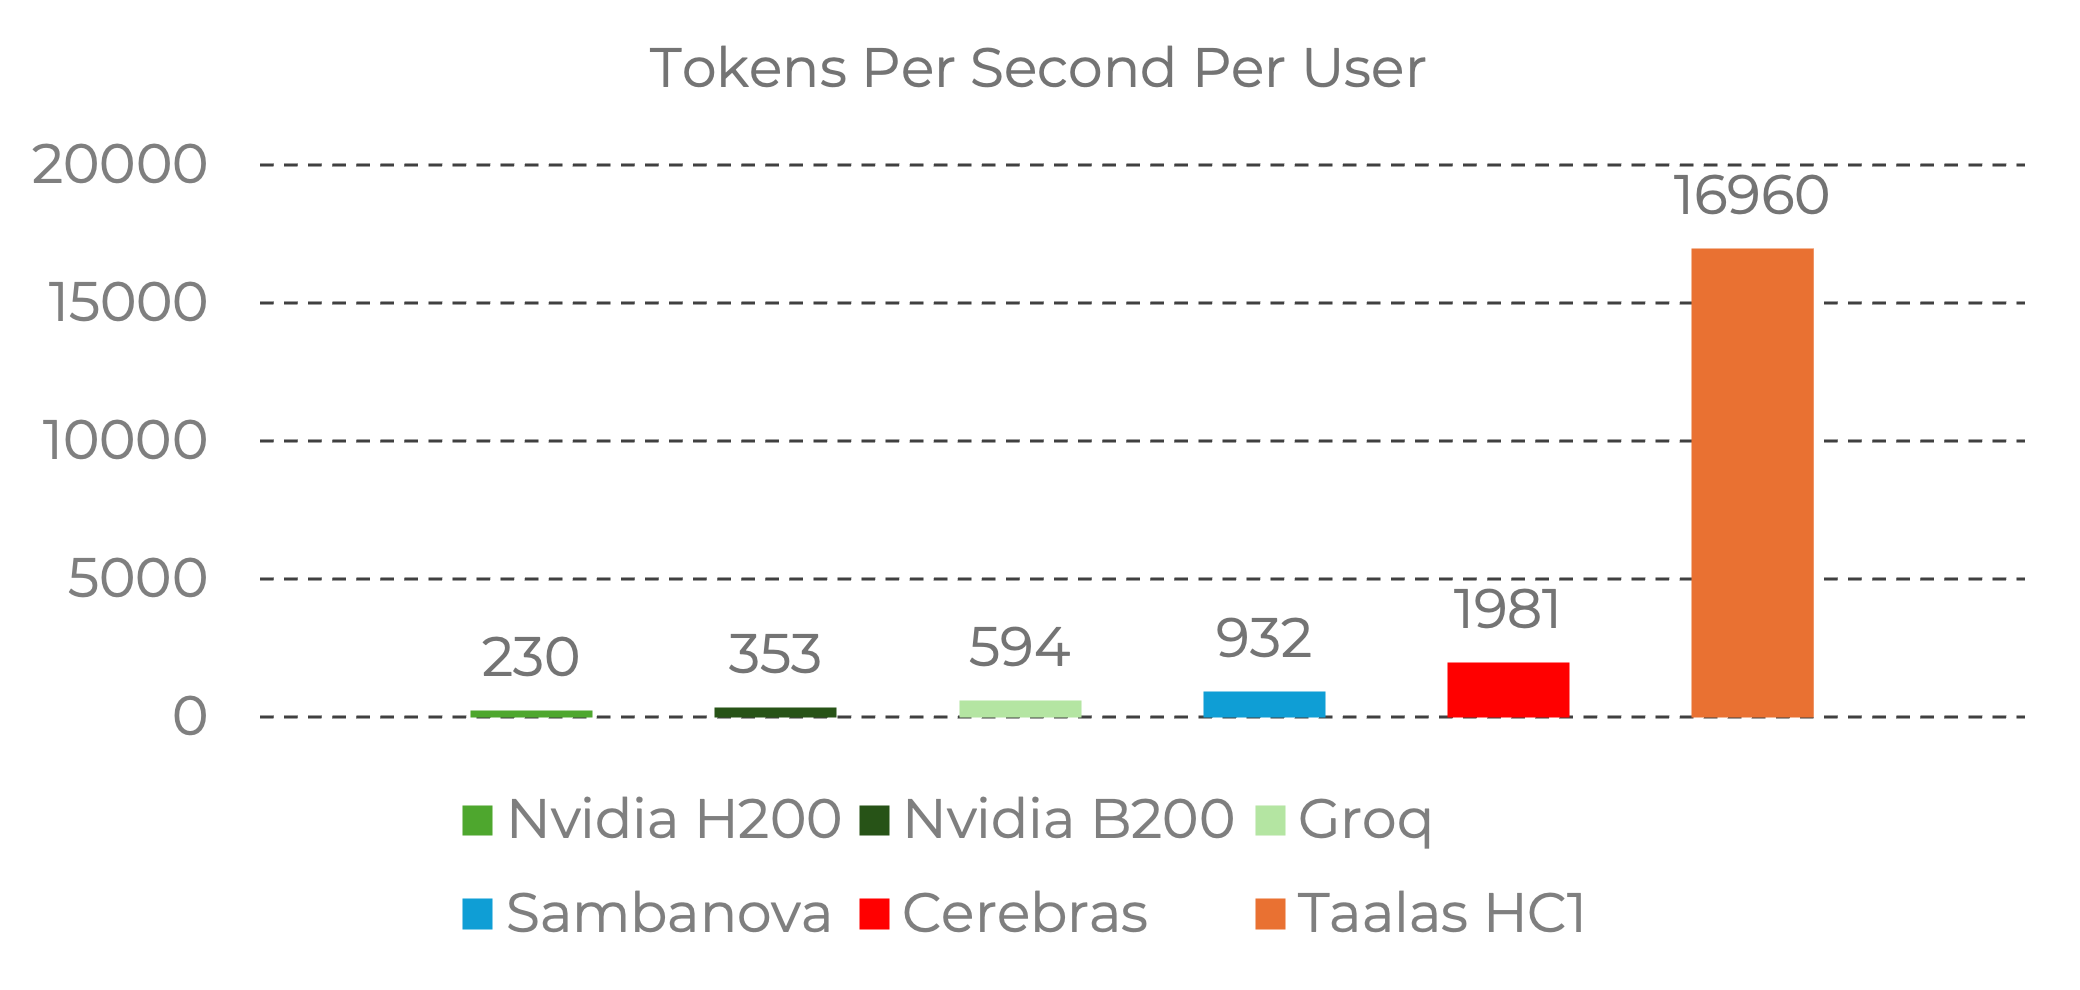 来源:Taalas。基准数据来自 Nvidia 官方基线与 Artificial Analysis 的服务商数据。图片转载用于编辑评论,所有权利归 Taalas Inc. 所有。
给这些数字一点参照:
- Nvidia H200:每用户每秒约 230 个 token
- Groq LPU:每用户每秒约 600 个 token
- Cerebras:每用户每秒约 2,000 个 token
- Taalas HC1:每用户每秒约 17,000 个 token
成本这一面同样夸张。Kaitchup 的 Benjamin Marie 测算,HC1 的推理成本约为每百万 token 0.0075 美元,此为截至 2026 年 8 月的数据。放在其他专用芯片里比较,这大约比已公开的 Groq LPU 最低费率便宜 7 倍,比 Cerebras 便宜约 13 倍。和通用 GPU 以及前沿 API 相比,差距会拉开好几个数量级,不过具体倍数完全取决于你拿哪一档 API 来比,所以值得拿自己的账单算一遍,而不是直接采信一个标题数字。
关于以上数字有两点需要说明。Marie 给的是推理成本的测算,并非谁在按这个价格卖给你;而且各家的费率一直在变。我们的推理硬件对比里有完整的分厂商表格。
代价是灵活性。HC1 只能运行 Llama 3.1 8B,别的模型加载不上去。它是一颗单模型芯片。
而这正是 LoRA 登场的地方。
硬连线硅片上的 LoRA 支持为什么重要
有一个细节值得每一位开发者留意:基础模型已经被物理地烧进了晶体管,HC1 却仍然支持低秩自适应(LoRA)微调。
LoRA 适配器是轻量的定制层,通常在 50 到 200MB 之间,叠在基础模型之上,把它专门化到某个领域或任务。在 HC1 上,基础的 Llama 3.1 8B 权重为了速度而硬连线,LoRA 适配器权重则加载进片上 SRAM,负责提供灵活性。
这意味着:
- 一颗芯片,多种专业化。 加载一个法律领域的 LoRA 适配器,这颗芯片就是一个法律 AI;换成医疗 LoRA,它就是一个临床 AI。基础模型始终不动,变的是专业化那一层。
- 微调模型跑出硬件级速度。 你的领域专用微调模型以每秒 17,000 个 token 运行。
- 多租户模式在硅片上成立。 代理公司在共享的基础设施上为每个客户挂一套 LoRA 适配器?HC1 让这件事直接发生在硬件层。
这是一次范式转移。LoRA 最初被设计成一种省显存的训练技术,让人不必承担全参数微调的成本就能微调大模型。如今它正在变成一种硬件部署接口。适配器格式就是你在专用硅片上部署的方式。
硬连线微调模型的经济账
拿一个真实场景算一算。
一家 AI 代理公司同时运营 15 个客户的聊天机器人,每个客户一套 LoRA 适配器:
| 部署方式 | 每月成本 | 每秒 token 数 | 隐私 |
|---|---|---|---|
| OpenAI GPT-4o(15 个客户) | 4,200 美元以上 | 50 到 100 | 数据发往 OpenAI |
| GPU 自托管 8B | 150 到 400 美元 | 20 到 50 | 完全自控 |
| Taalas HC1 + 15 套 LoRA 适配器 | 无法购买,无公开报价 | 17,000 | 完全自控 |
HC1 目前还不能买回本地部署。Taalas 现在在 chatjimmy.ai 以测试版 API 服务的形式提供推理。但方向是清楚的:面向微调模型的专用硬件正在从理论走向生产。
历史的类比:CPU、智能手机与 AI 芯片
这件事以前发生过,而且不止一次。
1946 年,ENIAC 占满一整个房间,每秒执行 5,000 次运算。到 1971 年,Intel 的 4004 微处理器把相当的算力装进了指甲盖大小的芯片。到 2007 年,iPhone 把一台完整的电脑放进了每个人的口袋。
每一代硬件都催生出全新的使用类别。大型机服务企业,个人电脑服务知识工作者,智能手机服务所有人。
AI 推理正走在同一条轨迹上:
- 数据中心 GPU(2020 到 2024 年):AI 作为云服务
- 边缘推理(2024 到 2026 年):AI 跑在本地硬件上(Ollama、llama.cpp、LM Studio)
- 专用硅片(2026 年起):AI 硬连线进专门打造的芯片
- 端侧(下一步):AI 嵌入每一台设备
HC1 处在第三阶段。微处理器当年需要软件(操作系统、应用程序)才能在原始算力之外派上用场;同样地,专用 AI 硅片需要微调模型,才能在跑一个通用聊天机器人之外派上用场。
微调就是让专用 AI 硬件产生价值的那一层软件。
Taalas 接下来要做什么
Taalas 给出了清晰的路线图:
- 2026 年春:HC1 平台上的中等规模推理模型,把思维链和多步推理带上专用硅片
- 2026 年冬:HC2 上的前沿 LLM。这是第二代芯片,密度更高、执行更快。HC2 同时改用标准的 4-bit 浮点格式,以化解 HC1 激进的 3-bit 量化带来的质量妥协
该公司称,把一个新模型变成可用的硅片大约需要两个月。如果这个节奏成立,每一次重要的开放权重模型发布都可能对应一颗 HC 系列芯片。
更新:AMD 正在收购 Taalas
2026 年 8 月 6 日,AMD 宣布达成收购 Taalas 的最终协议。条款未公开,交易仍须满足惯例的交割条件并取得监管批准,因此截至 2026 年 8 月,这是一桩已宣布而尚未完成的收购。外部报道预计将于 2026 年第四季度交割。
AMD 表示会把该技术并入自己的加速器路线图,并与 Instinct GPU 一起构建系统级方案。AMD 人工智能部门负责人 Vamsi Boppana 将这次收购描述为带来“差异化的推理性能与效率”。Taalas 联合创始人 Ljubisa Bajic 表示,加入 AMD 让团队获得“加速创新所需的规模、工程资源与全球影响力”。
这对上面那份路线图意味着什么。 那些日期是 Taalas 作为一家独立公司公布的,如今这份工作已经进了别人的产品线,所以把它们读作意向而非承诺。Futurum 的分析预期 HC1 产品线不会原封不动地延续,团队更可能的任务是优化客户的工作负载,比照 AMD 与 Meta 的协同设计模式。SiliconANGLE 报道指出,HC2 瞄准约 200 亿参数规模的模型。关于 chatjimmy.ai 测试版,目前没有任何公告。
我们另外写了一篇关于这笔收购及其背后趋势的完整拆解,其中包括它与八个月前 Nvidia 取得 Groq 授权的对比。
核心论点完好,甚至更响亮了。 Nvidia 在 AI 加速器领域的主要对手,刚刚花钱买下了把特定模型烧进硅片的能力。无论 HC1 作为一件可购买的产品最终走向如何,它所主张的东西已经有人买单了:对于一个你打算大量运行的模型,通用性是一笔成本,而把这个模型烧进硬件,能换回一个数量级的速度与功耗。这笔交换只有在你手里有值得烧录的模型时才划算,而那正是本文开头谈的微调。
这对开发者当下意味着什么
你不需要等 Taalas 把硬件送到门口,才能顺着这个信号行动。
要点是战略层面的: 硬件厂商把 LoRA 支持做进硅片,是因为他们把微调看作未来的部署接口。如果你要把 AI 做进自己的产品、工作流或者代理公司的服务里,那么你部署的模型应该是为你的领域微调过的。
现在可以做的事:
-
今天就在开放权重模型上做微调。 Llama、Qwen、Gemma、Phi:挑一个适合你任务的基础模型。你今天做出来的 LoRA 适配器,现在能跑在 GPU 上,将来也能跑在专用硅片上。
-
导出成可移植的格式。 本地推理用 GGUF(Ollama、llama.cpp、LM Studio),LoRA 适配器用标准格式。别把自己锁死在单一部署目标上。
-
按适配器来思考,而不是整块模型。 一个基础模型 + 多个 LoRA 适配器 = 一次训练投入服务多个客户、多种场景、多个部署目标。
-
从使用场景出发,而不是从硬件出发。 无论你部署在 GPU、边缘设备还是专用硅片上,微调好的模型是那个常量,硬件是变量。
微调的窗口正开着
Taalas 只是一个更大趋势里的一个信号。MarketsandMarkets 预测边缘 AI 硬件市场到 2030 年将达到 590 亿美元,Deloitte 预期到 2026 年底,推理负载将占全部 AI 算力的约三分之二。而要让跑在这些硬件上的模型真正有用,它们需要针对具体领域做微调。
现在就开始学微调的团队会去建数据集、训练适配器、验证质量;等硬件跟上来的时候,他们手里已经有可投入生产的模型了。观望的人则要在竞争对手已经上线之后从零开始。
Ertas 让没有 ML 背景的开发者也能做微调。上传数据集,可视化地微调,导出为 GGUF 或 LoRA 适配器,随处部署。你今天微调出来的模型,就是明天跑在新硬件上的那个模型。
本文参考了 Taalas 的公告与产品页面,并采用了来自 WCCFTech、EE Times、Data Center Dynamics 与 Kaitchup 的补充分析。