


AI 推理硬件市场正在分化。过去很多年里,跑大语言模型只有 Nvidia GPU 这一个认真的选项。到了 2026 年,至少有五条根本不同的技术路线在争夺推理工作负载,它们在速度、成本、灵活性和微调支持之间各自做出了不同的取舍。
这篇对比拆解每条路线提供什么,以及它适合放在哪里。
登场选手
Nvidia:通用 GPU
路线: 通用 GPU,具备大规模并行能力和大容量 HBM(高带宽内存)。同一套硬件既能训练模型,也能对外提供服务。
在售产品: H100(80GB HBM3)、H200(141GB HBM3e)、B200(192GB HBM3e)
主要优势:
- 可运行任意模型架构、任意规模
- 完整微调与推理都在同一套硬件上完成
- 软件生态最大(CUDA、TensorRT、vLLM)
- 在每一家主流 AI 公司的大规模生产中都得到了验证
主要限制:
- 昂贵(每张 GPU 25,000 至 40,000 美元以上)
- 功耗高(每张 GPU 700W 以上)
- 与专用硬件相比,单用户吞吐量一般
- 高端型号供应紧张
推理性能(Llama 3.1 8B): H200 上每用户约 230 token/秒
Groq:语言处理单元(LPU)
路线: 专门设计的推理芯片,称为语言处理单元(LPU)。针对顺序生成 token 做了优化,执行过程是确定性的,没有可变的调度开销。
主要优势:
- 单用户推理很快(Llama 8B 级别约 600 token/秒)
- 延迟确定(不存在时长不定的等待)
- 专为自回归推理设计
- 以云 API 形式提供
主要限制:
- 只做推理,没有训练能力
- 仅限已支持的模型架构
- 硬件层面不支持微调
- 目前只有云服务一种形态
Cerebras:晶圆级引擎
路线: 把一整片硅晶圆当作单颗芯片。CS-3 在一片晶圆上集成了 4 万亿个晶体管和 90 万个核心,面向极大规模的训练与推理设计。
主要优势:
- 巨大的片上内存消除了内存瓶颈
- 推理快(Llama 8B 级别每用户约 2,000 token/秒)
- 单套系统就能承载非常大的模型
- 提供云推理 API
主要限制:
- 硬件极其昂贵
- 主要以托管服务的形式提供
- 晶圆级制造良率偏低
- 硬件层面没有内置的 LoRA/微调支持
SambaNova:可重构数据流架构
路线: 可重构数据流单元(RDU),能针对不同的模型架构做优化,训练和推理都能处理。
主要优势:
- 可针对不同模型架构重新配置
- 训练与推理兼顾
- 面向企业,提供托管服务
- 支持多种模型规模
主要限制:
- 生态规模小于 Nvidia
- 与竞争对手相比,公开的基准数据有限
- 主要面向企业与云端部署
Taalas:模型上硅(ASIC)
路线: 把某个特定模型的权重直接固化进 ASIC 的晶体管里。推理时无需从内存搬运权重,模型本身就是芯片。HC1 是他们的首款产品,运行 Llama 3.1 8B。
主要优势:
- 单用户推理最快:约 17,000 token/秒
- 每 token 成本最低:每百万 token 约 $0.0075
- 功耗最低:整机 2.5 kW
- 支持用 LoRA 适配器做定制
- 建造成本比 GPU 方案低 20 倍
主要限制:
- 锁定单一基础模型(HC1 上是 Llama 3.1 8B)
- 激进量化(3 bit)带来质量上的取舍
- Beta 产品,还不能作为本地部署硬件采购
- 无法运行其他模型架构
正面对决
| Nvidia H200 | Groq LPU | Cerebras CS-3 | SambaNova | Taalas HC1 | |
|---|---|---|---|---|---|
| 架构 | 通用 GPU | 自研 LPU | 晶圆级 | 数据流 RDU | 模型上硅 ASIC |
| Token/秒/用户(8B) | ~230 | ~600 | ~2,000 | ~800(估算) | ~17,000 |
| 每百万 token 成本 | ~$0.50-2.00 | ~$0.05-0.27 | ~$0.10 | 不适用(企业定制) | ~$0.0075 |
| 模型灵活性 | 任意模型 | 多种 | 多种 | 多种 | 单一 + LoRA |
| 训练支持 | 完整 | 无 | 完整 | 完整 | 无(仅 LoRA 推理) |
| LoRA 微调 | 完整 | 否 | 否 | 否 | 硬件级 LoRA |
| 单卡功耗 | 700W 以上 | ~300W | 高 | 中等 | 每卡约 250W |
| 制造工艺 | 成熟(TSMC 4/5nm) | 定制 | 晶圆级 | 定制 | TSMC 6nm |
| 可获得性 | 采购或云端 | 云 API | 云 API 或托管 | 企业托管 | Beta API |
| 本地部署 | 支持 | 目前不支持 | 有限 | 支持(企业) | 尚不支持 |
性能可视化
把吞吐量差距画出来之后,差别相当悬殊:
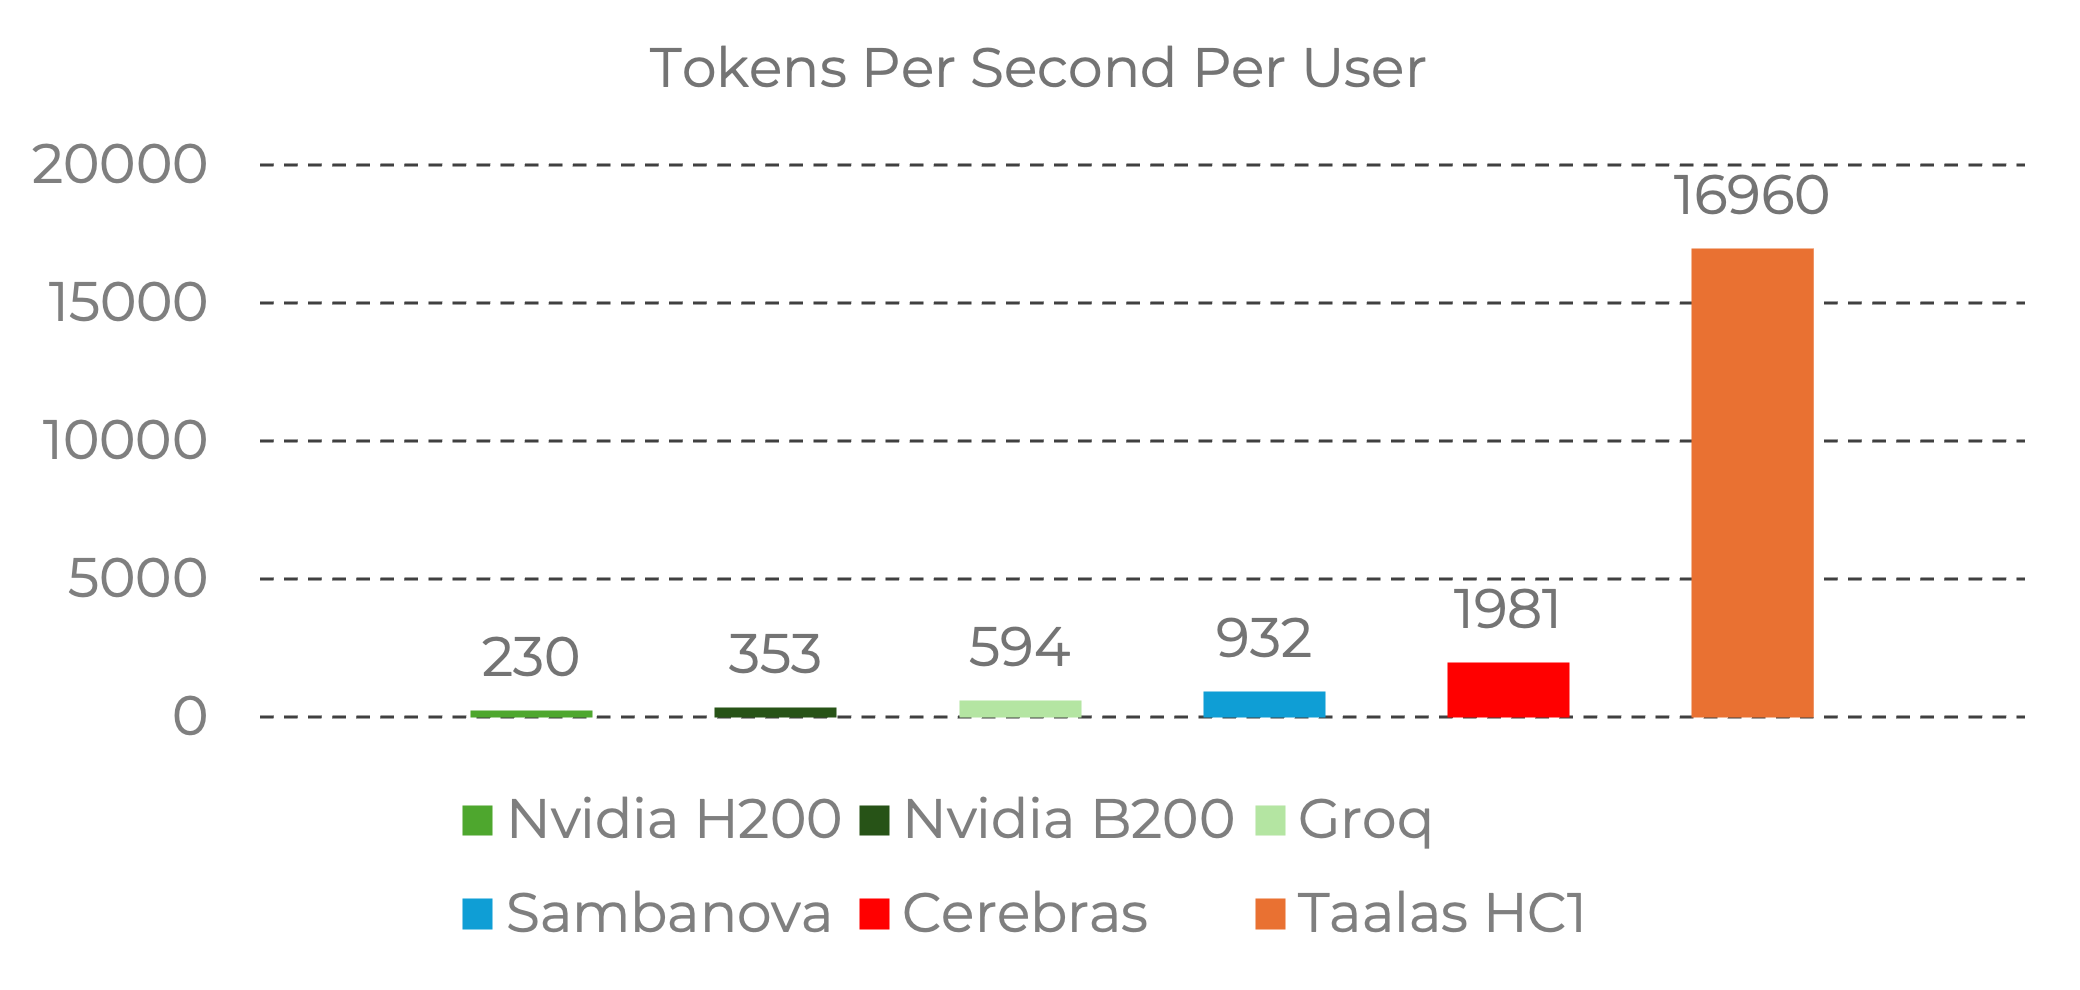 来源:Taalas。基准数据来自 Nvidia 官方基线与 Artificial Analysis 的服务商数据。图片转载用于编辑评论,所有权利归 Taalas Inc. 所有。
HC1 的每用户 17,000 token/秒大致相当于:
- 比 Nvidia H200 快约 74 倍
- 比 Groq LPU 快约 28 倍
- 比 Cerebras 快约 8.5 倍
这些都是每用户数字,衡量的是单个用户拿到回复的速度。系统总吞吐量(所有用户合计)则是另一回事,因为 GPU 系统可以并行服务大量用户。
微调这个维度
对做产品的人来说,对比到这里才开始有意思:
Nvidia:完整的微调支持
跑推理的那张 GPU,同样可以拿来微调模型。全参数微调、LoRA、QLoRA 都有成熟的软件库支持。这是灵活性最高的选项,同时也是自持成本最高的硬件。
Groq、Cerebras、SambaNova:没有内置微调
这些为推理优化的平台只负责运行模型,本身不做微调。你在别处(GPU,或者像 Ertas 这样的平台)完成微调,再把训练好的模型部署到这些系统上。
整模型部署走这条路没问题,但它撑不起让多租户部署真正高效的那套适配器切换流程。
Taalas:只有硬件级 LoRA
HC1 的位置很特别:基础模型固化在硅片里无法更换,而 LoRA 适配器可以加载和切换。这意味着:
- 你在别处(GPU、云平台)微调 LoRA 适配器
- 把适配器部署到 HC1 上做推理
- 在共享硬件上切换适配器,就能同时服务多个客户
- 跑到 17,000 token/秒的是你微调后的模型,而不只是基础模型
对于已经在 Llama 3.1 8B 上验证过用例、又想要极致推理吞吐的团队,这是最优路径。对于需要模型灵活性的团队,它太受限了。
哪种硬件适合哪种用例?
什么时候选 Nvidia GPU:
- 你需要最大的模型灵活性(在模型之间切换、运行不同架构)
- 你希望训练和推理在同一套硬件上完成
- 你要跑参数量超过 8B 的模型
- 你需要成熟的工具链和庞大的支持生态
- 你想要一套自己拥有的本地硬件
什么时候选 Groq:
- 你需要通过云 API 拿到快速推理
- 确定性延迟很重要(实时应用)
- 你跑的是已支持的模型架构
- 你不需要本地部署
- 你想要简单的 API 集成,不想管理硬件
什么时候选 Cerebras:
- 你需要超大模型推理(70B 以上)
- 速度重要,并且你愿意为托管服务付费
- 你手上是科研或企业级预算
- 你同时需要训练和推理能力
什么时候选 Taalas HC1:
- 你已经在 Llama 3.1 8B(或它之上的一个 LoRA 适配器)上验证过用例
- 你需要尽可能高的每用户吞吐量
- 每 token 成本是首要考虑
- 你能在单一基础模型的约束里把事做完
- 你希望在专用硬件上保留 LoRA 适配器的灵活性
什么时候选自托管消费级 GPU:
- 你要在中等吞吐量下拿到最划算的性价比
- 你跑的是 14B 参数以下的微调模型
- 隐私要求本地部署
- 你具备基本的基础设施能力
- 你想要完全掌控,且持续成本极低
更大的图景:推理硬件正在专业化
"什么都用 Nvidia GPU"的日子快要过去了。推理市场正在裂成一个个细分场景,每个场景都有为它专门打造的硬件:
- 通用型(Nvidia):用于研发、原型验证和多模型工作负载
- 速度优先的云服务(Groq、Cerebras):用于实时的、API 驱动的推理
- 领域专用硅(Taalas):用于特定模型上的高吞吐生产推理
这种专业化对任何在做微调模型的人都是好消息。它意味着更多的部署目标、更多把成本压下来的竞争,以及更多针对领域专用 AI 的工作负载特征做过优化的硬件选择。
所有这些硬件平台的共同点是什么?你需要一个微调好的模型。 无论部署在 Nvidia、Groq 还是 Taalas 上,让硬件真正有用的,都是那个用你自己领域数据训练出来的模型。
让你的模型准备好
硬件格局变化很快。新芯片、新架构、新定价模式每个季度都在出现。合理的策略是这样的:
-
现在就微调你的模型。 用 Ertas 这样的平台,在你的领域数据上训练一个 LoRA 适配器。不绑定硬件,也不需要 ML 专业背景。
-
导出成可移植的格式。 GGUF 用于 Ollama 和 llama.cpp,标准 LoRA 适配器格式则适用于任何支持它的平台。
-
部署在当下最合适的选项上。 先从自托管 GPU 或云 API 起步,哪个契合你现在的规模就用哪个。
-
硬件进步了就重新部署一次。 等 Taalas 正式发布,或者 Groq 的下一代芯片出货,你的模型已经就绪。搬动的是适配器,整条流水线不用动。
微调后的模型是长期资产,硬件是可以替换的基底。
性能数据来自 Taalas、Kaitchup 的分析、Nvidia 官方规格,以及 Artificial Analysis 的服务商基准。价格反映的是截至 2026 年 2 月的公开费率。