Crea con
modelos que posees.
Entrena modelos de IA personalizados. Despliégalos donde quieras.
Modelos entrenados para la tarea
Los pipelines de agentes repiten las mismas tareas definidas miles de veces al día. Dale a cada paso un modelo pequeño entrenado para esa tarea y obtendrás resultados de nivel frontera por una fracción del costo de ejecución.
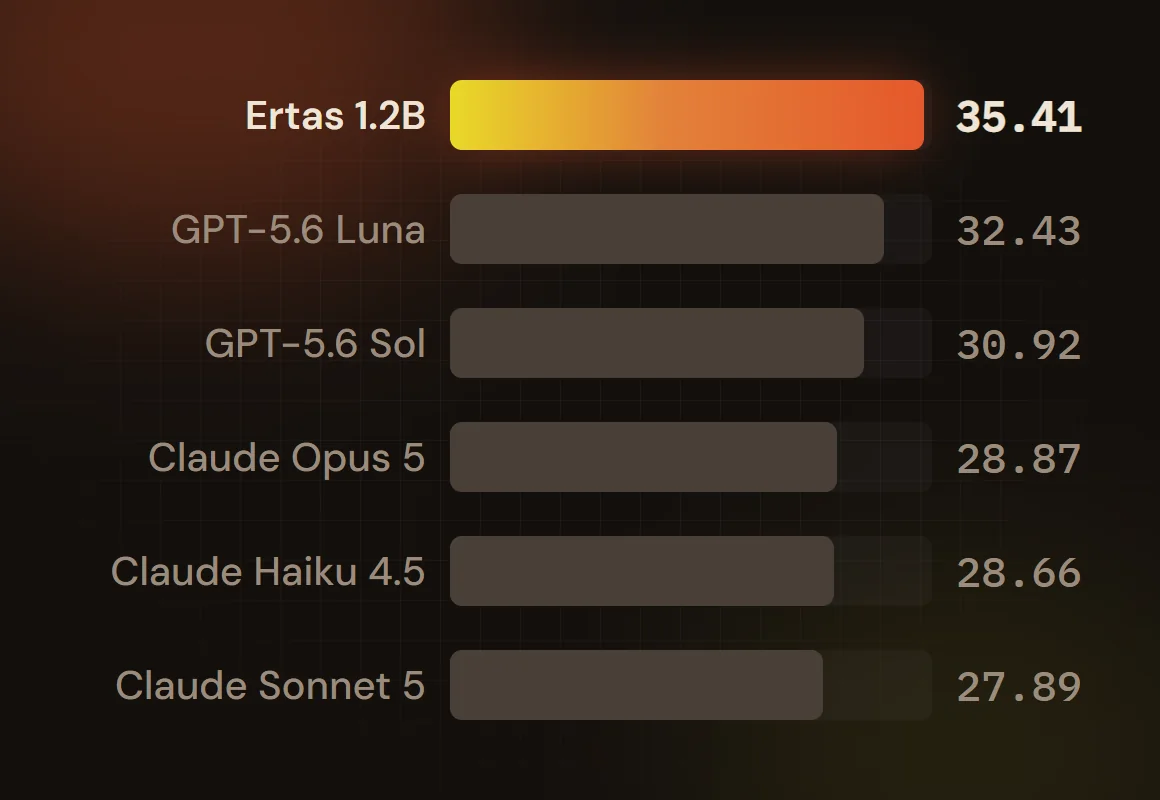
Leer el artículo (en inglés)35,41 vs 32,43
En un benchmark de resumen (QMSum), nuestro resumidor de 1,2B entrenado frente al mejor de cinco modelos propietarios alojados, entre ellos Claude Opus 5 y GPT-5.6, en ROUGE-1. Un modelo de 406M que entrenamos obtuvo 36,33. Ambos son más de 1.000 veces más pequeños que un modelo de frontera y se ejecutan en tu propio hardware, sin tarifas por token.
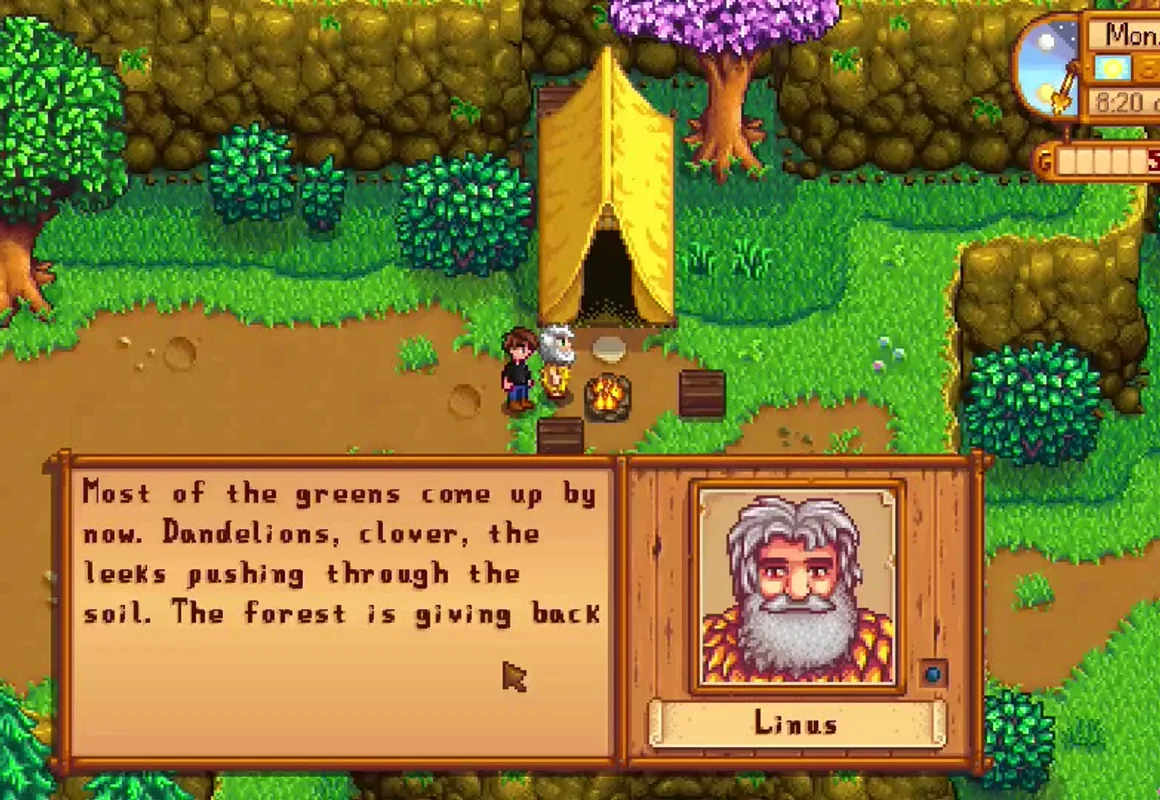
Chatty Valley le da a un aldeano de Stardew Valley conversación abierta sin salirse del personaje. Un modelo base pequeño se ejecuta en la propia computadora del jugador, y cada personaje es un adaptador ligero sobre él.
Leer la historia del desarrollo21 MB
contienen toda la personalidad de Linus, como adaptador sobre un modelo base compartido de 1,2B que se ejecuta en local.
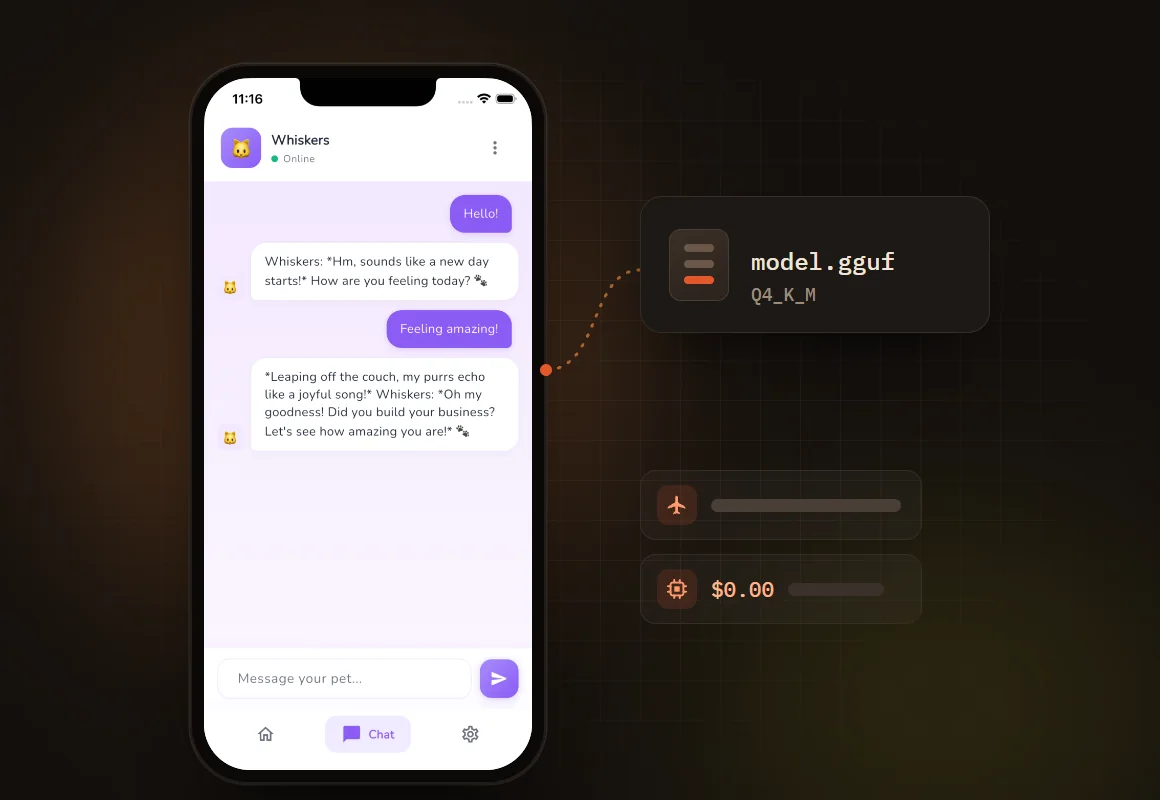
Integra un modelo entrenado para tu funcionalidad en tu app para iOS, Android o escritorio, que funciona sin conexión y mantiene los datos del usuario en el dispositivo. ¿Hoy usas un modelo de API genérico? El endpoint de modelo adaptativo puede servir tu modelo entrenado por ti.
Endpoint de modelo adaptativoVer los costos de la IA on-device$0
por inferencia, con el modelo ejecutándose en el dispositivo del usuario.
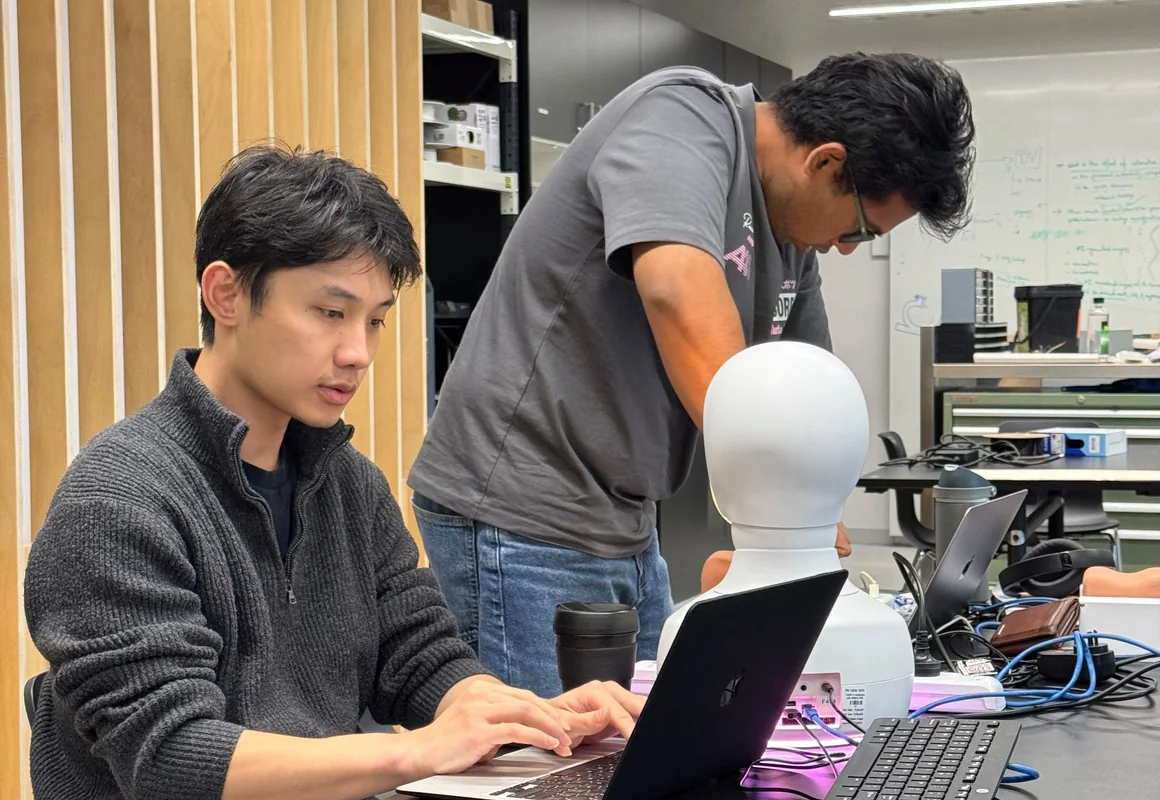
Un paciente con IA para la formación en fisioterapia. Los estudiantes exploran un simulador físico y hacen preguntas en voz alta, y un modelo pequeño entrenado en Ertas responde como el paciente, de forma coherente de una pregunta a la siguiente, en el propio hardware del simulador.
Sep. 2026
presentado en vivo en la Innovation Week de Melbourne Connect. Caso de estudio completo próximamente.
01 / 04
Agentes especialistas
Los pipelines de agentes repiten las mismas tareas definidas miles de veces al día. Dale a cada paso un modelo pequeño entrenado para esa tarea y obtendrás resultados de nivel frontera por una fracción del costo de ejecución.
35,41 vs 32,43
En un benchmark de resumen (QMSum), nuestro resumidor de 1,2B entrenado frente al mejor de cinco modelos propietarios alojados, entre ellos Claude Opus 5 y GPT-5.6, en ROUGE-1. Un modelo de 406M que entrenamos obtuvo 36,33. Ambos son más de 1.000 veces más pequeños que un modelo de frontera y se ejecutan en tu propio hardware, sin tarifas por token.
Leer el artículo (en inglés)Agentes especialistas
Los pipelines de agentes repiten las mismas tareas definidas miles de veces al día. Dale a cada paso un modelo pequeño entrenado para esa tarea y obtendrás resultados de nivel frontera por una fracción del costo de ejecución.
Leer el artículo (en inglés)35,41 vs 32,43
En un benchmark de resumen (QMSum), nuestro resumidor de 1,2B entrenado frente al mejor de cinco modelos propietarios alojados, entre ellos Claude Opus 5 y GPT-5.6, en ROUGE-1. Un modelo de 406M que entrenamos obtuvo 36,33. Ambos son más de 1.000 veces más pequeños que un modelo de frontera y se ejecutan en tu propio hardware, sin tarifas por token.
Desarrollo de videojuegos
Chatty Valley le da a un aldeano de Stardew Valley conversación abierta sin salirse del personaje. Un modelo base pequeño se ejecuta en la propia computadora del jugador, y cada personaje es un adaptador ligero sobre él.
Leer la historia del desarrollo21 MB
contienen toda la personalidad de Linus, como adaptador sobre un modelo base compartido de 1,2B que se ejecuta en local.
Desarrollo de apps
Integra un modelo entrenado para tu funcionalidad en tu app para iOS, Android o escritorio, que funciona sin conexión y mantiene los datos del usuario en el dispositivo. ¿Hoy usas un modelo de API genérico? El endpoint de modelo adaptativo puede servir tu modelo entrenado por ti.
Endpoint de modelo adaptativoVer los costos de la IA on-device$0
por inferencia, con el modelo ejecutándose en el dispositivo del usuario.
Formación profesional
Un paciente con IA para la formación en fisioterapia. Los estudiantes exploran un simulador físico y hacen preguntas en voz alta, y un modelo pequeño entrenado en Ertas responde como el paciente, de forma coherente de una pregunta a la siguiente, en el propio hardware del simulador.
Sep. 2026
presentado en vivo en la Innovation Week de Melbourne Connect. Caso de estudio completo próximamente.
Resultados de nivel frontera, en tus términos
99%
menos coste que Claude Opus 5
y un 96% menos que GPT-5.6 Luna
+18%
mejor tras el entrenamiento
ROUGE-1, el mismo modelo antes y después
23×
más rápido que Claude Opus 5
y 6× más rápido que GPT-5.6 Luna
Medido en nuestro estudio sobre un benchmark de resumen (QMSum). Lee el artículo
Una fracción del costo de ejecución.
Cuando el uso supera el punto de cruce, tener tu propio modelo cuesta menos que pagar por token.
- API de frontera
- Modelo personalizado en la nube
- Modelo personalizado on-device
- Tu ahorro
Ilustrativo. El punto de cruce depende de tu tarea y del alojamiento.
Control total.
Se ejecuta donde lo despliegues.
On-device, en tu cloud u on-premise.
Fijado a la versión que probaste.
Solo cambia cuando vuelves a entrenar.
Comportamiento definido por tus ejemplos.
El tono, el formato y los rechazos salen de tus datos.
Tus datos siguen siendo privados.
El modelo es tuyo para descargarlo.
Cómo funciona
Entrena tu modelo de IA. Visualmente.
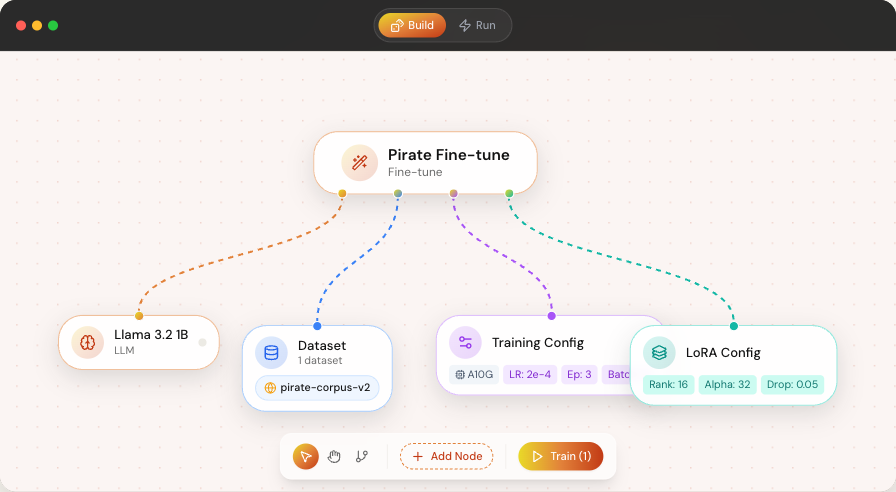
Sube tu dataset
Sube tu propio JSONL, o importa uno desde Hugging Face con una URL. ¿Aún no tienes dataset? Crea uno desde cero en Data Craft, nuestro constructor de datasets guiado.
Ajusta en Studio
Ajusta varios modelos en paralelo en GPUs cloud rápidas, sin necesidad de hardware costoso. El canvas visual es donde iteras: compara ejecuciones, ajusta tu receta y decide qué funciona para tu producto.
Despliega donde corre tu producto
Exporta tu modelo ajustado como GGUF y ejecútalo on-device o en local con llama.cpp, Ollama o LM Studio. Despliega en tu propio cloud gestionado hoy, con despliegue en un clic en Ertas próximamente.
Dentro de la plataforma
Todo lo que necesitas para ajustar y desplegar IA personalizada.
Model Studio
Ajusta modelos populares de código abierto en GPUs cloud rápidas. Soporta Gemma 4, Llama 3.2, Qwen 3.5 y más. Canvas visual, sin código.
Ver modelos compatibles →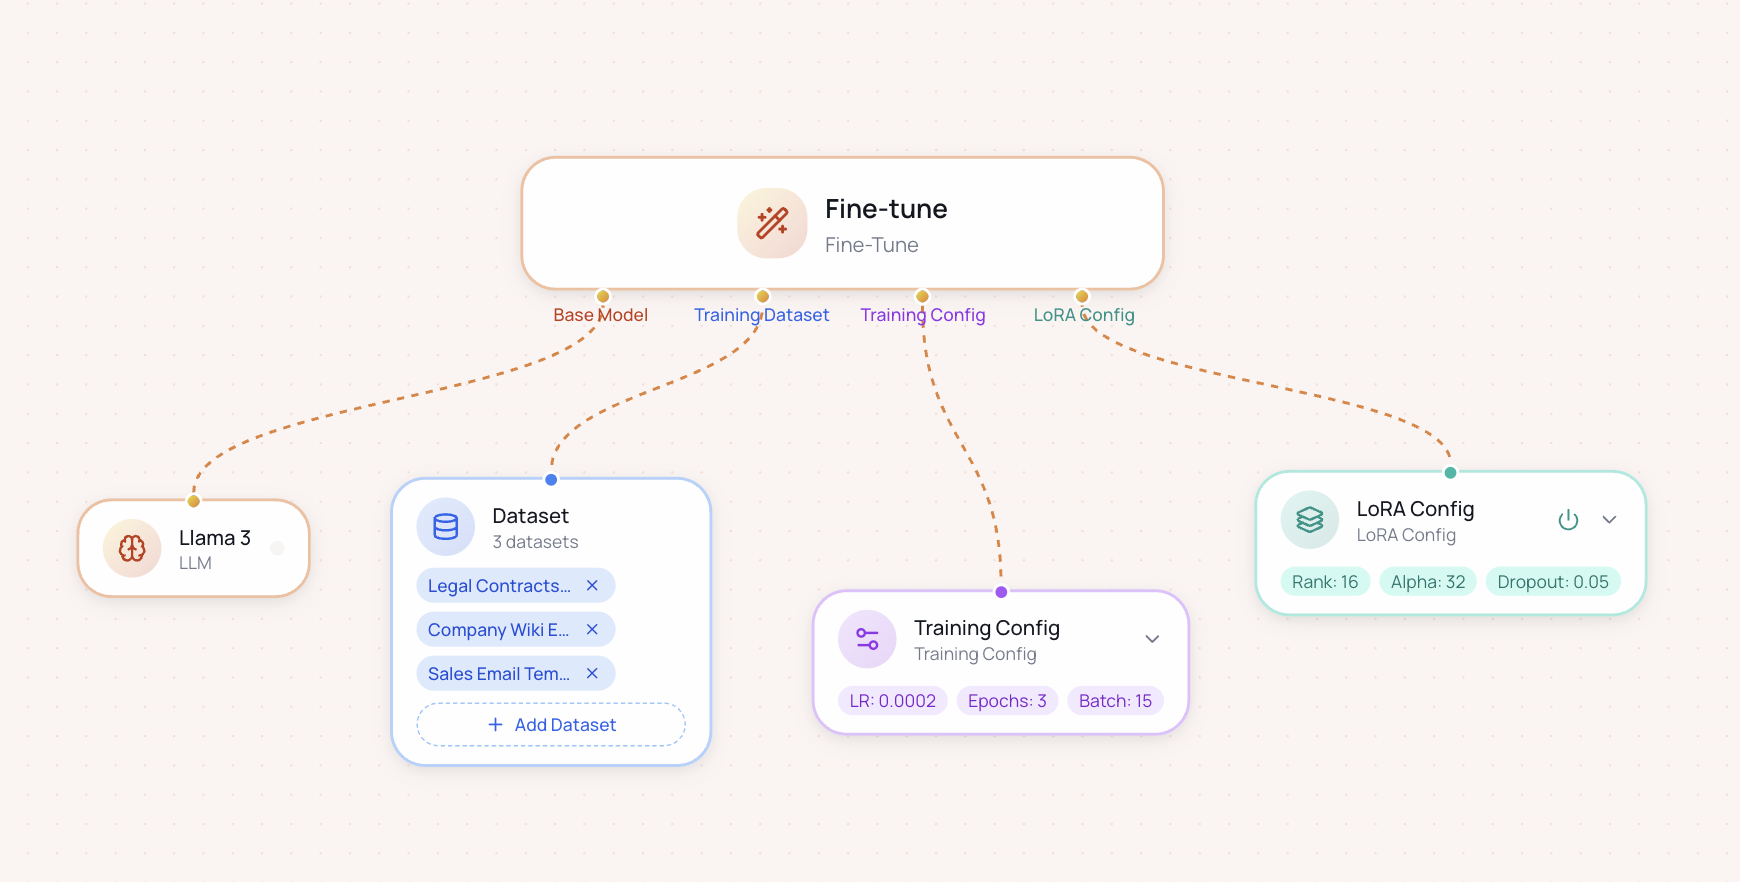
¿Por qué tener tu propio modelo?
- 01
Conoce tu dominio.
Entrenado con tus datos, para tu tarea.
- 02
Funciona donde lo necesitas.
En el dispositivo y sin conexión. Los datos del usuario se quedan en el dispositivo.
- 03
Sin equipo de ML.
Ertas se encarga del proceso de entrenamiento.
Diseñado para tu forma de trabajar
Empieza gratis. Escala a tu ritmo.
Free
Pruébalo, 30 créditos/mes
- 5 créditos/día renovados a diario (hasta 30/mes)
- Modelos de menos de 5B
- Trabajos y modelos más grandes requieren un plan de pago
- 5 GB para modelos
- 250 MB para datasets
- Sandbox de pruebas manuales
Lite
Para quienes ya superaron el plan Free
- 40 créditos/mes
- Modelos hasta 14B
- 25 GB para modelos
- 1 GB para datasets
- GPUs de gama superior
- Acumulación de créditos (1 mes)
- Exportación de modelo completo (safetensors)
Builder
Para devs indie y desarrolladores en solitario
- 100 créditos/mes
- Modelos hasta 14B
- 50 GB para modelos
- 2 GB para datasets
- GPUs de gama superior
- Acumulación de créditos (1 mes)
- Exportación de modelo completo (safetensors)
Pro
Para power users y equipos que gestionan proyectos de cliente
- 200 créditos/mes
- 100 GB para modelos
- 5 GB para datasets
- Cola prioritaria de GPU
- Acceso anticipado a nuevas funciones
- Exportación de modelo completo (safetensors)
Business
Para equipos escalados y agencias multi-cliente
- 400 créditos/mes
- 200 GB para modelos
- 10 GB para datasets
- Cola GPU de mayor prioridad
- Acceso anticipado prioritario a nuevas funciones
- Exportación de modelo completo (safetensors)
¿Necesitas cumplimiento normativo, on-prem o hardware de última generación? Hablemos de Enterprise
Preguntas frecuentes
Preguntas comunes sobre entrenar y lanzar modelos personalizados con Ertas.
No. Ertas se encarga del flujo de entrenamiento, la configuración de GPU, el empaquetado del modelo y la ruta de exportación. Tú sigues aportando el criterio de producto: la tarea, los datos y lo que significa «que funciona» para tu app.
No. El despliegue on-device es un caso de uso fuerte porque te da soporte offline, privacidad y cero costo de inferencia por token. También puedes entrenar modelos para inferencia en el servidor, despliegue en GPU gestionada, herramientas internas, bots de soporte, agentes y flujos de producto.
Obtienes un artefacto de modelo ajustado que puedes probar, exportar e integrar en tu app. Para despliegue local u on-device, Ertas soporta exportación a GGUF. Para equipos que quieren inferencia hospedada, Ertas puede servir el modelo por ti a través del endpoint de modelo adaptativo, y el despliegue con un clic desde Studio está en la hoja de ruta.
Ertas soporta modelos abiertos populares, incluyendo Gemma, Qwen, Llama, Mistral y Phi. Nos enfocamos en modelos que los builders pueden lanzar de verdad, desde modelos pequeños para uso local y on-device hasta modelos más grandes para despliegue en servidor o GPU. Algunas familias de modelos adicionales pueden funcionar de forma experimental, pero el soporte oficial empieza con los modelos listados arriba.
Ertas almacena tus datasets para que puedas reejecutar experimentos, comparar ejecuciones de entrenamiento y evitar volver a subir los mismos archivos. Tú mantienes el control de lo que subes y puedes eliminar los datasets que ya no necesites desde Data Craft. Los equipos con requisitos de datos más estrictos pueden hablar con nosotros sobre una configuración empresarial.
Model Studio es el producto principal hoy: sube datos, entrena modelos en GPUs cloud, prueba resultados y exporta modelos para tu app. Hub te permite gestionar tus modelos ajustados en un solo lugar, con descubrimiento público y compartición llegando a continuación. Los equipos que no quieren operar su propio hosting pueden hacer que Ertas sirva su modelo hoy a través del endpoint de modelo adaptativo, y el despliegue con un clic desde Studio está en la hoja de ruta.
Sí. El plan gratuito empieza de inmediato y no requiere tarjeta de crédito. Obtienes créditos mensuales para entrenar y probar modelos más pequeños. Los planes de pago añaden más créditos, soporte para modelos más grandes, más almacenamiento y mayor prioridad de acceso a las GPUs.
Empieza a construir hoy.Entrena tu primer modelo gratis.
Sin tarjeta de crédito.
¿Quieres un modelo construido y operado para tu empresa? Conoce el endpoint de modelo adaptativo