打造您所 擁有的模型。
訓練客製化 AI 模型,隨處部署。
為任務而訓練的模型
AI 代理管線每天都要把同樣的既定任務重複成千上萬次。為每個步驟配置一個專為該任務訓練的小模型,就能以一小部分的運行成本獲得前沿水準的結果。
閱讀論文(英文)35.41 vs 32.43
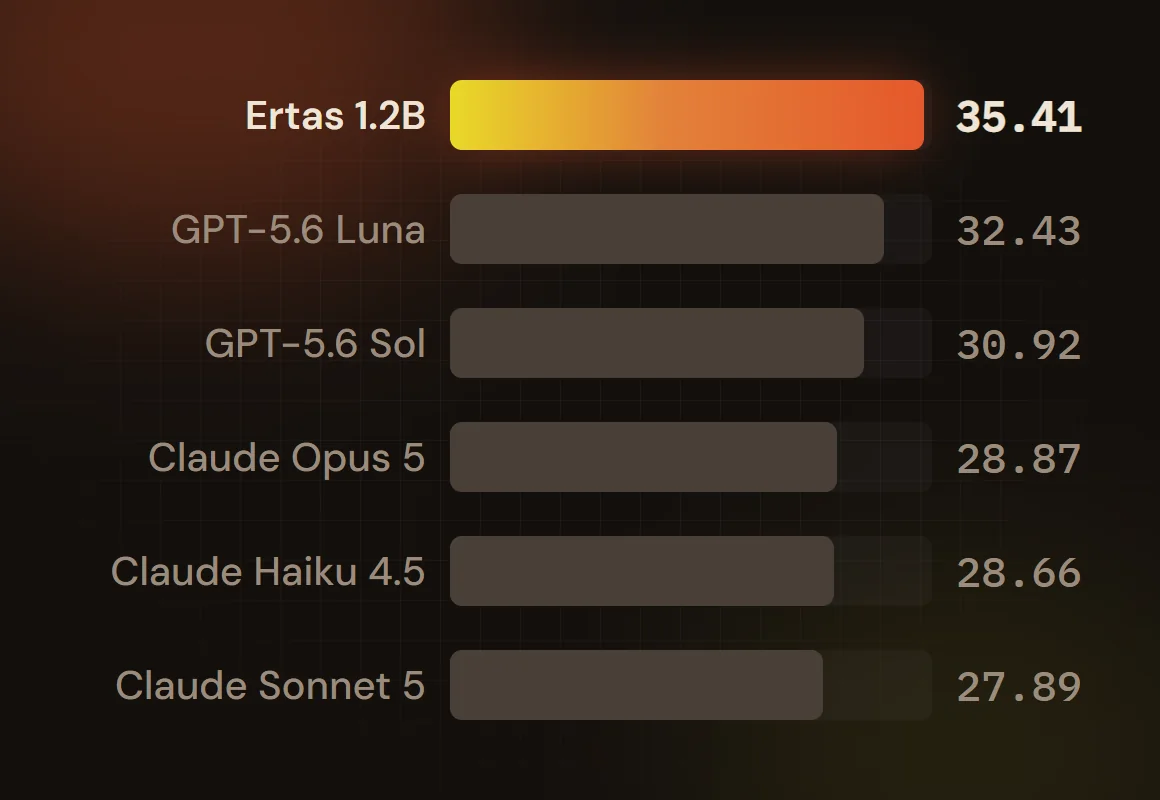
在一項摘要基準測試(QMSum)上,我們訓練的 1.2B 摘要模型對比五個託管專有模型中的最佳成績(ROUGE-1),其中包括 Claude Opus 5 與 GPT-5.6。我們訓練的一個 406M 模型得分 36.33。兩者都比前沿模型小 1,000 倍以上,可在您自己的硬體上執行,無需按 token 付費。
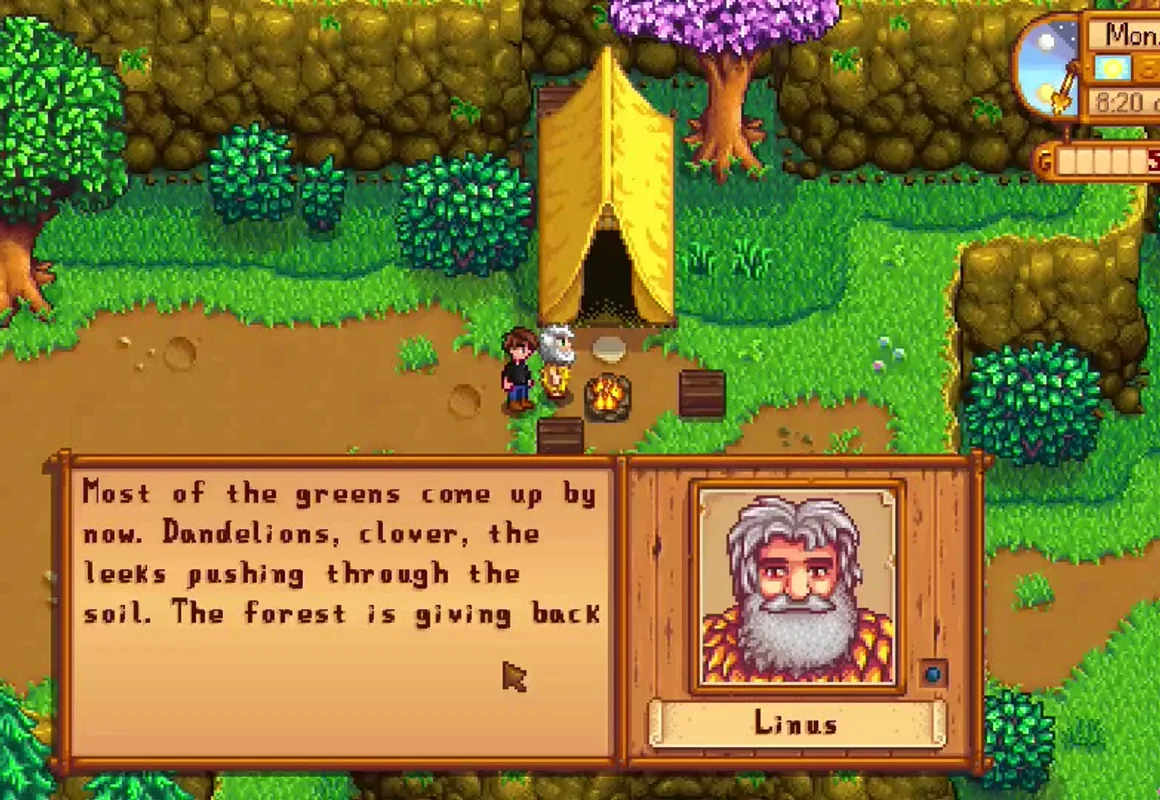
Chatty Valley 讓一位《星露谷物語》村民能自由對話,同時始終維持角色。一個小型基礎模型在玩家自己的電腦上運行,每個角色都是疊加在其上的輕量適配器。
閱讀開發故事21 MB
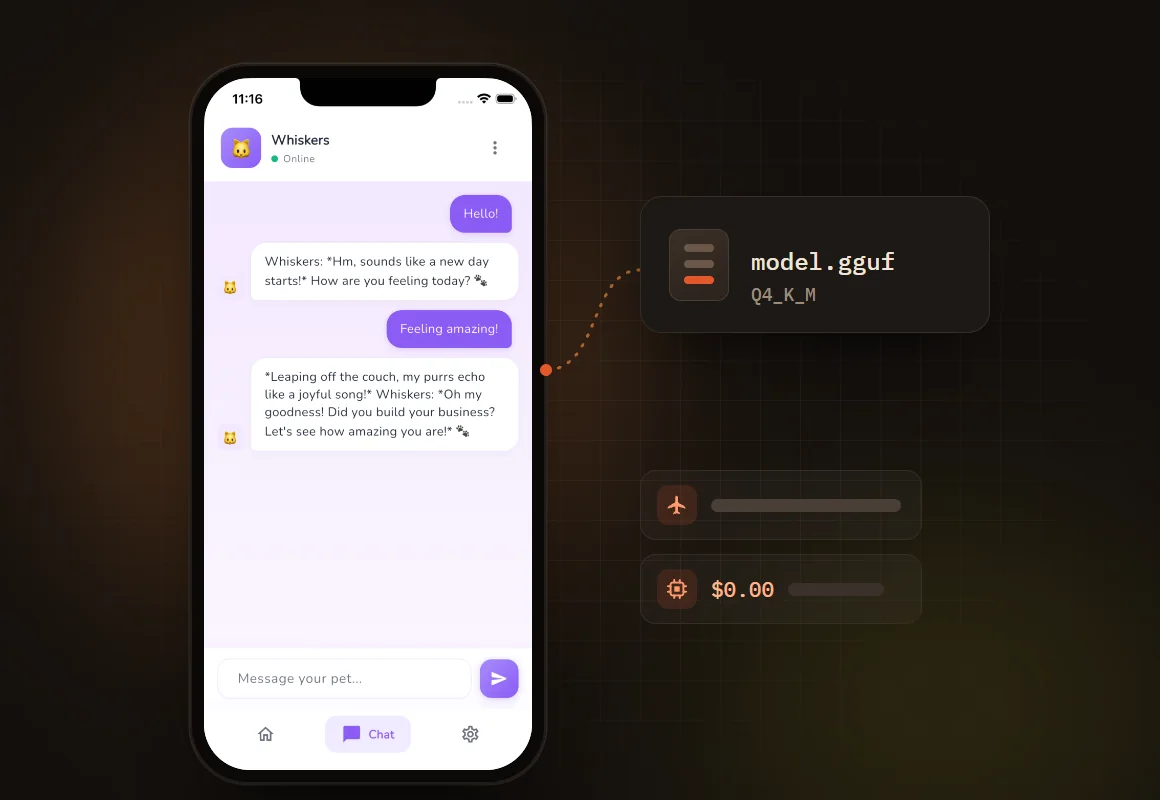
裝下了 Linus 的完整個性:一個疊加在共用 1.2B 基礎模型上的適配器,完全在本機運行。
把為您的功能訓練的模型整合到 iOS、Android 或桌面應用程式中,離線也能運行,使用者資料留在裝置上。目前使用現成的 API 模型?自適應模型端點可以替您運行訓練好的模型。
自適應模型端點查看端側 AI 的成本比較$0
每次推論的成本,模型在使用者的裝置上運行。
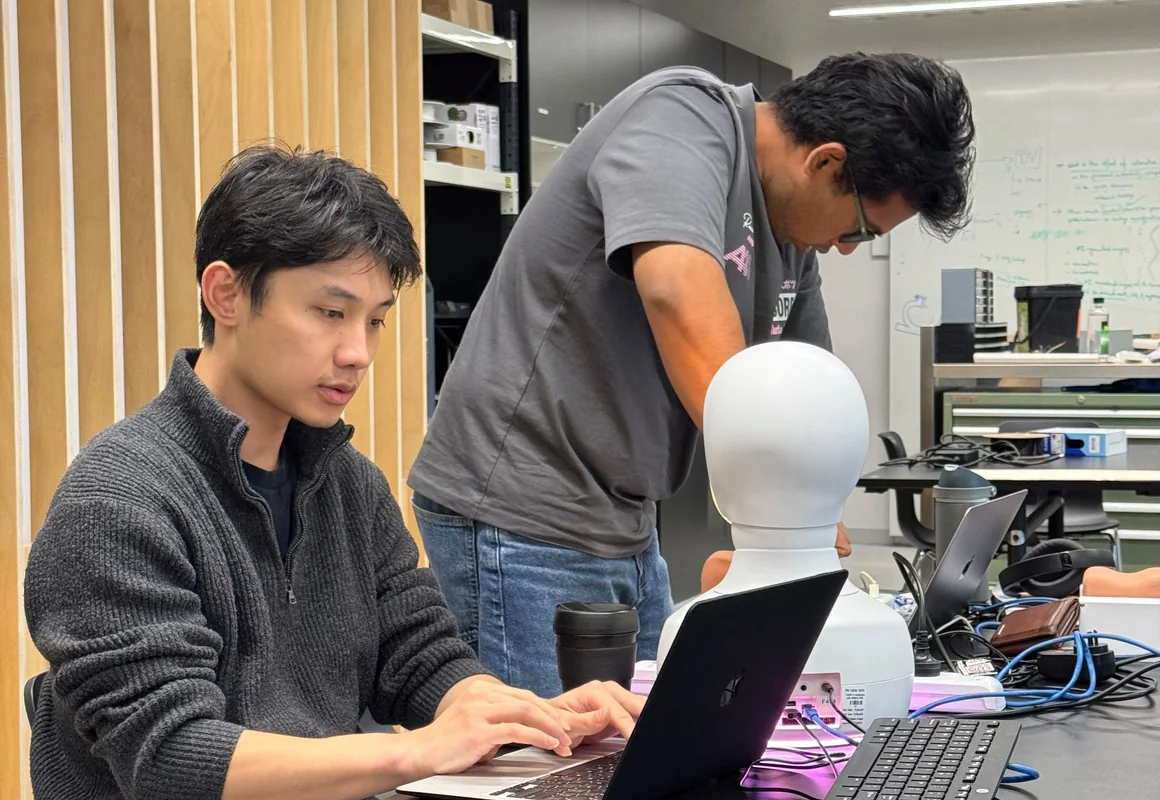
一位用於物理治療教學的 AI 病人。學生檢查實體模擬器並口頭提問,一個在 Ertas 上訓練的小模型以病人的身分回答,前後回答保持一致,並直接在模擬器本身的硬體上運行。
2026 年 9 月
於 Melbourne Connect 創新週現場展示。完整案例研究即將推出。
01 / 04
專用 AI 代理
AI 代理管線每天都要把同樣的既定任務重複成千上萬次。為每個步驟配置一個專為該任務訓練的小模型,就能以一小部分的運行成本獲得前沿水準的結果。
35.41 vs 32.43
在一項摘要基準測試(QMSum)上,我們訓練的 1.2B 摘要模型對比五個託管專有模型中的最佳成績(ROUGE-1),其中包括 Claude Opus 5 與 GPT-5.6。我們訓練的一個 406M 模型得分 36.33。兩者都比前沿模型小 1,000 倍以上,可在您自己的硬體上執行,無需按 token 付費。
閱讀論文(英文)專用 AI 代理
AI 代理管線每天都要把同樣的既定任務重複成千上萬次。為每個步驟配置一個專為該任務訓練的小模型,就能以一小部分的運行成本獲得前沿水準的結果。
閱讀論文(英文)35.41 vs 32.43
在一項摘要基準測試(QMSum)上,我們訓練的 1.2B 摘要模型對比五個託管專有模型中的最佳成績(ROUGE-1),其中包括 Claude Opus 5 與 GPT-5.6。我們訓練的一個 406M 模型得分 36.33。兩者都比前沿模型小 1,000 倍以上,可在您自己的硬體上執行,無需按 token 付費。
遊戲開發
Chatty Valley 讓一位《星露谷物語》村民能自由對話,同時始終維持角色。一個小型基礎模型在玩家自己的電腦上運行,每個角色都是疊加在其上的輕量適配器。
閱讀開發故事21 MB
裝下了 Linus 的完整個性:一個疊加在共用 1.2B 基礎模型上的適配器,完全在本機運行。
應用程式開發
把為您的功能訓練的模型整合到 iOS、Android 或桌面應用程式中,離線也能運行,使用者資料留在裝置上。目前使用現成的 API 模型?自適應模型端點可以替您運行訓練好的模型。
自適應模型端點查看端側 AI 的成本比較$0
每次推論的成本,模型在使用者的裝置上運行。
專業培訓
一位用於物理治療教學的 AI 病人。學生檢查實體模擬器並口頭提問,一個在 Ertas 上訓練的小模型以病人的身分回答,前後回答保持一致,並直接在模擬器本身的硬體上運行。
2026 年 9 月
於 Melbourne Connect 創新週現場展示。完整案例研究即將推出。
前沿水準的結果,由您掌控
99%
比 Claude Opus 5 成本更低
比 GPT-5.6 Luna 低 96%
+18%
訓練後效果提升
ROUGE-1,同一模型訓練前後對比
23×
比 Claude Opus 5 更快
比 GPT-5.6 Luna 快 6 倍
基於我們在摘要基準測試(QMSum)上的研究測得。 閱讀論文
只需一小部分的運行成本。
用量越過交點之後,擁有自己的模型比按 token 付費更划算。
- 前沿 API
- 雲端客製模型
- 端側客製模型
- 您節省的成本
示意圖。交點取決於您的任務與託管方式。
完全掌控。
部署在哪裡,就在哪裡運行。
端側、您自己的雲端或地端環境。
固定在您測試過的版本。
只有在重新訓練時才會改變。
行為由您的範例決定。
語氣、格式與拒絕方式都來自您的資料。
您的資料保持私密。
模型屬於您,可以下載。
運作方式
訓練您的 AI 模型。 視覺化操作。
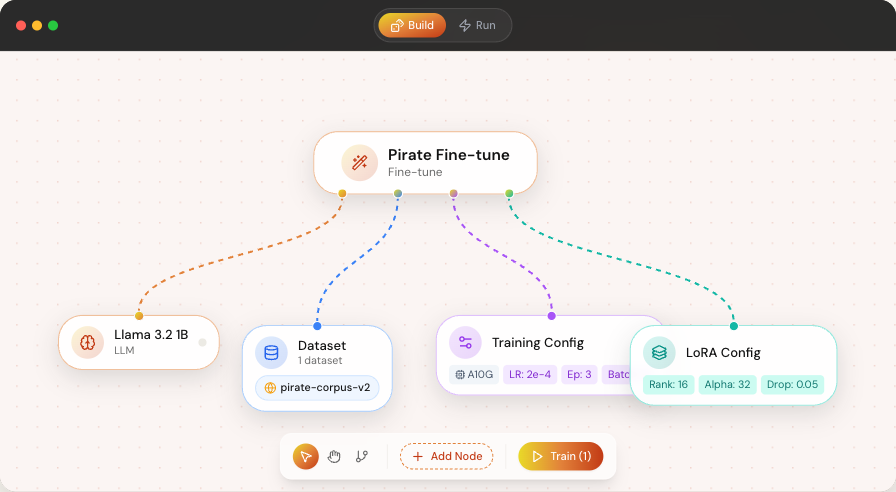
上傳您的資料集
上傳您自己的 JSONL,或使用 URL 從 Hugging Face 匯入。還沒有資料集?在我們的引導式資料集建構工具 Data Craft 中從零開始打造。
在 Studio 中微調
在高速雲端 GPU 上同時微調多個模型,無需昂貴的硬體。視覺化畫布是您迭代的地方:比較訓練運行、調整您的配方,並決定哪種方案最適合您的產品。
部署到您產品的運行環境
將微調模型匯出為 GGUF,透過 llama.cpp、Ollama 或 LM Studio 在端側或本機運行。今天即可部署到您自己的託管雲端,Ertas 上的一鍵部署即將推出。
平台一覽
微調和部署自訂 AI 所需的一切。
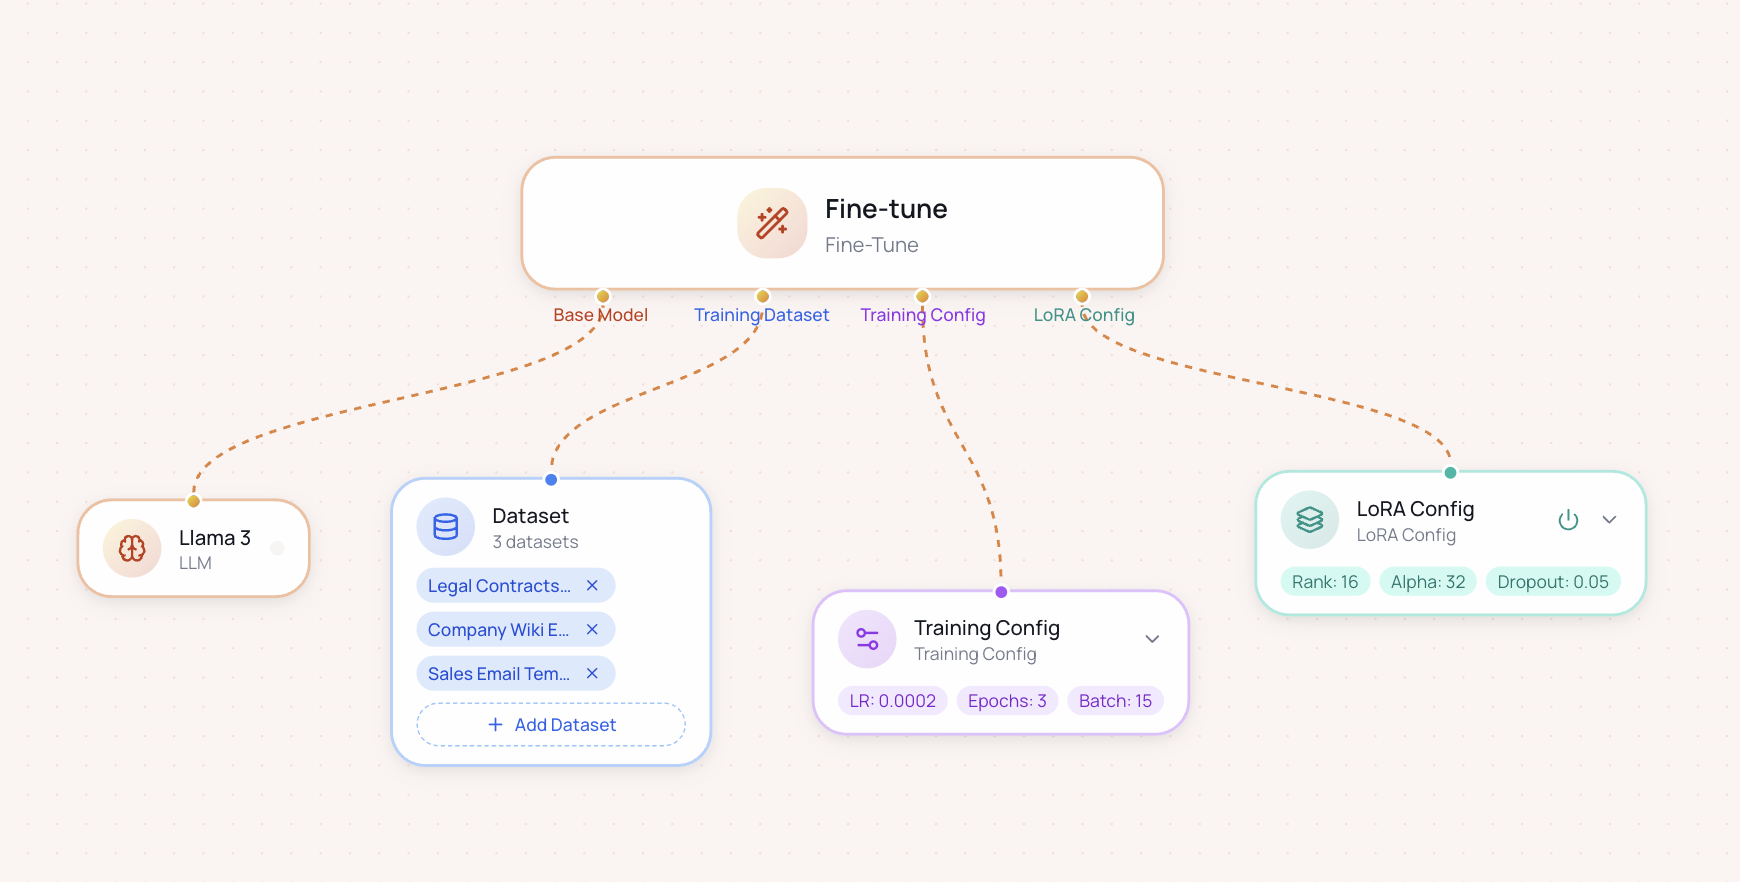
為什麼要擁有自己的模型?
- 01
懂您的領域。
用您的資料,為您的任務訓練。
- 02
在您需要的地方運行。
在裝置端離線運行,用戶資料留在裝置上。
- 03
無需機器學習團隊。
訓練流程由 Ertas 負責。
為您的工作方式而設計
免費起步,隨需擴充。
免費版
試用看看,每月 30 點數
- 每日更新 5 點數/日(每月最多 30)
- 5B 以下模型
- 更大的訓練任務與更大型模型需要付費方案
- 模型 5 GB
- 資料集 250 MB
- 手動測試沙盒
Lite
為已超出免費方案的開發者打造
- 每月 40 點數
- 模型最高 14B
- 模型 25 GB
- 資料集 1 GB
- 更高階 GPU
- 1 個月點數延展
- 完整模型匯出(safetensors)
Builder
為獨立開發者與個人打造
- 每月 100 點數
- 模型最高 14B
- 模型 50 GB
- 資料集 2 GB
- 更高階 GPU
- 1 個月點數延展
- 完整模型匯出(safetensors)
Pro
為進階使用者與管理客戶專案的團隊
- 每月 200 點數
- 模型 100 GB
- 資料集 5 GB
- 優先 GPU 佇列
- 新功能搶先體驗
- 完整模型匯出(safetensors)
Business
為規模化團隊與多客戶代理商打造
- 每月 400 點數
- 模型 200 GB
- 資料集 10 GB
- 更高優先級 GPU 佇列
- 新功能優先搶先體驗
- 完整模型匯出(safetensors)
常見問題
關於使用 Ertas 訓練並發佈客製化模型的常見問題。
不需要。Ertas 會處理訓練工作流程、GPU 設定、模型封裝和匯出路徑。您只需帶來產品判斷:任務、資料,以及對您的應用而言什麼才算「好」。
不是。端側部署是一個很強的應用案例,因為它能提供離線支援、隱私,以及零單次 Token 推論成本。您也可以訓練模型用於伺服器端推論、託管 GPU 部署、內部工具、客服機器人、代理和產品工作流程。
您會得到一個微調模型產物,可以測試、匯出並整合到您的應用中。對於本機或端側部署,Ertas 支援 GGUF 匯出。對於想要託管推論的團隊,Ertas 可以透過自適應模型端點為您提供模型服務,Studio 一鍵部署已在規劃路線圖上。
Ertas 支援熱門的開源模型,包括 Gemma、Qwen、Llama、Mistral 和 Phi。我們專注於開發者真正能發佈的模型,從用於本機和端側的小型模型,到用於伺服器端或 GPU 部署的大型模型。某些額外的模型系列可能可以實驗性運行,但官方支援以上述列出的模型為起點。
Ertas 會儲存您的資料集,讓您可以重新運行實驗、比較訓練運行,並避免重複上傳相同的檔案。您始終掌控上傳的內容,並可在 Data Craft 中刪除不再需要的資料集。有更嚴格資料要求的團隊,可以聯絡我們了解企業方案。
Model Studio 是目前的核心產品:上傳資料、在雲端 GPU 上訓練模型、測試結果,並為您的應用匯出模型。Hub 讓您在一個地方管理微調模型,公開發現和分享功能即將推出。不想自行運行託管的團隊,現在就可以透過自適應模型端點由 Ertas 提供模型服務,Studio 一鍵部署已在規劃路線圖上。
可以。免費方案立即開始,無需信用卡。您每月可獲得點數來訓練和測試較小的模型。付費方案則提供更多點數、更大型模型支援、更多儲存空間,以及更高優先級的 GPU 存取權。