

AI 代理成本最佳化,就是降低每一次成功的代理執行的成本。這筆成本的大宗是每一步都要重新傳送的上下文,所以最大的節省來自:裁剪工具輸出、清理舊的工具結果、快取靜態前綴、限制每次執行的步數,以及把例行步驟交給更便宜的模型。
AI 代理是 token 帳單成長最快的地方。2025 年 6 月,Anthropic 披露,在其資料中,代理通常比聊天互動多用約 4 倍的 token,多代理系統則多用約 15 倍。同一篇文章還發現,在 BrowseComp 評估中,光是 token 用量一項就解釋了 80% 的效能差異。token 能換來成果,所以要做的是找出那些什麼也沒換來的 token。
本指南從頭到尾追蹤一次代理執行:它的 token 去了哪裡,如何量測,以及依節省幅度排序的修正方法。模型層面的技術,請見 LLM 成本最佳化:12 種技術排名;管理視角,請見如何降低企業的 AI token 成本。
為什麼 AI 代理要用這麼多 token?
AI 代理在一個迴圈裡工作。每一步就是一次 API 呼叫:模型讀完目前為止的全部內容,然後要麼請求一個工具,要麼寫出答案。每次 API 呼叫都依模型的全部輸入計費,所以每一步都要為系統提示、工具定義、任務以及之前所有步驟的完整紀錄(包括每一個工具結果)再付一次錢。
因此,一次執行的輸入成長得比步數更快:
每次執行的輸入 token = n x (前綴 + 任務)
                     + (每步新增的 token) x n(n-1)/2

n    = 本次執行的 API 呼叫次數
前綴 = 系統提示 + 工具定義
第一項隨執行長度同步成長。第二項隨步數的平方成長,而且通常由工具結果主導,因為一次搜尋或資料庫查詢就可能回傳幾千個 token。
以一個示意性的客服代理為例:前綴 8,000 個 token(一個系統提示加 15 個工具定義),任務 500 個 token,共 12 次 API 呼叫。每一步寫出 300 個 token 的推理和工具參數,每個工具回傳 1,700 個 token。整個執行下來,代理傳送了 234,000 個輸入 token,寫出了 3,600 個。
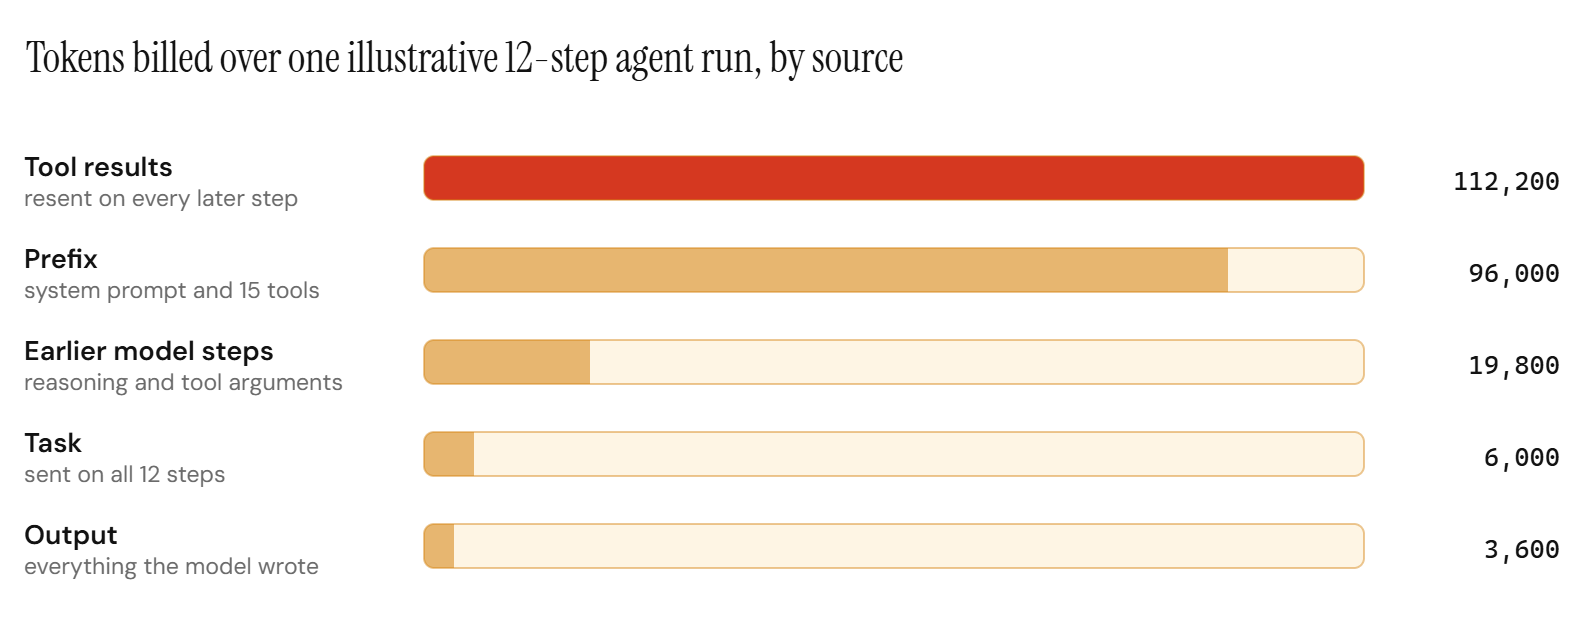
所以,壓低代理成本主要是在處理上下文。代理已經用過的工具結果是最大的一項,每一步都完全相同的前綴是第二大項。兩者修正起來都不貴,本指南後文會用同一次執行來說明能省多少。
執行長度和內容同樣重要。把這次執行加倍到 24 次 API 呼叫,輸入會增加到原來的三倍多,達到 756,000 個 token,這也是為什麼執行的長尾在代理帳單裡占比這麼大。
如何量測一次代理執行的成本?
在每次 API 呼叫時依執行 ID 記錄用量,再依執行彙總。一個小小的帳本就夠了:
from dataclasses import dataclass, field

# 每百萬 token 的美元價格,截至 2026 年 10 月 Claude Opus 5 的定價。
# cache_write 是 5 分鐘快取的費率;1 小時快取寫入為基本輸入價格的 2 倍。
PRICE = {"input": 5.00, "cache_write": 6.25, "cache_read": 0.50, "output": 25.00}

@dataclass
class RunLedger:
    run_id: str
    task_type: str
    steps: int = 0
    tokens: dict = field(default_factory=lambda: dict.fromkeys(PRICE, 0))

    def record(self, usage):
        # Anthropic 把快取 token 放在 input_tokens 旁邊的獨立欄位裡。
        self.steps += 1
        self.tokens["input"] += usage.input_tokens
        self.tokens["cache_write"] += usage.cache_creation_input_tokens or 0
        self.tokens["cache_read"] += usage.cache_read_input_tokens or 0
        self.tokens["output"] += usage.output_tokens

    @property
    def cost(self):
        return sum(self.tokens[k] * PRICE[k] for k in PRICE) / 1_000_000
把每個回應的用量物件傳給 record,包括重試,以及為這次執行工作的任何子代理。然後依代理和任務類型回報四個數字:
| 指標 | 它告訴您什麼 |
|---|---|
| 每次成功執行的成本 | 總花費除以達標的執行次數 |
| 執行成本中位數 | 一次正常執行的成本 |
| p95 的執行成本和步數 | 長尾有多長 |
| 成功率 | 某項節省是否犧牲了品質 |
import statistics

def cost_report(runs):
    """runs:同一代理、同一任務類型的 (ledger, succeeded) 配對清單。"""
    costs = sorted(ledger.cost for ledger, _ in runs)
    wins = sum(1 for _, ok in runs if ok)
    return {
        "cost_per_successful_run": sum(costs) / max(wins, 1),
        "median_run_cost": statistics.median(costs),
        "p95_run_cost": costs[int(0.95 * (len(costs) - 1))],
        "success_rate": wins / len(runs),
    }
用成功執行的次數當分母,同時把失敗執行的成本留在分子裡。一項改動把中位數降低了三分之一,卻讓更多執行陷入重試,每次成功執行的成本反而可能上升。迴圈、重試和迷失方向的執行都集中在 p95 一帶;又因為輸入隨步數的平方成長,長度為中位數兩倍的執行,成本可能達到約三倍。
要依任務的價值為這個數字設定目標,請見單一任務成本:衡量 AI 的單位經濟效益。
哪些修正最能降低 AI 代理的 token 用量?
大致依下面的順序來做。前五項只改變上下文和上限,對品質的風險很小。後兩項會改變由多少個代理、由哪個模型來做事,所以需要先有評估集。
| 修正 | 壓縮的部分 | 投入 | 品質風險 |
|---|---|---|---|
| 在工具端裁剪輸出 | 工具結果 token | 低 | 低 |
| 回傳結構化的工具結果 | 工具結果 token | 低 | 低 |
| 清理舊的工具結果 | 被重新傳送的歷史 | 低 | 中 |
| 快取靜態前綴 | 前綴的價格 | 低 | 無 |
| 限制每次執行的步數和花費 | 長尾 | 低 | 低,需搭配交接 |
| 收緊子代理的範圍 | 重複的上下文 | 中 | 中 |
| 為每一步選擇模型 | 每個 token 的價格 | 中 | 需要分步評估集 |
在工具端裁剪輸出
工具決定了什麼會進入上下文,而它回傳的一切都會在之後的每一步再計費一次。回傳完整客戶檔案的 CRM 查詢、回傳十個完整網頁的搜尋、回傳原始記錄行的記錄查詢,都是常見的元兇。
- 只回傳代理會用到的欄位。為每個工具定義一個檢視,不要直接序列化整列資料庫紀錄。
- 在工具內部限制列數和字元數,並說明裁掉了什麼:「顯示 1,240 列中的 20 列,如需更多請請求第 2 頁」。代理需要時可以再要。
- 在工具裡過濾冗長的輸出:失敗的測試和它的錯誤訊息、符合的記錄行、文件中相關的章節。
- 錯誤訊息保持簡短、可操作,因為堆疊追蹤同樣會被重新傳送。
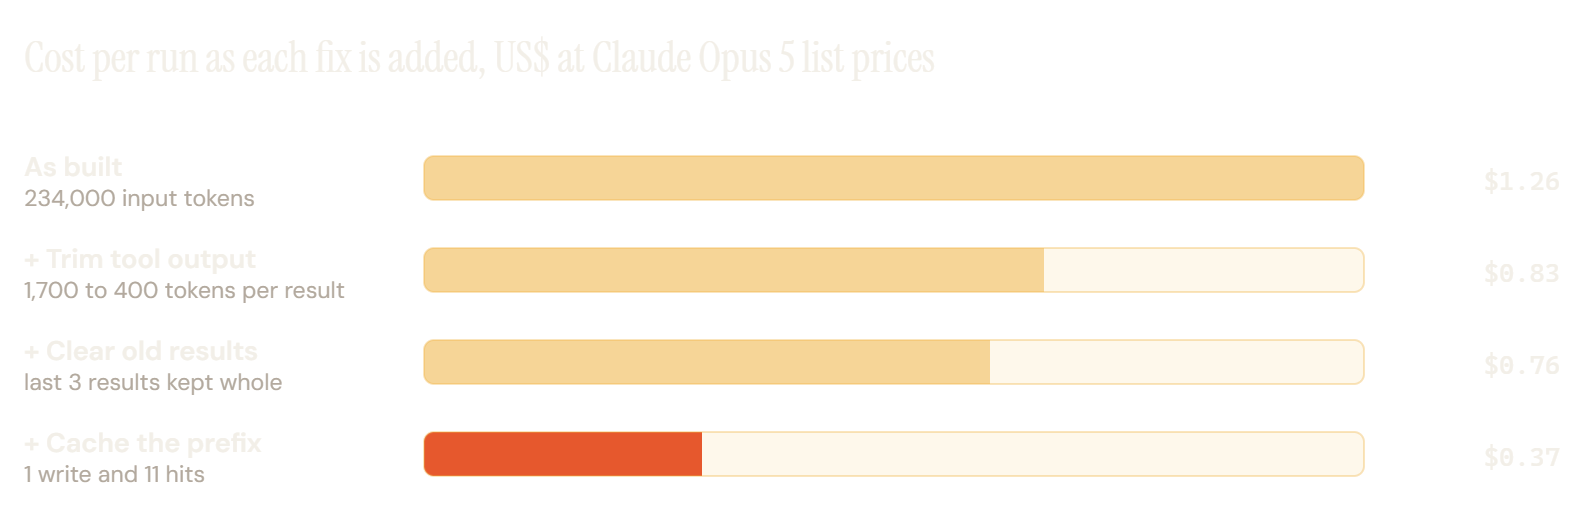
在範例執行中,把每個工具結果從 1,700 個 token 裁到 400 個,每次執行的輸入就從 234,000 降到 148,200 個 token。
回傳結構化的工具結果
只含必要欄位、鍵名簡短的 JSON 很精簡,模型讀起來也比自由文字更可靠。回傳 ID,讓代理只為它真正需要的少數紀錄請求詳細內容。保持鍵的順序穩定,因為 Anthropic 的提示快取文件提醒,在轉換為 JSON 時會打亂鍵順序的程式語言會破壞快取。
清理舊的工具結果
代理一旦根據某個結果採取了行動,就很少再需要它的全文。把較早的結果替換成一行佔位文字,或替換成代理從中得到的結論,只保留最近幾個結果的全文。
Anthropic 在伺服器端提供了這項功能。截至 2026 年 10 月,它的上下文編輯功能(測試版)包含一種工具結果清理策略:當輸入超過您設定的門檻(預設 100,000 個 token)時,用佔位文字替換較早的結果。它的壓縮功能(同為測試版)則用一段摘要替換較早的對話輪次。文件指出,清理工具結果會讓快取的提示前綴從清理處開始失效,所以要成批地大量清理,清掉的量要足以抵消重寫快取的成本。
在範例執行中,只保留最後三個結果的全文,輸入從 148,200 降到 133,800 個 token。這裡節省不多,是因為結果已經裁剪過了。在未裁剪的執行上,同一條規則單獨就能省下 61,200 個 token。
快取靜態前綴
AI 代理是提示快取的最佳情境,因為同一個前綴在每一步都會傳送,間隔只有幾秒或幾分鐘。Anthropic 的快取文件把快取的前綴描述為依序排列的工具、系統和訊息,所以工具定義和系統提示會一起快取在最前面。截至 2026 年 10 月,Anthropic 在大多數 Claude 模型上依輸入價格的十分之一收取快取命中費用,5 分鐘快取的寫入依 1.25 倍收費。
在 AI 代理中保持高命中率有三條規則:
- 在整個執行期間固定工具定義,並保持固定順序。同一份文件寫明,修改工具定義會讓整個快取失效,所以要一開始就載入全部工具,避免在執行中途新增工具。
- 時間戳記、使用者名稱和執行 ID 不要放進系統提示,放到第一則使用者訊息裡。
- 在每一步記錄快取讀取和寫入欄位,因為一次悄無聲息的未命中只會表現為更高的帳單。
在範例執行中,快取這 8,000 個 token 的前綴,會把依全價計費的 96,000 個 token 變成一次寫入加 11 次命中,成本相當於 18,800 個 token。
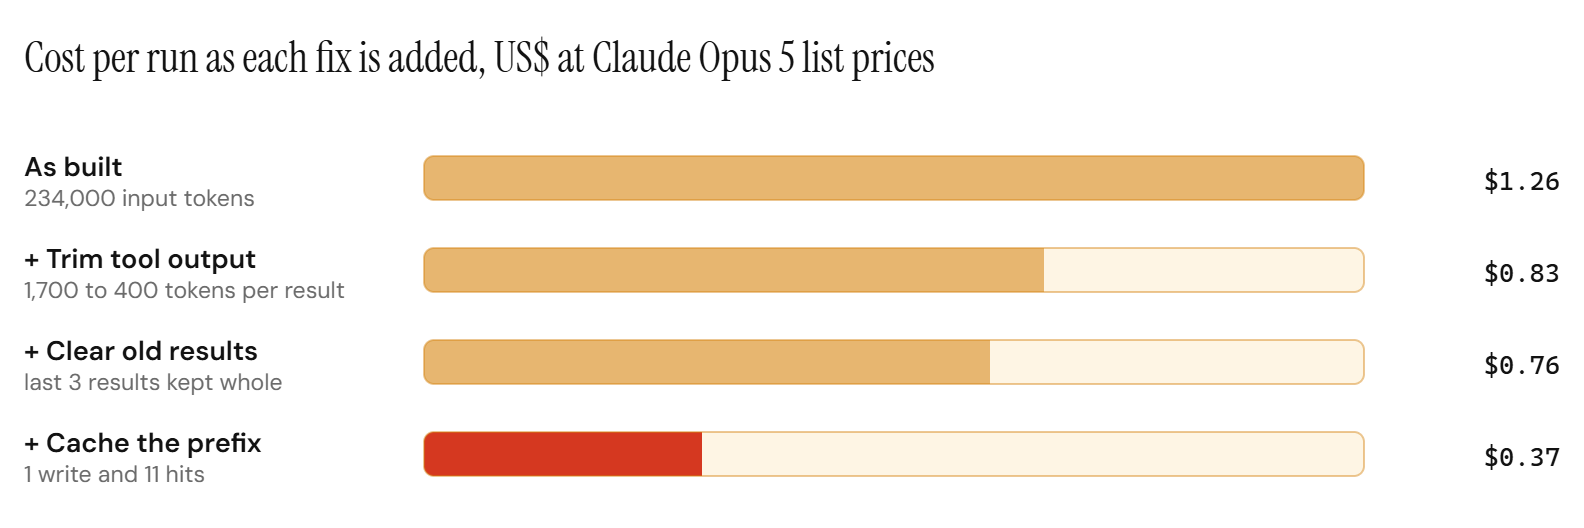
限制每次執行的步數和花費,並乾淨地交接
長執行的成本比它的長度看起來更高,所以長尾需要一個硬性的停止點。在每次 API 呼叫之前檢查上限:
class BudgetExceeded(Exception):
    pass

def check_budget(ledger, max_steps=20, max_cost_usd=2.00):
    if ledger.steps >= max_steps or ledger.cost >= max_cost_usd:
        raise BudgetExceeded(
            f"run {ledger.run_id}: {ledger.steps} steps, ${ledger.cost:.2f}"
        )
根據資料設定上限。從成功執行的 p95 附近起步,再留一些餘裕,並在代理每次改動時重新檢視。當一次執行觸及上限,要乾淨地結束它:儲存一段簡短的狀態摘要,把任務交給人工或更簡單的路徑,並在帳本裡把這次執行記為失敗。我們關於 AI 代理中的人工介入的指南介紹了交接設計。
再加一道迴圈檢查。一個連續兩次用相同參數請求同一個工具的代理,通常已經卡住了,在這裡停下比等著步數上限來攔截更省錢。
Anthropic 的任務預算功能截至 2026 年 10 月仍是測試版,它會告訴 Claude 整個代理迴圈有多少 token 可用,讓模型自己掌握節奏。文件把這個預算描述為建議性的,所以硬性上限要放在您自己的迴圈裡,預算只用來調節節奏。
收緊子代理的範圍
子代理從全新的上下文開始:它自己的前綴、自己的任務說明和自己的歷史。把任務分派出去,會把前綴和歷史乘以子代理的數量,主代理隨後還要為讀取回傳的內容付費。Anthropic 的研究系統就是參照案例:它的多代理執行用掉的 token 約為一次聊天的 15 倍,Anthropic 也寫道,多代理系統需要的是價值夠高、付得起效能提升的任務。
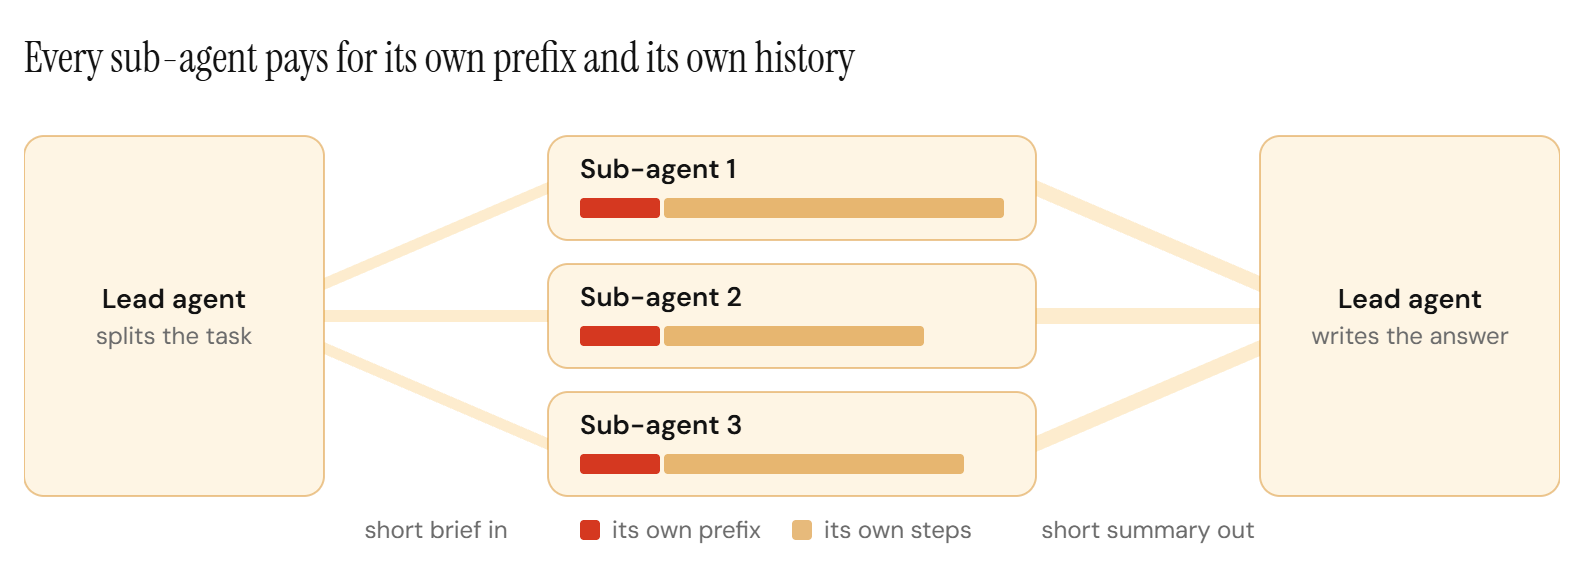
- 只在真正能平行進行的大範圍工作上使用子代理,例如調查幾個彼此獨立的來源。依序進行的工作放在單一代理裡更便宜。
- 每個子代理只配它的工作需要的工具,因為工具集越小,它每一步的前綴就越小。
- 讓子代理回傳精簡後的結果。大的輸出寫入儲存空間,只傳一個參照,這樣主代理的上下文能保持精簡。
- 限制每次執行的子代理數量,並讓每個子代理都接受同樣的步數和花費檢查。
為每一步選擇模型
大多數 AI 代理在每一步都用同一個模型,儘管各步並不相同。規劃思路和寫出最終答案,需要您負擔得起的最強模型。中間的許多步驟都是例行操作:選下一個工具、從結果中擷取欄位、為文件分類、判斷某項檢查是否通過。
這些例行步驟正是便宜等級划算的地方。截至 2026 年 10 月,Claude Haiku 4.5 每個 token 的價格是 Claude Opus 5 的五分之一,每百萬輸入和輸出 token 分別為 1 美元和 5 美元,對比 5 美元和 25 美元;GPT-6 Luna 的價格則是 GPT-6 Astra 的百分之一。在步驟層面測試:為每一步標上步驟類型並記錄下來,把每種類型抽樣拿到更便宜的等級上重播,只遷移能通過的步驟類型。拆分之後,依模型分別量測快取命中率。我們的 LLM 路由策略指南介紹了如何安全地遷移這部分流量。
客製化模型在 AI 代理中處於什麼位置?
生產環境中的 AI 代理每天會把同樣幾種步驟類型重複成千上萬次。它為請求分類、擷取欄位、決定下一步行動、分派案件。每一種都是一項範圍窄、輸出可檢查、流量穩定的任務,而這正是為該任務訓練的模型能以前沿模型價格的一小部分提供服務的情形。
延遲在 AI 代理中同樣會累積。每一步都要等模型回答,所以把某類步驟縮短幾秒,這類步驟在一次執行中出現幾次,整次執行就縮短幾次。
這正是自適應模型端點要做的事。自適應模型端點是為您的某一項任務提供的單一 API 端點:起初由前沿模型回答,用您的請求和團隊回饋訓練出的客製化模型在通過您的評估集後接手,困難的案例繼續留在前沿模型上。在 AI 代理中,每一種例行步驟類型都有自己的端點。
規劃和最終答案可以始終留在前沿模型上,代理保留了判斷力,而重複的步驟變得更便宜。
對代理的程式碼來說,改動只是那一步 API 呼叫裡的一個模型名稱。客製化模型的每個新版本都會在背景用真實請求執行,並依您的評估集評分,沒有您的核准,什麼都不會切換。我們會監控模型,並隨著您的任務變化重新訓練。模型可以由 Ertas 代管執行,也可以部署在您的雲端或地端,並且歸您所有。該端點目前僅限受邀企業使用,我們正在開發一個更精簡的版本,讓更多企業可以接入。
在我們的 QMSum 研究中,一個為查詢式會議摘要訓練的 1.2B 模型,估算的服務成本為每次查詢 0.00053 美元;依同步呼叫定價,Claude Opus 5 為 0.104 美元,GPT-5.6 Luna 為 0.0130 美元。它 0.39 秒給出回答,而 Claude Opus 5 需要 9.0 秒。這個估算不含訓練成本,而且每項任務都不一樣,所以每一次切換都要以您自己的評估集為準。某項具體任務的損益平衡計算,請見客製化模型何時在成本上勝過前沿 API。
這些修正應該依什麼順序來做?
- 先做好量測:每次執行的帳本、每次成功執行的成本、中位數和 p95。
- 裁剪並結構化工具輸出,它通常是一次執行中最大的一項。
- 快取靜態前綴,並修好提示中任何會破壞快取的地方。
- 加上步數、花費和迴圈上限,每一項都以交接結束。
- 在長執行中清理或壓縮舊的工具結果。
- 收緊子代理的範圍,把例行步驟類型交給能通過分步評估集的更便宜等級。
- 為呼叫量最大的步驟類型配一個專屬模型。
每做一項改動就重新跑一遍帳本,把每次成功執行的成本和成功率放在一起看。一項會降低成功率的節省,通常花掉的比省下的還多。
常見問題
AI 代理比聊天多用多少 token?
根據 Anthropic 在 2025 年 6 月公布的資料,代理通常比聊天互動多用約 4 倍的 token,多代理系統多用約 15 倍。這個倍數來自迴圈:每一步都會重新傳送前綴和之前所有步驟的完整歷史。
什麼最推高 AI 代理的 token 成本?
被重新傳送的上下文。工具結果和靜態前綴在每一步都會再計費一次,所以輸入 token 通常占代理帳單的大部分。在本指南的示意執行中,依截至 2026 年 10 月 Claude Opus 5 的定價,輸入占成本的 93%。
提示快取對 AI 代理有用嗎?
AI 代理正是它的最佳情境,因為同樣的系統提示和工具定義會在幾分鐘內的每一步被重新傳送。保持工具定義固定且順序不變,把可變資料放在系統提示之外,並且要預期清理舊的工具結果會讓從該處開始的快取歷史失效。
如何防止 AI 代理跑出一大筆帳單?
在每次 API 呼叫之前檢查步數上限和花費上限,停掉重複請求同一工具的執行,並讓每一次被停止的執行都以交接給人工或更簡單路徑的方式結束。根據成功執行的 p95 設定上限,並在代理改動時重新檢視。
AI 代理的每一步都應該用同一個模型嗎?
規劃和最終答案通常需要最強的模型,而擷取、分類這類例行步驟往往在更便宜的等級上就能通過。用各自的評估集測試每種步驟類型,只遷移能通過的類型。
什麼時候在 AI 代理中使用客製化模型才合理?
當某一種步驟類型每天執行成千上萬次、它的輸出可以自動檢查,而且任務每週保持穩定的時候。這些步驟可以遷移到為它們訓練的模型上,放在自適應模型端點之後,同時由前沿模型繼續處理困難的案例。
簡短版
AI 代理的成本主要是每一步都被重新傳送的上下文。用中位數和 p95 量測每次成功執行的成本,裁剪並結構化工具輸出,快取靜態前綴,清理舊結果,為每次執行設上限並乾淨地交接,同時收緊子代理的範圍。然後把您的代理重複最多的例行步驟類型交給更便宜的模型,先從為最繁忙的那一類訓練的模型開始。
如果某個代理步驟佔據了您帳單的大宗,預約通話,我們和您一起看看。
資料來源:Anthropic, How we built our multi-agent research system、Anthropic 上下文編輯、Anthropic 壓縮、Anthropic 任務預算、Anthropic 提示快取、Anthropic 定價和 OpenAI API 定價。價格和功能核實於 2026 年 10 月 6 日。