


當某一項任務的每月呼叫量足以涵蓋客製化模型的固定成本時,客製化模型就比前沿 API 更省錢。固定成本包括持續運作的 GPU,評估、監控和重新訓練的工作,以及攤提下來的建置成本。損益兩平點等於這些固定成本除以每次 API 呼叫省下的錢,而前沿一側要按您實際支付的費率計算。
本指南寫給正在做這道比較題的工程主管和架構師。文中提供兩邊各自的公式、一個所有數字都攤在檯面上的試算範例、團隊常遺漏的成本,以及一條在流量遷移期間守住品質的遷移路徑。價格均為 OpenAI 和 Anthropic 截至 2026 年 10 月的定價。請先套用 LLM 成本最佳化:12 種技術排名裡的設定類技術,因為它們會改變您用來比較的前沿價格。
如何計算前沿 API 每月的成本?
用每月的 API 呼叫次數乘以單次 API 呼叫的成本,而單次成本要按您用上快取、批次處理,並換到能通過評估集的最便宜規格之後,實際會支付的費率來算。拿做原型時那個模型的定價去比,會高估前沿一側,讓任何客製化模型都顯得比實際更便宜。
前沿每月成本 = 每月 API 呼叫次數 x 單次 API 呼叫成本

單次 API 呼叫成本 = 未快取的輸入 token x 輸入價格
                  + 已快取的輸入 token x 快取價格
                  + 輸出 token         x 輸出價格   (推理 token 計入輸出)
比較之前,先調整價格。下表每一項都會改變前沿一側,其中大多數會把它往下拉。
| 調整 | 對前沿價格的影響 | 適用情況 |
|---|---|---|
| 能通過評估的最便宜規格 | 每個輸出 token 最多便宜 100 倍 | 更便宜的規格通過了評估集 |
| 提示快取 | 快取輸入按輸入價格的十分之一計費 | 提示有一段較長且穩定的前綴 |
| 批次處理 | 輸入和輸出都便宜 50% | 可以等待結果的工作 |
| 推理強度 | 計費的推理 token 更少 | 較低的設定仍能通過評估 |
| 重試和升級 | 拉高實際價格 | 所有正式環境的工作負載 |
截至 2026 年 10 月,Anthropic 對大多數 Claude 模型的快取命中按基礎輸入價格的十分之一計費,OpenAI 對 GPT-6 Astra 和 GPT-6 Luna 的快取輸入按標準輸入的十分之一定價,兩家的批次處理都按標準費率的 50% 收費。重試的作用方向相反:一項任務如果有 5% 的 API 呼叫要重試,每項任務就要多付 5%。
試算範例:前沿一側
以一項理賠分流任務為例:每次 API 呼叫有 2,000 個輸入 token 和 200 個輸出 token,其中 1,500 個輸入 token 是一段穩定的指令前綴,可以快取。它以同步方式執行在 Claude Sonnet 5.5 上,截至 2026 年 10 月的定價為每百萬輸入 token 2 美元、每百萬輸出 token 10 美元,快取命中為每百萬 0.20 美元。
| API 呼叫的組成 | Token 數 | 每百萬價格 | 成本 |
|---|---|---|---|
| 未快取輸入 | 500 | 2.00 美元 | 0.0010 美元 |
| 已快取輸入 | 1,500 | 0.20 美元 | 0.0003 美元 |
| 輸出 | 200 | 10.00 美元 | 0.0020 美元 |
| 單次 API 呼叫合計 | 2,200 | 0.0033 美元 |
流量穩定時前綴會一直留在快取裡,所以快取寫入的費用很少,這裡不計入。不用快取的話,同一次 API 呼叫要 0.0060 美元。請記住這個差距,因為下面算損益兩平點時,如果拿 0.0060 美元去比,得出的呼叫量大約只有真實值的一半。
執行自己的客製化模型要花多少錢?
客製化模型的成本包括:為它一直開著的 GPU,不論忙碌或閒置;讓它保持好用的持續性工作;再加上按使用年限攤提的建置成本。那些仍然升級到前沿模型的請求,也要記在這一側的帳上。
客製化模型每月成本 = GPU 小時 x GPU 價格                (服務)
                  + 工程時間 x 完整人事成本              (評估、監控、重新訓練、待命)
                  + 重新訓練和評估的運算資源
                  + 建置成本 / 使用年限月數
                  + 升級的 API 呼叫次數 x 前沿價格
服務。 截至 2026 年 10 月,依 RunPod、Lambda 和 CoreWeave 的隨需牌價,H100 約為每 GPU 小時 2.90 至 6.20 美元,L40S 約為 1.10 至 2.25 美元。承諾用量會改變費率,也會把您綁定在這些時數上,所以請按您的供應商提供的報價來算。
營運工作。 在正式環境運作一個模型是持續性的工作:隨著輸入變化更新評估集,為每個候選版本評分,監控品質和延遲,在任務漂移時重新訓練,並且全天候為這個端點負責。請把它按一名工程師時間的一部分、以完整人事成本來計算。漏掉這一項,等於拿一項代管服務(前沿 API)去和替代方案裡只佔一半的硬體部分作比較。
建置。 資料蒐集與清理、訓練執行、第一套評估集以及服務環境的建置。把它攤提到您預計模型在重建之前會持續服役的月數上。
為什麼 GPU 使用率是隱藏變數?
GPU 按小時計費,無論服務一個請求還是一百萬個,所以單一請求的服務成本等於每小時價格除以這一小時實際承載的請求數。使用率,也就是您的流量填滿了多少運算能力,對這個數字的影響比 GPU 價格更大。
假設壓力測試顯示,一張 GPU 在這項任務上滿載時每秒能處理 10 個請求,也就是每小時 36,000 個。按每 GPU 小時 4.00 美元計算,滿載的 GPU 服務一個請求約需 0.00011 美元。同一張 GPU 只有 5% 的時間在忙時,每個請求要 0.0022 美元,相當於含快取的前沿價格的三分之二。
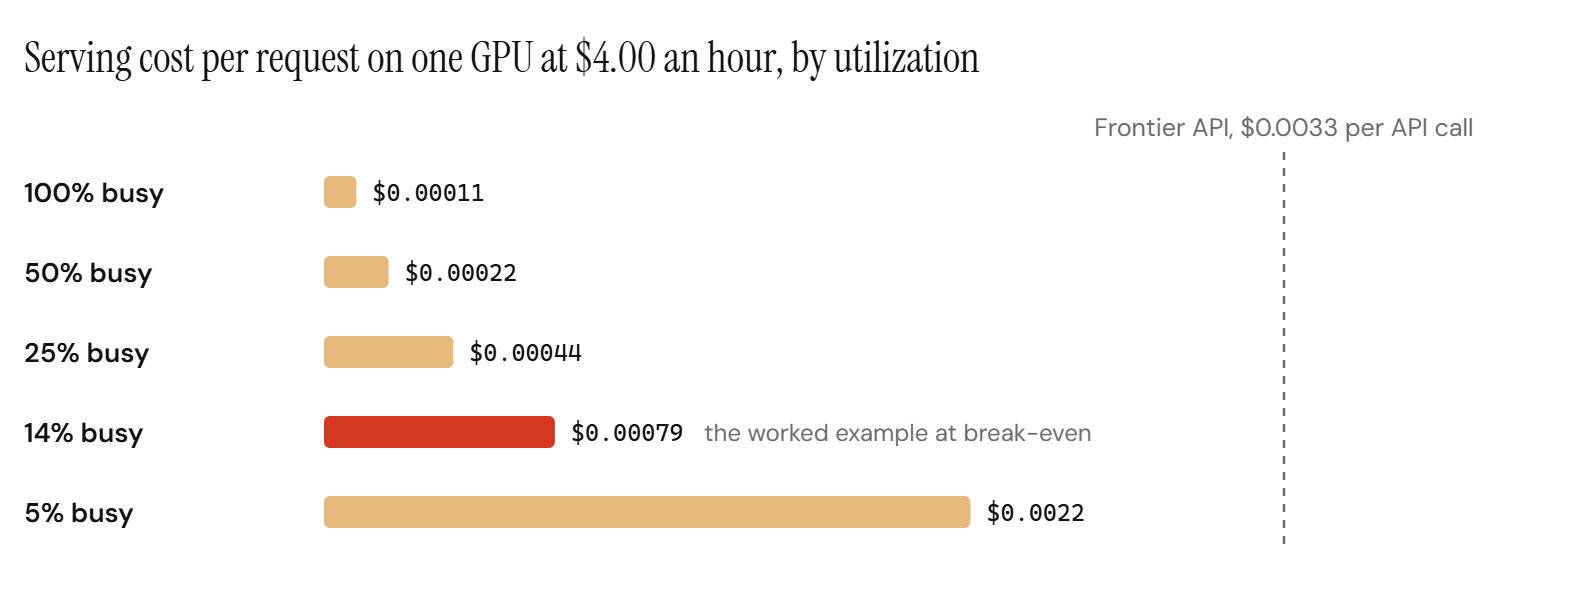
GPU 閒置的原因都很平常。流量在上班時間達到尖峰,而運算資源是按尖峰配置的。要在故障或部署期間保持上線,端點至少需要兩個副本。預備環境和評估環境也各自佔著 GPU。縮減到零的服務方式能減少閒置時數,代價是一段空檔之後的第一個回應會變慢。為單一任務訓練的模型通常只需要短得多的提示,因為指令不必隨每個請求一起送出,這會提高每張 GPU 能承載的請求數。
試算範例:客製化模型一側
下面是同一項理賠分流任務改用客製化模型的情況,每個假設都寫明了,方便您換成自己的數字。
| 項目 | 假設 | 每月成本 |
|---|---|---|
| 服務 | 2 張 GPU × 730 小時 × 4.00 美元 | 5,840 美元 |
| 營運工作 | 半名工程師,每月 20,000 美元 | 10,000 美元 |
| 重新訓練和評估運算資源 | 每月預算 | 1,000 美元 |
| 攤提的建置成本 | 60,000 美元分 12 個月 | 5,000 美元 |
| 固定成本合計 | 21,840 美元 | |
| 升級 | 10% 的 API 呼叫按 0.0033 美元 | 每次 API 呼叫 0.00033 美元 |
兩張 GPU 各自每秒處理 10 個請求,滿載時每月約能承載 5,260 萬個請求,所以在這個試算範例的所有呼叫量下,GPU 都維持兩張。服務成本只佔固定成本合計的四分之一多一點,工程時間才是最大的一項。
客製化模型的損益兩平呼叫量是多少?
損益兩平呼叫量等於客製化模型每月的固定成本,除以扣除升級之後每次 API 呼叫省下的錢。在這個試算範例中,約為每月 735 萬次 API 呼叫,大約每天 24 萬次。
損益兩平的每月 API 呼叫次數 = F / ((1 - e) x p - m)

F = 客製化模型每月的固定成本(GPU 底線、營運工作、運算資源、攤提的建置成本)
e = 仍需升級到前沿模型的 API 呼叫佔比
p = 前沿一側每次 API 呼叫的成本,按您實際支付的價格
m = 超出 GPU 底線之後每次 API 呼叫的服務成本(容量足夠時為零)
當 F = 21,840 美元、e = 10%、p = 0.0033 美元、m = 0 時,損益兩平點為 21,840 / (0.9 × 0.0033) = 21,840 / 0.00297 = 每月 7,353,535 次 API 呼叫。
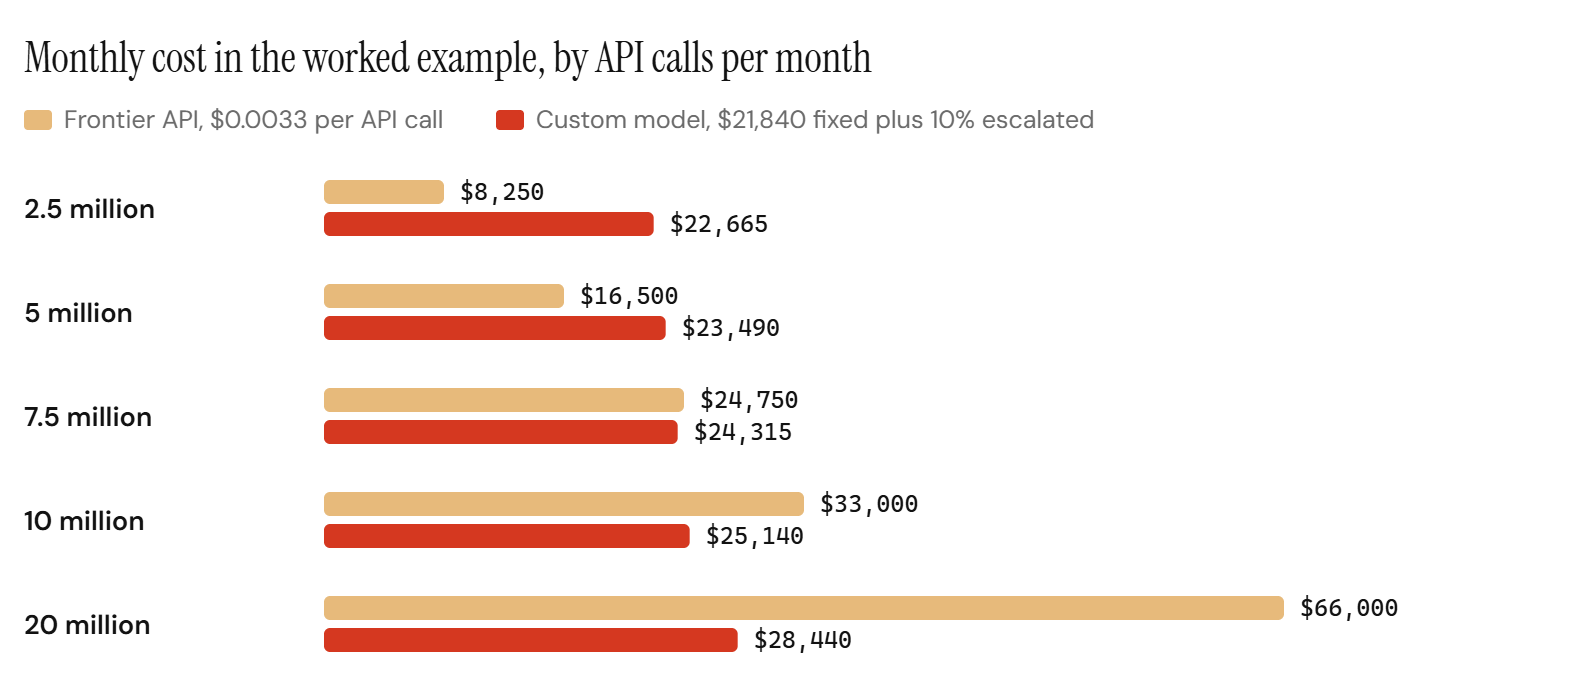
低於這個呼叫量時,前沿 API 比較便宜;高於它之後,每多一次 API 呼叫就省下 0.9 × 0.0033 = 0.00297 美元。所以在每月 2,000 萬次 API 呼叫時,客製化模型的成本是 28,440 美元,而前沿 API 是 66,000 美元,節省 57%。
損益兩平點對各項輸入有多敏感?
這些輸入都是估計值,所以請在您認為可信的範圍內都算一遍。下表每一列只改動試算範例中的一項輸入。
| 相對試算範例的改動 | 損益兩平的每月 API 呼叫次數 |
|---|---|
| 不改動 | 735 萬 |
| 與不含快取的 0.0060 美元比較 | 404 萬 |
| GPU 每小時 6.00 美元而非 4.00 美元 | 834 萬 |
| 升級佔比 30% 而非 10% | 945 萬 |
| 一名全職工程師而非半名 | 1,070 萬 |
| 前沿價格減半 | 1,470 萬 |
| 最便宜的規格通過評估,每次 API 呼叫 0.0003 美元 | 8,000 萬以上 |
GPU 價格對結果的影響最小,而您用來比較的前沿價格影響最大;每月固定成本每增加 1,000 美元,損益兩平點就增加約 33.7 萬次 API 呼叫。最後一列應該最先檢查:截至 2026 年 10 月,GPT-6 Luna 的定價為每百萬輸入 token 0.10 美元、每百萬輸出 token 0.50 美元,這項任務在它上面即使不計提示快取,每次 API 呼叫也只要 0.0003 美元。如果這麼便宜的規格就能通過您的評估集,單憑成本很少能證明客製化模型值得做,理由就要落在延遲或資料必須留在哪裡上。
兩邊各有哪些常被遺漏的成本?
兩邊都有在初步估算裡看不到的成本。相信損益兩平點之前,先把它們加進去。
| 一側 | 被遺漏的成本 | 為什麼重要 |
|---|---|---|
| 前沿 | 重試和驗證失敗 | 每次重試都是一次完整的 API 呼叫 |
| 前沿 | 升級到更強的規格 | 按更高的價格計費 |
| 前沿 | 推理 token | 按輸出計費,卻看不到 |
| 前沿 | 提示變長 | 每次修補都會讓指令更長 |
| 前沿 | 價格和模型變化 | 每次新版本發布都要重跑評估 |
| 客製化 | GPU 閒置時數 | 忙碌或閒置都要計費 |
| 客製化 | 評估集維護 | 評估集要跟上不斷變化的輸入 |
| 客製化 | 漂移和重新訓練 | 任務變化時品質會下滑 |
| 客製化 | 待命和故障處理 | 需要有人全天候為端點負責 |
| 客製化 | 前沿回退 | 升級的 API 呼叫按前沿價格計費 |
OpenAI 的推理指南說明,推理 token 按輸出 token 計費,儘管 API 從不回傳它們;推理模型每次 API 呼叫的真實價格,就是這樣逐漸高出按可見輸出算出的估計值。兩邊都要按單次成功任務的成本來衡量,把每一次重試和升級都算進去,具體做法見我們的單一任務成本與 AI 單位經濟學指南。
什麼時候應該用客製化模型取代前沿模型?
當某項任務的呼叫量遠高於您的損益兩平點、任務本身穩定,而且評估集可以自動評分時,就可以在這項任務上用客製化模型取代前沿模型。延遲和資料位置會在成本之外再添幾條理由。如果呼叫量低、任務每週都在變,或者沒人說得清什麼是好答案,就繼續使用前沿模型。
| 訊號 | 指向客製化模型 | 指向繼續使用 API |
|---|---|---|
| 呼叫量 | 遠高於損益兩平點,而且穩定 | 接近或低於損益兩平點 |
| 穩定性 | 每月的輸入和輸出格式相同 | 任務每週都在變 |
| 可衡量性 | 評估集能自動為輸出評分 | 品質要逐案判斷 |
| 延遲 | 使用者每次都在等回應 | 結果可以等 |
| 資料位置 | 必須留在您的雲端或地端 | 供應商條款已經可以接受 |
| 能通過評估的最便宜規格 | 仍是中高階規格 | 低階規格已經能通過 |
在損益兩平點之上要保留餘裕,因為在模型真正承接流量之前,公式裡的每一項輸入都只是估計。我們先前的微調小模型與 GPT-4 API 的比較按任務類型談了準確率和延遲,SaaS 何時該從 API 呼叫轉向微調則談了一家成長中的產品公司如何做這個決定。本指南在此基礎上補上了營運工作、升級佔比,以及用上快取和批次處理之後的前沿價格。
如何從前沿 API 遷移而不冒品質風險?
分階段遷移流量,每個階段都由評估集把關。先讓客製化模型在背景用真實請求執行,按您的品質標準評分,再給它一小部分線上流量並以前沿模型作為回退,然後逐步擴大。在每個階段,使用者依賴的都只是已經通過評估的版本。
- 基準線。 記錄單次成功任務的成本,並用評估集為目前的前沿模型評分,讓客製化模型有一條要跨過的標準線和一個要打敗的成本。
- 背景評分。 把真實請求複製一份送給客製化模型,同時使用者繼續收到前沿模型的回答。用評估集為它的輸出評分,並在真實負載下觀察延遲和錯誤率。
- 評估關卡。 只有在評估集和背景樣本上都達標、並有指定負責人簽核的版本,才能上線。
- 小比例上線。 把百分之幾的線上流量交給客製化模型,遇到驗證失敗、逾時或信心分數偏低時自動回退到前沿模型。
- 逐步擴大。 在品質和成本報告維持穩定的前提下,分步提高比例。
- 保留回退。 困難案例和新類型的輸入繼續交給前沿模型,每個重新訓練的版本都要再過同一道關卡。
把每個重新訓練的版本都當作一個新模型。一次重新訓練可能改善一部分流量,卻讓另一部分退步,而關卡能在使用者發現之前把它攔下。第 4 步和第 6 步背後的路由模式,見 降低前沿 API 成本的 LLM 路由策略。
自適應模型端點如何改變這筆帳?
自適應模型端點把公式裡營運的那一側從您的團隊身上拿走。它是為您的某一項任務提供的單一 API 端點:起初由前沿模型回答,用您的請求和團隊回饋訓練出的客製化模型在通過您的評估集後接手,困難的案例繼續留在前沿模型上。
升級的請求仍按前沿價格計費,這正是損益兩平公式裡要有升級佔比的原因。
上面的遷移路徑已經內建其中。客製化模型的每個新版本都會在背景用真實請求執行,並依您的評估集評分,未經您的核准,什麼都不會切換。我們監控模型,並隨著您的任務變化重新訓練。模型可以由 Ertas 代管執行,也可以部署在您的雲端或地端,並且歸您所有。該端點目前僅限受邀企業使用,我們正在開發一個更精簡的版本,讓更多企業可以接入。您的工程師只需改一個模型名稱,起初由前沿模型處理所有請求,所以不會有任何工作等待訓練。
這樣一來,成本問題就只剩一個比較:這個端點,與它在這項任務上取代掉的前沿帳單相比,用您自己的流量和 token 數來算。
為單一工作訓練的模型,服務成本可以非常低。在我們發表的 QMSum 研究中,一個為查詢式會議摘要訓練的 1.2B 模型,在一張租用的雲端 GPU 上估算的服務成本為每次查詢 0.00053 美元;按同步呼叫定價,Claude Opus 5 為 0.104 美元,GPT-5.6 Luna 為 0.0130 美元。它 0.39 秒給出回答,Claude Opus 5 則需要 9.0 秒。這個估算不含訓練成本,而且品質因任務而異,所以每一次切換都要以您的評估集為準。
常見問題
微調模型比 GPT 或 Claude 的 API 更便宜嗎?
按單一請求算,為單一任務微調的模型服務成本通常低得多,因為它可以小得多,提示也更短。按月算,只有超過損益兩平呼叫量時它才更便宜,因為無論流量來不來,GPU、評估、監控和重新訓練都要花錢。請用您實際支付的前沿價格來套公式。
自行託管 LLM 的損益兩平點是多少?
它等於自行託管模型每月的固定成本,除以扣除升級後每次 API 呼叫省下的錢,即 F / ((1 - e) × p - m)。在我們的試算範例中,每月固定成本為 21,840 美元,含快取的前沿價格為每次 API 呼叫 0.0033 美元,損益兩平點約為每月 735 萬次 API 呼叫。您的輸入會不一樣,所以請用自己的數字來算。
執行自己的 LLM 每月要花多少錢?
服務、營運工作和攤提的建置成本。截至 2026 年 10 月,RunPod、Lambda 和 CoreWeave 的隨需牌價中,H100 約為每 GPU 小時 2.90 至 6.20 美元,所以兩張 GPU 執行一整個月約需 4,200 至 9,000 美元。在試算範例中,評估、監控和重新訓練模型所需的工程時間才是更大的一項。
客製化模型應該和批次處理價格比較嗎?
對於可以等待結果的工作,應該。截至 2026 年 10 月,OpenAI 和 Anthropic 的批次處理都按標準費率的 50% 收費,而前沿價格減半,損益兩平呼叫量就加倍。拿非同步工作負載和同步定價比較,會讓客製化模型顯得過於划算。
換成客製化模型之後,困難的請求怎麼辦?
繼續交給前沿模型。在驗證失敗、逾時和信心分數偏低時進行路由,並在公式裡為這部分升級佔比保留預算,因為升級的 API 呼叫按前沿價格計費。使用自適應模型端點時,困難的案例本來就留在前沿模型上。
透過自適應模型端點提供服務的客製化模型歸誰所有?
歸您所有。模型用您的請求和團隊回饋、針對您的任務訓練,可以由 Ertas 代管執行,也可以部署在您的雲端或地端。我們監控它,並隨著您的任務變化重新訓練。
簡短版
客製化模型在某個呼叫量之上才在成本上勝出:它每月的固定成本,除以每次 API 呼叫省下的錢。前沿一側要在用上快取、批次處理和選對規格之後再計價;客製化模型一側要算上營運工作和升級佔比,並按您真實會達到的使用率來配置 GPU。然後在評估關卡之後遷移,並保留前沿回退。
如果某項任務的呼叫量正在逼近或已經越過損益兩平點,預約通話,我們和您一起用您的流量把帳算清楚。
資料來源:OpenAI API 定價、Anthropic 定價、Anthropic 提示快取文件、OpenAI 推理指南,以及 RunPod、Lambda 和 CoreWeave 的 GPU 隨需定價。價格核實於 2026 年 10 月 6 日。