打造你所 拥有的模型。
训练定制 AI 模型,随处部署。
为任务而训练的模型
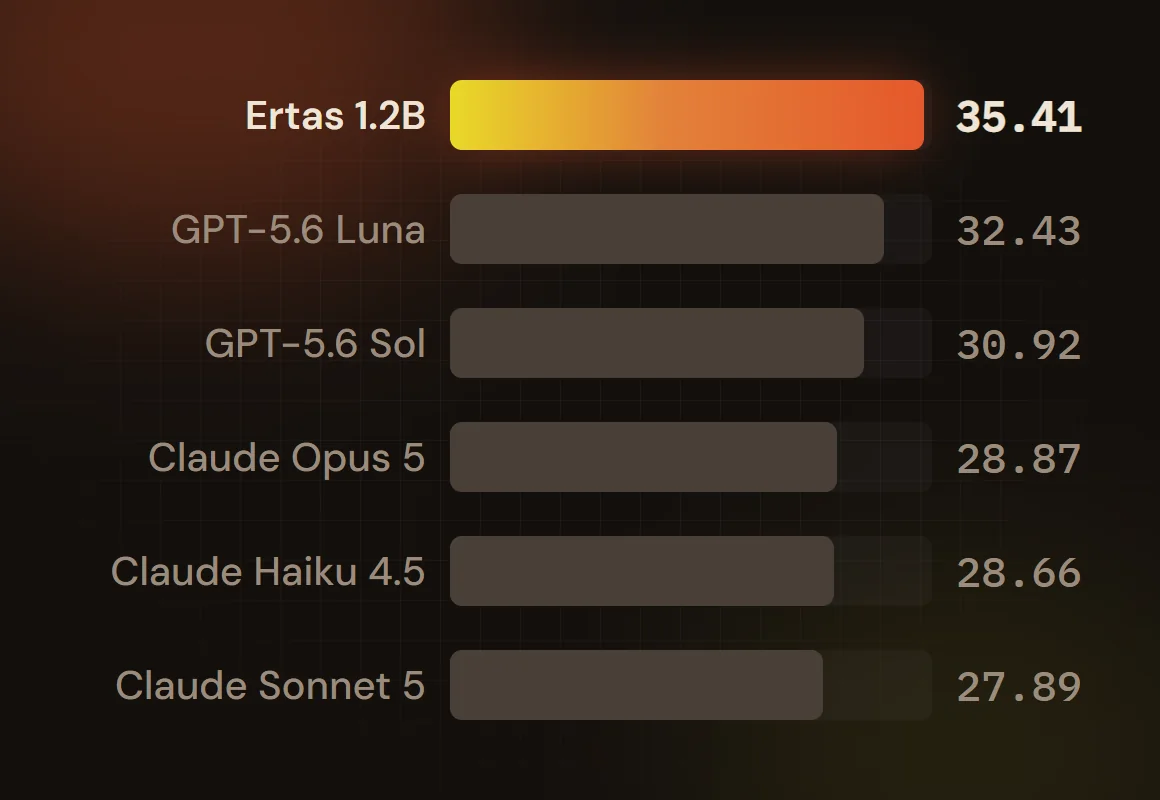
智能体流水线每天要把同样的既定任务重复成千上万次。为每个步骤配一个专门为该任务训练的小模型,就能以一小部分运行成本获得前沿水平的结果。
阅读论文(英文)35.41 vs 32.43
在一项摘要基准测试(QMSum)上,我们训练的 1.2B 摘要模型对比五个托管专有模型中的最佳成绩(ROUGE-1),其中包括 Claude Opus 5 和 GPT-5.6。我们训练的一个 406M 模型得分 36.33。两者都比前沿模型小 1,000 倍以上,可在你自己的硬件上运行,无需按 token 付费。
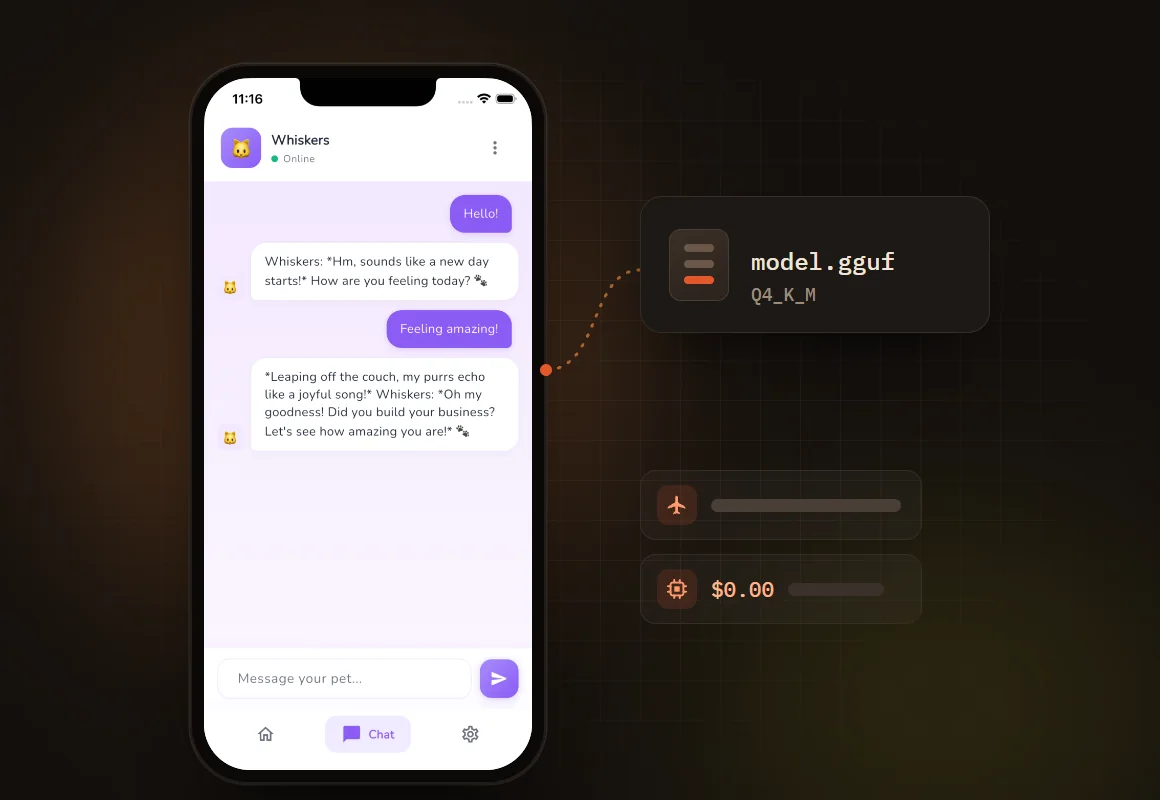
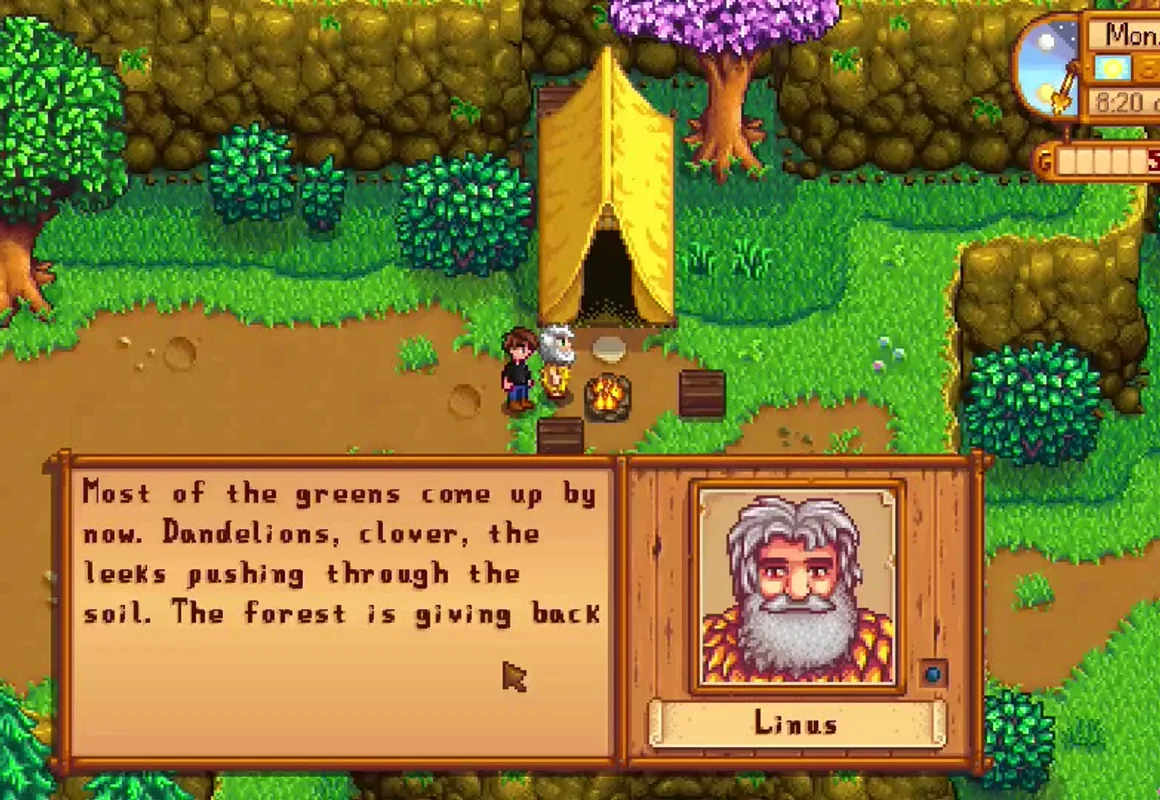
Chatty Valley 让一位《星露谷物语》村民能够自由对话,同时始终不出戏。一个小型基础模型在玩家自己的电脑上运行,每个角色都是叠加在其上的一个轻量适配器。
阅读开发故事21 MB
装下了 Linus 的全部性格:一个叠加在共享 1.2B 基础模型上的适配器,完全在本地运行。
把为你的功能训练的模型集成到 iOS、Android 或桌面应用中,离线也能运行,用户数据留在设备上。现在在用现成的 API 模型?自适应模型端点可以替你运行训练好的模型。
自适应模型端点查看端侧 AI 的成本对比$0
每次推理的成本,模型在用户设备上运行。
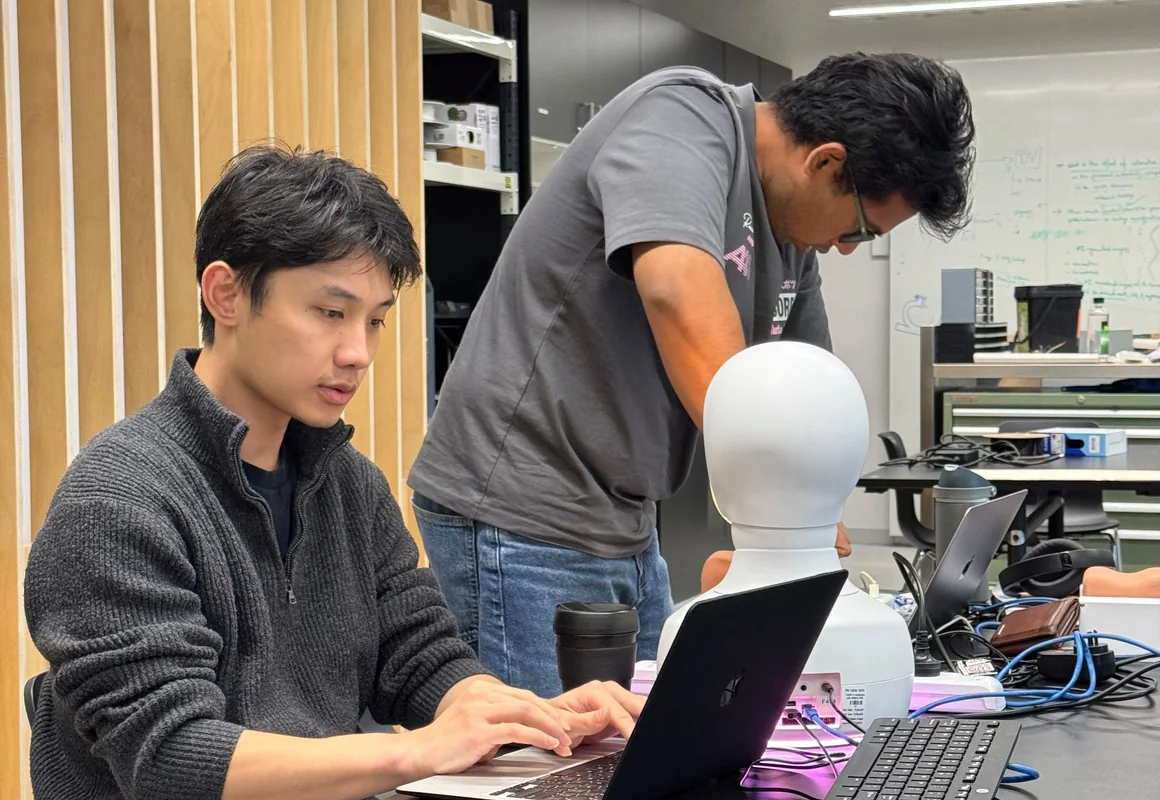
一位用于物理治疗教学的 AI 病人。学生检查实体模拟器并口头提问,一个在 Ertas 上训练的小模型以病人的身份作答,前后回答保持一致,并直接在模拟器自带的硬件上运行。
2026 年 9 月
在 Melbourne Connect 创新周现场展示。完整案例研究即将推出。
01 / 04
专用智能体
智能体流水线每天要把同样的既定任务重复成千上万次。为每个步骤配一个专门为该任务训练的小模型,就能以一小部分运行成本获得前沿水平的结果。
35.41 vs 32.43
在一项摘要基准测试(QMSum)上,我们训练的 1.2B 摘要模型对比五个托管专有模型中的最佳成绩(ROUGE-1),其中包括 Claude Opus 5 和 GPT-5.6。我们训练的一个 406M 模型得分 36.33。两者都比前沿模型小 1,000 倍以上,可在你自己的硬件上运行,无需按 token 付费。
阅读论文(英文)专用智能体
智能体流水线每天要把同样的既定任务重复成千上万次。为每个步骤配一个专门为该任务训练的小模型,就能以一小部分运行成本获得前沿水平的结果。
阅读论文(英文)35.41 vs 32.43
在一项摘要基准测试(QMSum)上,我们训练的 1.2B 摘要模型对比五个托管专有模型中的最佳成绩(ROUGE-1),其中包括 Claude Opus 5 和 GPT-5.6。我们训练的一个 406M 模型得分 36.33。两者都比前沿模型小 1,000 倍以上,可在你自己的硬件上运行,无需按 token 付费。
游戏开发
Chatty Valley 让一位《星露谷物语》村民能够自由对话,同时始终不出戏。一个小型基础模型在玩家自己的电脑上运行,每个角色都是叠加在其上的一个轻量适配器。
阅读开发故事21 MB
装下了 Linus 的全部性格:一个叠加在共享 1.2B 基础模型上的适配器,完全在本地运行。
应用开发
把为你的功能训练的模型集成到 iOS、Android 或桌面应用中,离线也能运行,用户数据留在设备上。现在在用现成的 API 模型?自适应模型端点可以替你运行训练好的模型。
自适应模型端点查看端侧 AI 的成本对比$0
每次推理的成本,模型在用户设备上运行。
专业培训
一位用于物理治疗教学的 AI 病人。学生检查实体模拟器并口头提问,一个在 Ertas 上训练的小模型以病人的身份作答,前后回答保持一致,并直接在模拟器自带的硬件上运行。
2026 年 9 月
在 Melbourne Connect 创新周现场展示。完整案例研究即将推出。
前沿水平的结果,由你掌控
99%
比 Claude Opus 5 成本更低
比 GPT-5.6 Luna 低 96%
+18%
训练后效果提升
ROUGE-1,同一模型训练前后对比
23×
比 Claude Opus 5 更快
比 GPT-5.6 Luna 快 6 倍
基于我们在摘要基准测试(QMSum)上的研究测得。 阅读论文
只需一小部分运行成本。
用量越过交点之后,拥有自己的模型比按 token 付费更便宜。
- 前沿 API
- 云端定制模型
- 端侧定制模型
- 你节省的成本
示意图。交点取决于你的任务和托管方式。
完全掌控。
部署在哪里,就在哪里运行。
端侧、你自己的云或本地机房。
固定在你测试过的版本。
只有重新训练时才会改变。
行为由你的示例决定。
语气、格式和拒绝方式都来自你的数据。
你的数据保持私密。
模型归你所有,可以下载。
使用方式
训练你的 AI 模型。 可视化操作。
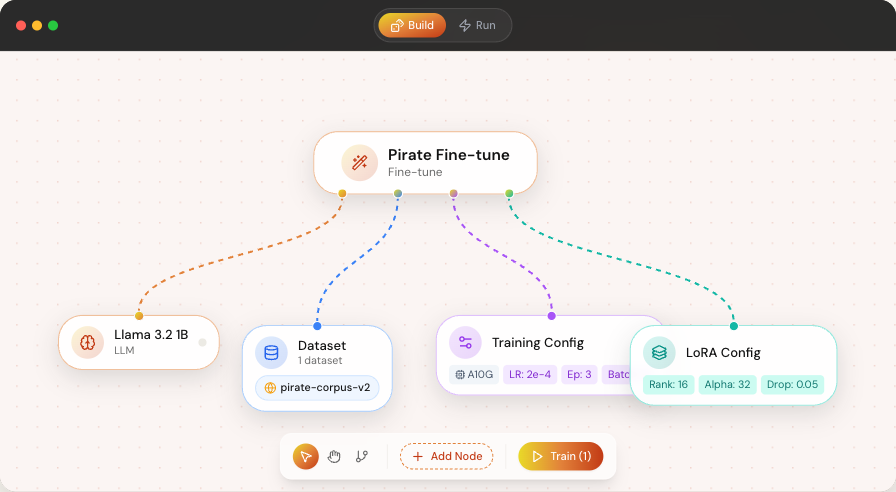
上传你的数据集
上传你自己的 JSONL,或使用 URL 从 Hugging Face 导入一个。还没有数据集?在我们的引导式数据集构建工具 Data Craft 中从零开始构建一个。
在 Studio 中微调
在高速云端 GPU 上并行微调多个模型,无需昂贵的硬件。可视化画布是你迭代的地方:对比训练、调整配方,并决定什么最适合你的产品。
在产品运行的地方部署
将你的微调模型导出为 GGUF,通过 llama.cpp、Ollama 或 LM Studio 在端侧或本地运行。今天即可部署到你自己的托管云端,Ertas 上的一键部署即将推出。
平台一览
微调和部署自定义 AI 所需的一切。
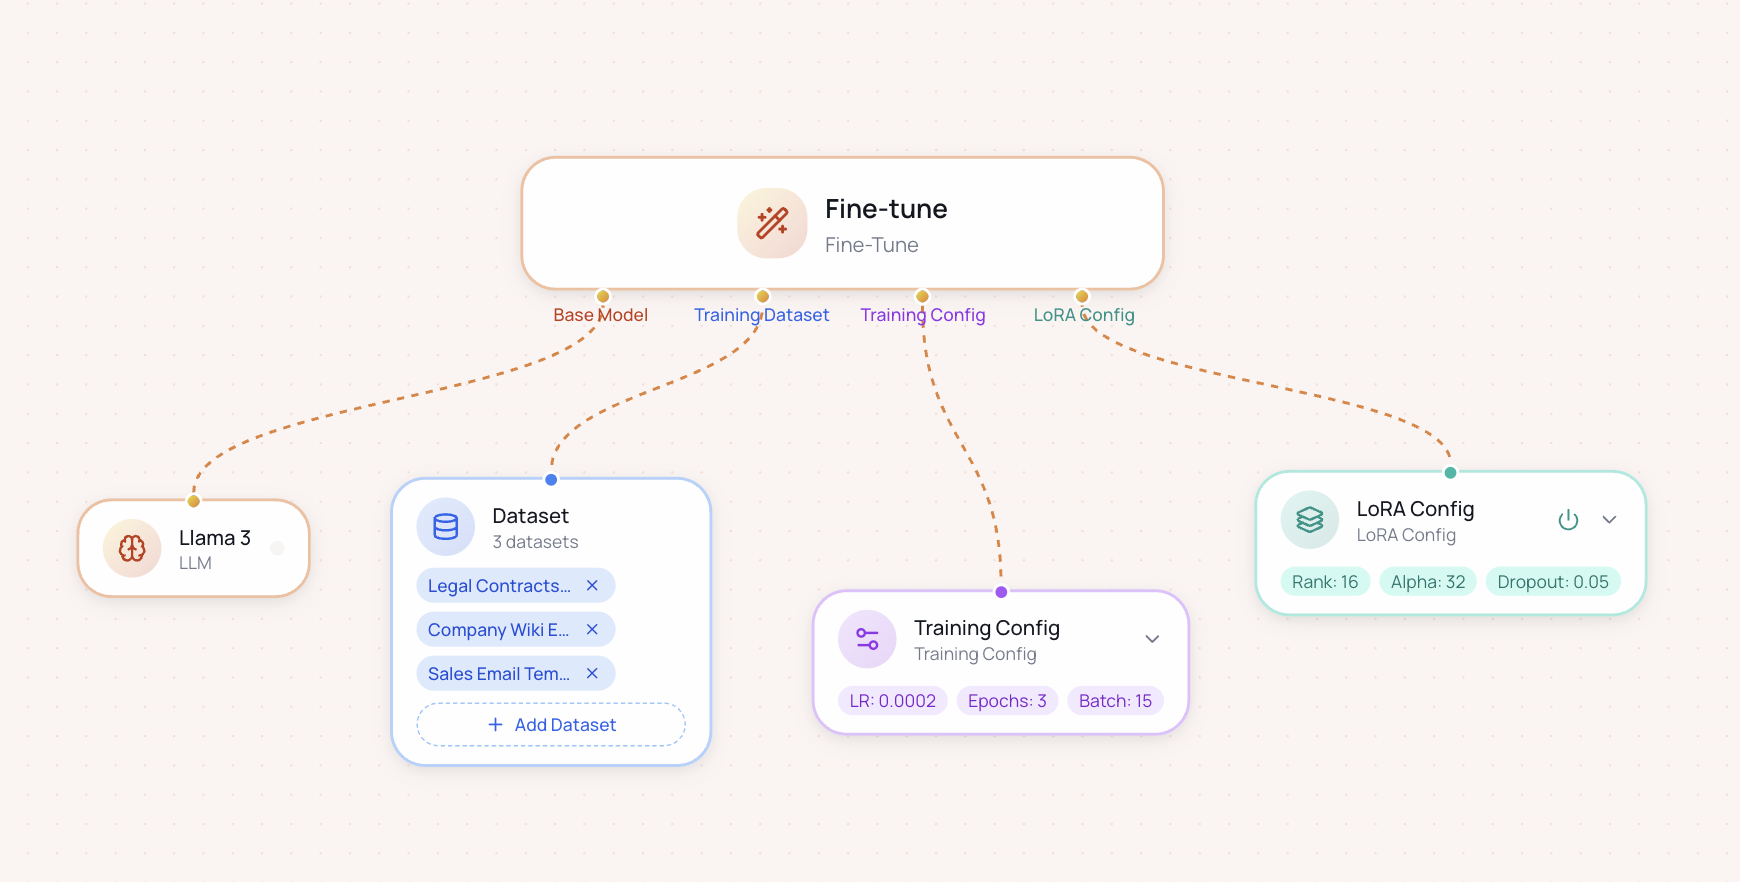
为什么要拥有自己的模型?
- 01
懂你的领域。
用你的数据,为你的任务训练。
- 02
在你需要的地方运行。
在设备端离线运行,用户数据留在设备上。
- 03
无需机器学习团队。
训练流程由 Ertas 负责。
为你的工作方式而设计
免费起步,按需扩展。
免费版
试用,每月 30 积分
- 每日刷新 5 积分/天(每月最多 30)
- 5B 以下模型
- 更大的训练任务和更大的模型需要付费套餐
- 模型 5 GB
- 数据集 250 MB
- 手动测试沙盒
Lite
面向已超出免费套餐的构建者
- 每月 40 积分
- 最高 14B 模型
- 模型 25 GB
- 数据集 1 GB
- 更高级 GPU
- 1 个月积分滚存
- 完整模型导出(safetensors)
Builder
面向独立开发者与个人构建者
- 每月 100 积分
- 最高 14B 模型
- 模型 50 GB
- 数据集 2 GB
- 更高级 GPU
- 1 个月积分滚存
- 完整模型导出(safetensors)
Pro
面向高阶用户与管理客户项目的团队
- 每月 200 积分
- 模型 100 GB
- 数据集 5 GB
- 优先 GPU 队列
- 新功能抢先体验
- 完整模型导出(safetensors)
Business
面向规模化团队与多客户机构
- 每月 400 积分
- 模型 200 GB
- 数据集 10 GB
- 更高优先级 GPU 队列
- 新功能优先抢先体验
- 完整模型导出(safetensors)
常见问题
关于使用 Ertas 训练和发布定制模型的常见问题。
不需要。Ertas 负责训练流程、GPU 配置、模型打包和导出路径。你只需带来产品判断:任务、数据,以及对你的应用而言什么才算"好"。
不是。端侧部署是一个很有优势的用例,因为它带来离线支持、隐私保护和零的每令牌推理成本。你也可以训练用于服务端推理、托管 GPU 部署、内部工具、支持机器人、智能体和产品工作流的模型。
你会得到一个微调模型工件,可以测试、导出并集成到你的应用中。对于本地或端侧部署,Ertas 支持 GGUF 导出。对于希望托管推理的团队,Ertas 可以通过自适应模型端点为你提供模型服务,Studio 一键部署已在规划中。
Ertas 支持包括 Gemma、Qwen、Llama、Mistral 和 Phi 在内的热门开源模型。我们专注于构建者真正能够发布的模型,从用于本地和端侧的小模型,到用于服务端或 GPU 部署的大模型。一些其他模型系列可能可以实验性运行,但官方支持以上述列出的模型为起点。
Ertas 会存储你的数据集,这样你可以重新运行实验、对比训练,避免再次上传相同的文件。你始终掌控上传的内容,并可以在 Data Craft 中删除不再需要的数据集。有更严格数据要求的团队,可以联系我们了解企业方案。
Model Studio 是目前的核心产品:上传数据、在云端 GPU 上训练模型、测试结果,并为你的应用导出模型。Hub 让你在一个地方管理微调模型,公开发现和分享功能即将推出。不想自行运行托管的团队,现在就可以通过自适应模型端点由 Ertas 提供模型服务,Studio 一键部署已在规划中。
可以。免费套餐立即开始,无需信用卡。你将获得每月积分,用于训练和测试较小的模型。付费套餐提供更多积分、更大模型支持、更多存储,以及更高优先级的 GPU 访问。