

智能体 AI 成本优化,就是降低每一次成功的智能体运行的成本。这笔成本的大头是每一步都要重新发送的上下文,所以最大的节省来自:裁剪工具输出、清理旧的工具结果、缓存静态前缀、限制每次运行的步数,以及把常规步骤交给更便宜的模型。
智能体是 token 账单增长最快的地方。2025 年 6 月,Anthropic 披露,在其数据中,智能体通常比聊天交互多用约 4 倍的 token,多智能体系统则多用约 15 倍。同一篇文章还发现,在 BrowseComp 评估中,仅 token 用量一项就解释了 80% 的性能差异。token 能换来结果,所以要做的是找出那些什么也没换来的 token。
本指南从头到尾跟踪一次智能体运行:它的 token 去了哪里,如何测量,以及按节省幅度排序的修复办法。模型层面的技术,见 LLM 成本优化:12 种技术排名;管理视角,见如何降低企业的 AI token 成本。
为什么 AI 智能体要用这么多 token?
智能体在一个循环里工作。每一步就是一次 API 调用:模型读完目前为止的全部内容,然后要么请求一个工具,要么写出答案。每次 API 调用都按模型的全部输入计费,所以每一步都要为系统提示、工具定义、任务以及之前所有步骤的完整记录(包括每一个工具结果)再付一次钱。
因此,一次运行的输入增长得比步数更快:
每次运行的输入 token = n x (前缀 + 任务)
                     + (每步新增的 token) x n(n-1)/2

n    = 本次运行的 API 调用次数
前缀 = 系统提示 + 工具定义
第一项随运行长度同步增长。第二项随步数的平方增长,而且通常由工具结果主导,因为一次搜索或数据库查询就可能返回几千个 token。
以一个示意性的客服智能体为例:前缀 8,000 个 token(一个系统提示加 15 个工具定义),任务 500 个 token,共 12 次 API 调用。每一步写出 300 个 token 的推理和工具参数,每个工具返回 1,700 个 token。整个运行下来,智能体发送了 234,000 个输入 token,写出了 3,600 个。
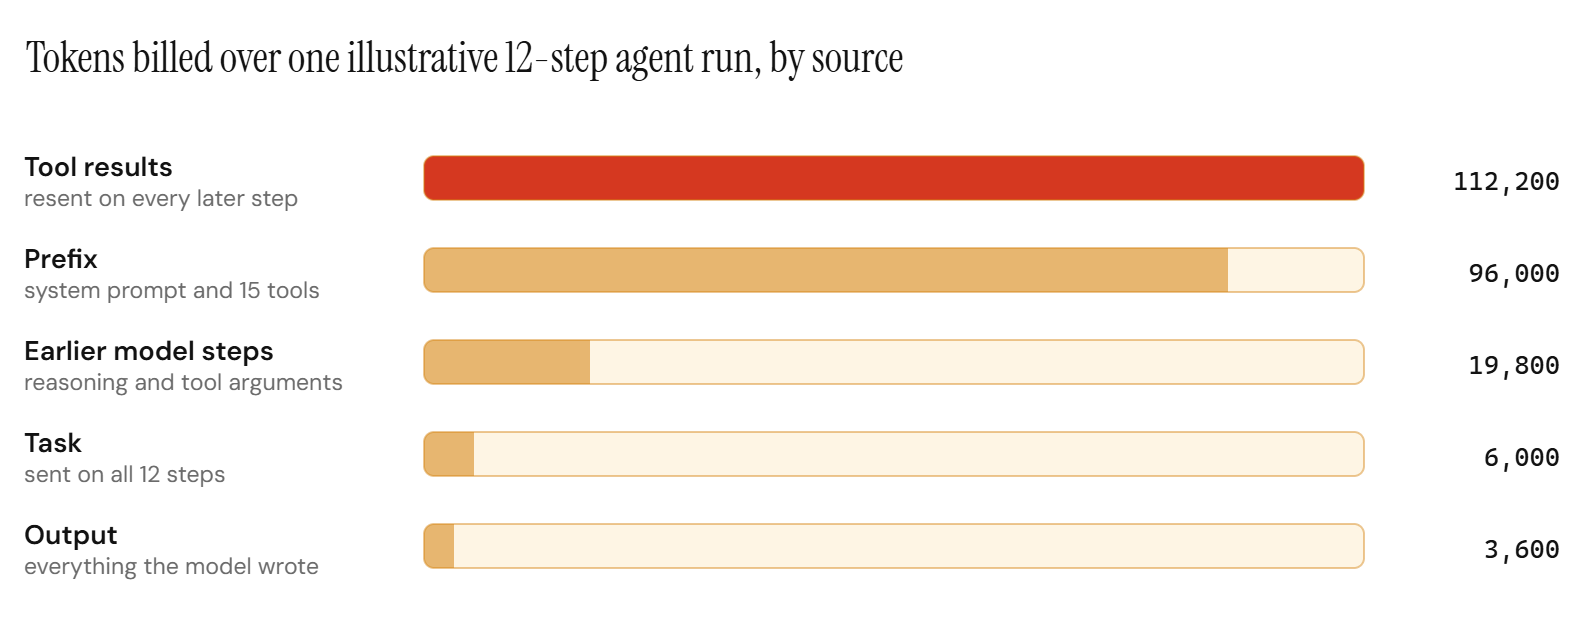
所以,压低智能体成本主要是在处理上下文。智能体已经用过的工具结果是最大的一项,每一步都完全相同的前缀是第二大项。两者修复起来都不贵,本指南后文会用同一次运行来说明能省多少。
运行长度和内容同样重要。把这次运行加倍到 24 次 API 调用,输入会增加到原来的三倍多,达到 756,000 个 token,这也是为什么运行的长尾在智能体账单里占比这么大。
如何测量一次智能体运行的成本?
在每次 API 调用时按运行 ID 记录用量,再按运行汇总。一个小小的账本就够了:
from dataclasses import dataclass, field

# 每百万 token 的美元价格,截至 2026 年 10 月 Claude Opus 5 的标价。
# cache_write 是 5 分钟缓存的费率;1 小时缓存写入为基础输入价格的 2 倍。
PRICE = {"input": 5.00, "cache_write": 6.25, "cache_read": 0.50, "output": 25.00}

@dataclass
class RunLedger:
    run_id: str
    task_type: str
    steps: int = 0
    tokens: dict = field(default_factory=lambda: dict.fromkeys(PRICE, 0))

    def record(self, usage):
        # Anthropic 把缓存 token 放在 input_tokens 旁边的独立字段里。
        self.steps += 1
        self.tokens["input"] += usage.input_tokens
        self.tokens["cache_write"] += usage.cache_creation_input_tokens or 0
        self.tokens["cache_read"] += usage.cache_read_input_tokens or 0
        self.tokens["output"] += usage.output_tokens

    @property
    def cost(self):
        return sum(self.tokens[k] * PRICE[k] for k in PRICE) / 1_000_000
把每个响应的用量对象传给 record,包括重试,以及为这次运行工作的任何子智能体。然后按智能体和任务类型报告四个数字:
| 指标 | 它告诉您什么 |
|---|---|
| 每次成功运行的成本 | 总花费除以达标的运行次数 |
| 运行成本中位数 | 一次正常运行的成本 |
| p95 的运行成本和步数 | 长尾有多长 |
| 成功率 | 某项节省是否牺牲了质量 |
import statistics

def cost_report(runs):
    """runs:同一智能体、同一任务类型的 (ledger, succeeded) 对列表。"""
    costs = sorted(ledger.cost for ledger, _ in runs)
    wins = sum(1 for _, ok in runs if ok)
    return {
        "cost_per_successful_run": sum(costs) / max(wins, 1),
        "median_run_cost": statistics.median(costs),
        "p95_run_cost": costs[int(0.95 * (len(costs) - 1))],
        "success_rate": wins / len(runs),
    }
用成功运行的次数做分母,同时把失败运行的成本留在分子里。一项改动把中位数降低了三分之一,却让更多运行陷入重试,每次成功运行的成本反而可能上升。循环、重试和迷失方向的运行都集中在 p95 一带;又因为输入随步数的平方增长,长度为中位数两倍的运行,成本可能达到约三倍。
要根据任务的价值为这个数字设定目标,见单任务成本:衡量 AI 的单位经济效益。
哪些修复最能降低智能体的 token 用量?
大致按下面的顺序来做。前五项只改变上下文和上限,对质量的风险很小。后两项会改变由多少个智能体、由哪个模型来干活,所以需要先有评估集。
| 修复 | 压缩的部分 | 投入 | 质量风险 |
|---|---|---|---|
| 在工具端裁剪输出 | 工具结果 token | 低 | 低 |
| 返回结构化的工具结果 | 工具结果 token | 低 | 低 |
| 清理旧的工具结果 | 被重新发送的历史 | 低 | 中 |
| 缓存静态前缀 | 前缀的价格 | 低 | 无 |
| 限制每次运行的步数和花费 | 长尾 | 低 | 低,需配合交接 |
| 收紧子智能体的范围 | 重复的上下文 | 中 | 中 |
| 为每一步选择模型 | 每个 token 的价格 | 中 | 需要分步评估集 |
在工具端裁剪输出
工具决定了什么会进入上下文,而它返回的一切都会在之后的每一步再计费一次。返回完整客户档案的 CRM 查询、返回十个完整网页的搜索、返回原始日志行的日志查询,都是常见的元凶。
- 只返回智能体会用到的字段。为每个工具定义一个视图,不要直接序列化整行数据库记录。
- 在工具内部限制行数和字符数,并说明裁掉了什么:“显示 1,240 行中的 20 行,如需更多请请求第 2 页”。智能体需要时可以再要。
- 在工具里过滤冗长的输出:失败的测试和它的报错、匹配的日志行、文档中相关的章节。
- 报错信息保持简短、可操作,因为堆栈跟踪同样会被重新发送。
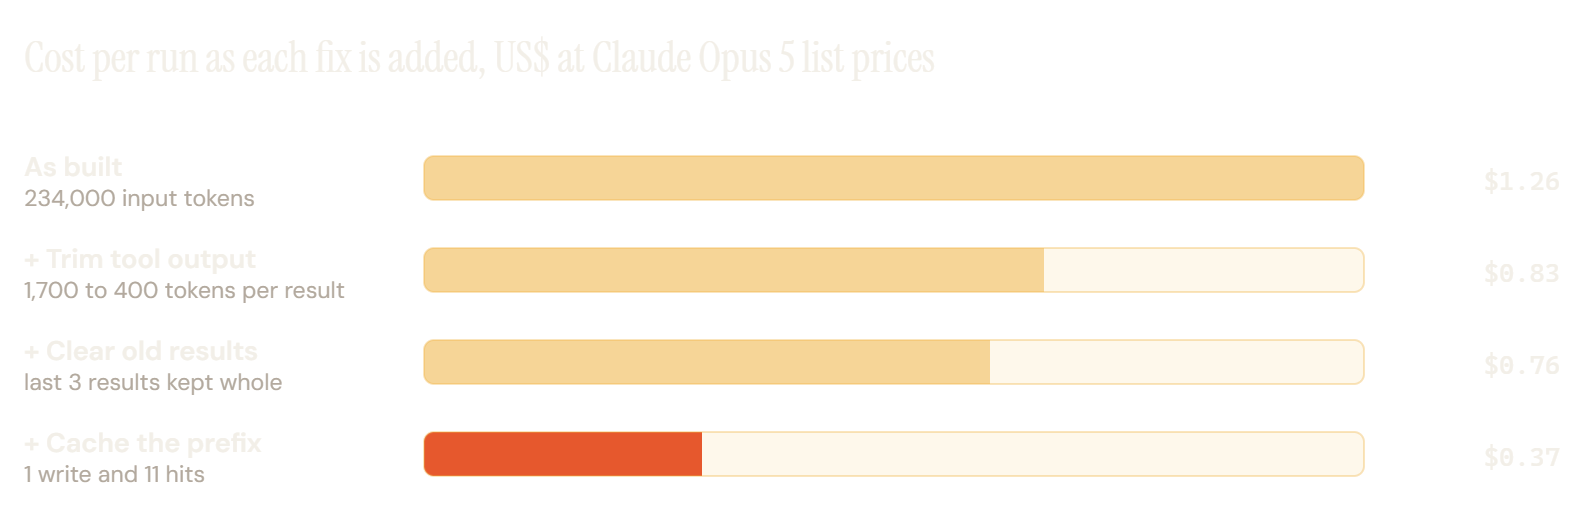
在示例运行中,把每个工具结果从 1,700 个 token 裁到 400 个,每次运行的输入就从 234,000 降到 148,200 个 token。
返回结构化的工具结果
只含必要字段、键名简短的 JSON 很紧凑,模型读起来也比自由文本更可靠。返回 ID,让智能体只为它真正需要的少数记录请求详情。保持键的顺序稳定,因为 Anthropic 的提示缓存文档提醒,在转换为 JSON 时会打乱键顺序的语言会破坏缓存。
清理旧的工具结果
智能体一旦根据某个结果采取了行动,就很少再需要它的全文。把较早的结果替换成一行占位文字,或替换成智能体从中得到的结论,只保留最近几个结果的全文。
Anthropic 在服务端提供了这项功能。截至 2026 年 10 月,它的上下文编辑功能(测试版)包含一种工具结果清理策略:当输入超过您设定的阈值(默认 100,000 个 token)时,用占位文字替换较早的结果。它的压缩功能(同为测试版)则用一段摘要替换较早的对话轮次。文档指出,清理工具结果会让缓存的提示前缀从清理处开始失效,所以要成批地大量清理,清掉的量要足以抵消重写缓存的成本。
在示例运行中,只保留最后三个结果的全文,输入从 148,200 降到 133,800 个 token。这里节省不多,是因为结果已经裁剪过了。在未裁剪的运行上,同一条规则单独就能省下 61,200 个 token。
缓存静态前缀
智能体是提示缓存的最佳场景,因为同一个前缀在每一步都会发送,间隔只有几秒或几分钟。Anthropic 的缓存文档把缓存的前缀描述为依次排列的工具、系统和消息,所以工具定义和系统提示会一起缓存在最前面。截至 2026 年 10 月,Anthropic 在大多数 Claude 模型上按输入价格的十分之一收取缓存命中费用,5 分钟缓存的写入按 1.25 倍收费。
在智能体中保持高命中率有三条规则:
- 在整个运行期间固定工具定义,并保持固定顺序。同一份文档写明,修改工具定义会让整个缓存失效,所以要一开始就加载全部工具,避免在运行中途添加工具。
- 时间戳、用户名和运行 ID 不要放进系统提示,放到第一条用户消息里。
- 在每一步记录缓存读取和写入字段,因为一次悄无声息的未命中只会表现为更高的账单。
在示例运行中,缓存这 8,000 个 token 的前缀,会把按全价计费的 96,000 个 token 变成一次写入加 11 次命中,成本相当于 18,800 个 token。
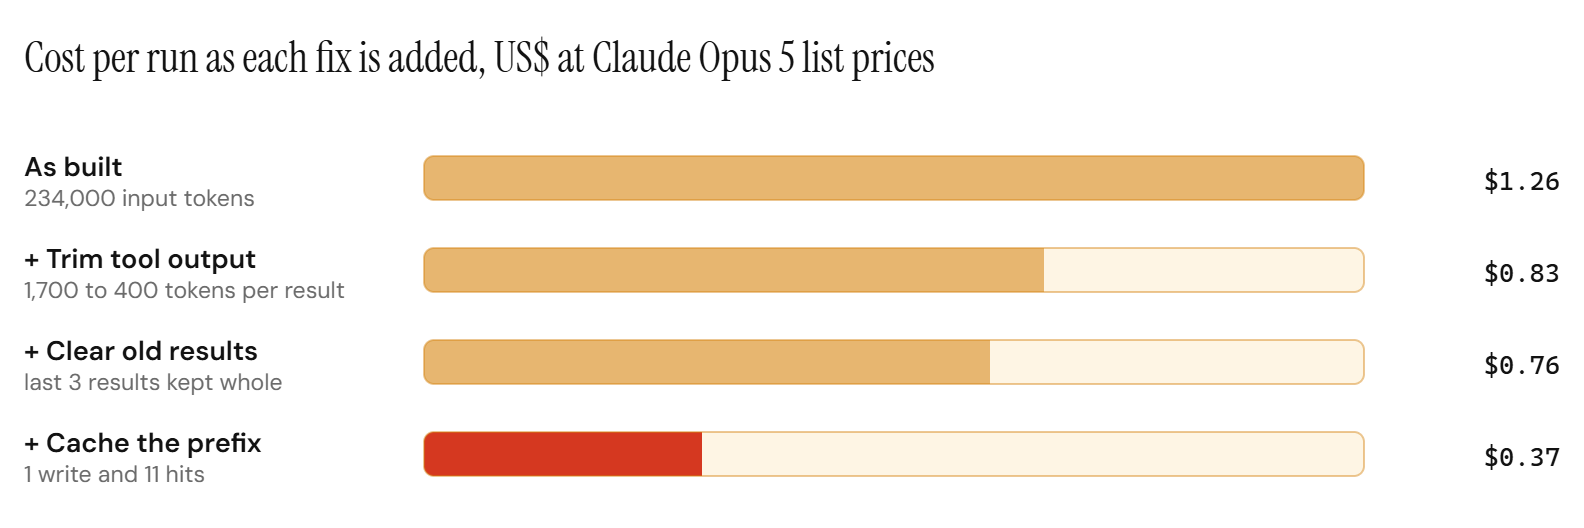
限制每次运行的步数和花费,并干净地交接
长运行的成本比它的长度看起来更高,所以长尾需要一个硬性的停止点。在每次 API 调用之前检查上限:
class BudgetExceeded(Exception):
    pass

def check_budget(ledger, max_steps=20, max_cost_usd=2.00):
    if ledger.steps >= max_steps or ledger.cost >= max_cost_usd:
        raise BudgetExceeded(
            f"run {ledger.run_id}: {ledger.steps} steps, ${ledger.cost:.2f}"
        )
根据数据设定上限。从成功运行的 p95 附近起步,再留一些余量,并在智能体每次改动时重新审视。当一次运行触及上限,要干净地结束它:保存一段简短的状态摘要,把任务交给人工或更简单的路径,并在账本里把这次运行记为失败。我们关于 AI 智能体中的人工介入的指南介绍了交接设计。
再加一道循环检查。一个连续两次用相同参数请求同一个工具的智能体,通常已经卡住了,在这里停下比等着步数上限来拦截更省钱。
Anthropic 的任务预算功能截至 2026 年 10 月仍是测试版,它会告诉 Claude 整个智能体循环有多少 token 可用,让模型自己掌握节奏。文档把这个预算描述为建议性的,所以硬性上限要放在您自己的循环里,预算只用来调节节奏。
收紧子智能体的范围
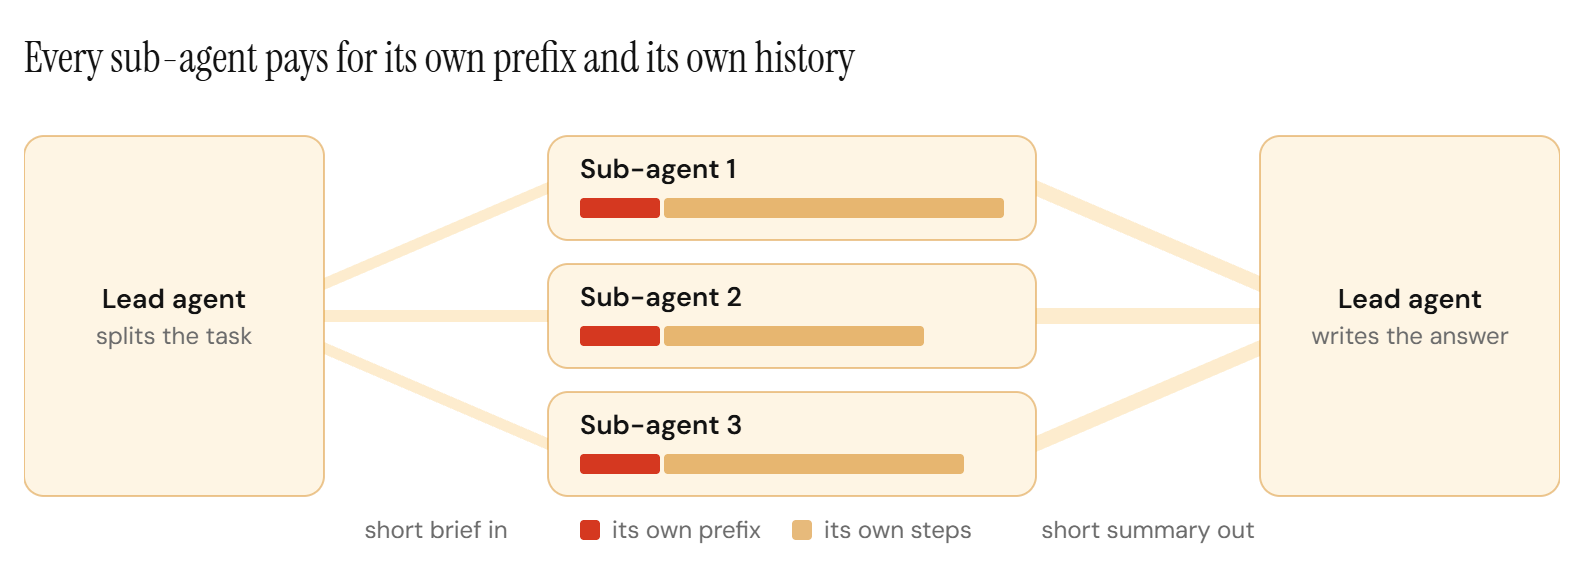
子智能体从全新的上下文开始:它自己的前缀、自己的任务说明和自己的历史。把任务分发出去,会把前缀和历史乘以子智能体的数量,主智能体随后还要为读取返回的内容付费。Anthropic 的研究系统就是参照案例:它的多智能体运行用掉的 token 约为一次聊天的 15 倍,Anthropic 也写道,多智能体系统需要的是价值足够高、付得起性能提升的任务。
- 只在真正能并行的大范围工作上使用子智能体,例如调研几个相互独立的来源。顺序进行的工作放在单个智能体里更便宜。
- 每个子智能体只配它的工作需要的工具,因为工具集越小,它每一步的前缀就越小。
- 让子智能体返回精简后的结果。大的输出写入存储,只传一个引用,这样主智能体的上下文能保持精简。
- 限制每次运行的子智能体数量,并让每个子智能体都接受同样的步数和花费检查。
为每一步选择模型
大多数智能体在每一步都用同一个模型,尽管各步并不相同。规划思路和写出最终答案,需要您负担得起的最强模型。中间的许多步骤都是常规操作:选下一个工具、从结果中提取字段、给文档分类、判断某项检查是否通过。
这些常规步骤正是便宜档位划算的地方。截至 2026 年 10 月,Claude Haiku 4.5 每个 token 的价格是 Claude Opus 5 的五分之一,每百万输入和输出 token 分别为 1 美元和 5 美元,对比 5 美元和 25 美元;GPT-6 Luna 的价格则是 GPT-6 Astra 的百分之一。在步骤层面测试:给每一步标上步骤类型并记录下来,把每种类型抽样拿到更便宜的档位上重放,只迁移能通过的步骤类型。拆分之后,按模型分别测量缓存命中率。我们的 LLM 路由策略指南介绍了如何安全地迁移这部分流量。
定制模型在智能体中处于什么位置?
生产环境中的智能体每天会把同样几种步骤类型重复成千上万次。它给请求分类、提取字段、决定下一步行动、分派案例。每一种都是一项范围窄、输出可检查、流量稳定的任务,而这正是为该任务训练的模型能以前沿模型价格的一小部分提供服务的情形。
延迟在智能体中同样会累积。每一步都要等模型回答,所以把某类步骤缩短几秒,这类步骤在一次运行中出现几次,整次运行就缩短几次。
这正是自适应模型端点要做的事。自适应模型端点是为您的某一项任务提供的单一 API 端点:起初由前沿模型回答,用您的请求和团队反馈训练出的定制模型在通过您的评估集后接手,难的案例继续留在前沿模型上。在智能体中,每一种常规步骤类型都有自己的端点。
规划和最终答案可以始终留在前沿模型上,智能体保留了判断力,而重复的步骤变得更便宜。
对智能体的代码来说,改动只是那一步 API 调用里的一个模型名称。定制模型的每个新版本都会在后台用真实请求运行,并按您的评估集打分,没有您的批准,什么都不会切换。我们会监控模型,并随着您的任务变化重新训练。模型可以由我们托管运行,也可以部署在您的云或本地,并且归您所有。该端点目前仅限受邀企业使用,我们正在开发一个更简化的版本,让更多企业可以接入。
在我们的 QMSum 研究中,一个为查询式会议摘要训练的 1.2B 模型,估算的服务成本为每次查询 0.00053 美元;按同步调用标价,Claude Opus 5 为 0.104 美元,GPT-5.6 Luna 为 0.0130 美元。它 0.39 秒给出回答,而 Claude Opus 5 需要 9.0 秒。这个估算不含训练成本,而且每项任务都不一样,所以每一次切换都要以您自己的评估集为准。某项具体任务的盈亏平衡计算,见定制模型何时在成本上胜过前沿 API。
这些修复应该按什么顺序来做?
- 先做好测量:每次运行的账本、每次成功运行的成本、中位数和 p95。
- 裁剪并结构化工具输出,它通常是一次运行中最大的一项。
- 缓存静态前缀,并修好提示中任何会破坏缓存的地方。
- 加上步数、花费和循环上限,每一项都以交接结束。
- 在长运行中清理或压缩旧的工具结果。
- 收紧子智能体的范围,把常规步骤类型交给能通过分步评估集的更便宜档位。
- 为调用量最大的步骤类型配一个专属模型。
每做一项改动就重新跑一遍账本,把每次成功运行的成本和成功率放在一起看。一项会降低成功率的节省,通常花掉的比省下的还多。
常见问题
AI 智能体比聊天多用多少 token?
根据 Anthropic 在 2025 年 6 月公布的数据,智能体通常比聊天交互多用约 4 倍的 token,多智能体系统多用约 15 倍。这个倍数来自循环:每一步都会重新发送前缀和之前所有步骤的完整历史。
什么最推高 AI 智能体的 token 成本?
被重新发送的上下文。工具结果和静态前缀在每一步都会再计费一次,所以输入 token 通常占智能体账单的大部分。在本指南的示意运行中,按截至 2026 年 10 月 Claude Opus 5 的标价,输入占成本的 93%。
提示缓存对 AI 智能体有用吗?
智能体正是它的最佳场景,因为同样的系统提示和工具定义会在几分钟内的每一步被重新发送。保持工具定义固定且顺序不变,把可变数据放在系统提示之外,并且要预料到清理旧的工具结果会让从该处开始的缓存历史失效。
如何防止智能体跑出一大笔账单?
在每次 API 调用之前检查步数上限和花费上限,停掉重复请求同一工具的运行,并让每一次被停止的运行都以交接给人工或更简单路径的方式结束。根据成功运行的 p95 设定上限,并在智能体改动时重新审视。
智能体的每一步都应该用同一个模型吗?
规划和最终答案通常需要最强的模型,而提取、分类这类常规步骤往往在更便宜的档位上就能通过。用各自的评估集测试每种步骤类型,只迁移能通过的类型。
什么时候在智能体中使用定制模型才合理?
当某一种步骤类型每天运行成千上万次、它的输出可以自动检查,而且任务每周保持稳定的时候。这些步骤可以迁移到为它们训练的模型上,放在自适应模型端点之后,同时由前沿模型继续处理难的案例。
简短版
智能体的成本主要是每一步都被重新发送的上下文。用中位数和 p95 测量每次成功运行的成本,裁剪并结构化工具输出,缓存静态前缀,清理旧结果,为每次运行设上限并干净地交接,同时收紧子智能体的范围。然后把您的智能体重复最多的常规步骤类型交给更便宜的模型,先从为最繁忙的那一类训练的模型开始。
如果某个智能体步骤占据了您账单的大头,预约通话,我们和您一起看看。
资料来源:Anthropic, How we built our multi-agent research system、Anthropic 上下文编辑、Anthropic 压缩、Anthropic 任务预算、Anthropic 提示缓存、Anthropic 定价和 OpenAI API 定价。价格和功能核实于 2026 年 10 月 6 日。