


效果最大的 LLM 成本优化技术依次是:用定制模型承接高流量任务、为每项任务选对模型规格、在模型之间路由请求、把可以等待的工作改用批处理,以及提示缓存。先把单任务成本测量起来,因为下面每一项技术都要用这个数字来衡量。
本指南按每项技术在其覆盖流量上的节省幅度,对 12 种技术排序,并给出各自的实施投入和质量风险。价格均为 OpenAI 和 Anthropic 截至 2026 年 10 月的标价。同一问题的管理视角,见如何降低企业的 AI token 成本。
什么是 LLM 成本优化?
LLM 成本优化,是在把质量保持在约定标准的前提下,降低每项已完成任务的模型使用成本:发送更少的 token,把 token 发给更便宜的模型,或者以更低的费率为它们付费。需要管理的单位是单任务成本,因为一个需要重试三次的便宜模型,可能比一次成功的昂贵模型花得更多。
每项技术都作用于任务成本中的某一项:
单任务成本 = 对该任务的每次 API 调用求和:
    未缓存的输入 token x 输入价格
  + 已缓存的输入 token x 缓存价格
  + 输出 token         x 输出价格   (推理 token 计入输出)
下表列出每一项由哪些技术来压缩。
| 成本项 | 压缩它的技术 |
|---|---|
| 每项任务的 API 调用次数 | 智能体步数限制、响应缓存 |
| 每次 API 调用的输入 token | 上下文裁剪、历史压缩、提示压缩 |
| 每个输入 token 的价格 | 提示缓存、批处理、更便宜的档位 |
| 每次 API 调用的输出 token | 输出上限、结构化输出、推理强度 |
| 每个输出 token 的价格 | 批处理、更便宜的档位、定制模型 |
由于这些技术作用于不同的成本项,它们的节省会相乘。缓存前缀、限制输出、换用更便宜的档位,三者可以在同一次 API 调用上叠加。
如何测量 LLM 的单任务成本?
在每次 API 调用时记录 token 用量,附上任务 ID 和任务类型,再按已完成的任务汇总。两家服务商都会在每次响应中返回用量,所以几行代码就够了:
# 每百万 token 的美元价格,截至 2026 年 10 月的标价。
PRICES = {
    "claude-opus-5": {"input": 5.00, "cache_read": 0.50, "cache_write": 6.25, "output": 25.00},
    "gpt-6-luna": {"input": 0.10, "cache_read": 0.01, "cache_write": 0.125, "output": 0.50},
}

def api_call_cost(model, uncached_in, cache_read, cache_write, output):
    p = PRICES[model]
    return (
        uncached_in * p["input"]
        + cache_read * p["cache_read"]
        + cache_write * p["cache_write"]
        + output * p["output"]
    ) / 1_000_000
在相信总数之前,先弄清每家服务商如何统计缓存 token。Anthropic 的提示缓存文档中,input_tokens 只统计最后一个缓存断点之后的 token,cache_read_input_tokens 和 cache_creation_input_tokens 另外列出,所以输入总量是三者之和。检查其他服务商的用量字段,看缓存 token 是包含在输入计数里还是单独列出,否则仪表盘会重复计算。
报告单次成功任务的成本:一项任务发出的所有 API 调用的成本,包括重试和升级,除以达到质量标准的任务数。下面每一项技术,要推动的都是这个数字。
哪些 LLM 成本优化技术省得最多?
下面的排名按每项技术在其覆盖流量上的节省幅度排序。您的总节省取决于每项技术能覆盖多少流量。
| 排名 | 技术 | 对覆盖流量的节省 | 投入 | 质量风险 |
|---|---|---|---|---|
| 1 | 为高流量任务使用定制模型 | 在我们的研究中最高 99% | 高 | 由评估关卡把关 |
| 2 | 为任务选对模型规格 | 档位间价差 10 到 100 倍 | 低 | 中,需要评估集 |
| 3 | 路由与级联 | 取决于下放的流量比例 | 中 | 中 |
| 4 | 批处理 | 输入和输出各省 50% | 低 | 无 |
| 5 | 提示缓存 | 缓存输入省 90% 或更多 | 低 | 无 |
| 6 | 输出上限与结构化输出 | 输出价格是输入的 5 倍 | 低 | 低 |
| 7 | 控制推理强度 | 计费的思考 token 更少 | 低 | 中 |
| 8 | 上下文裁剪与检索调优 | 与删去的 token 成正比 | 中 | 中 |
| 9 | 历史压缩 | 随对话长度增长 | 中 | 低到中 |
| 10 | 智能体步数与工具输出限制 | 因工作流而异 | 中 | 低 |
| 11 | 响应缓存 | 重复请求的全部成本 | 中 | 低 |
| 12 | 提示压缩 | 较小,仅限指令部分 | 低 | 低 |
第 4 到第 7 项是配置调整,大多数团队一周内就能上线。第 1 到第 3 项会改变由哪个模型来干活,所以在移动任何流量之前,都需要先有评估集。
1. 用定制模型承接高流量任务
当某一项任务,例如工单分诊、文档抽取或通话摘要,占了 API 调用的很大一部分时,为这项任务训练的模型能以前沿模型成本的一小部分来承接它。为单一工作训练的模型只携带这项工作需要的能力,所以每个 token 的服务成本更低,响应也更快。
在我们的 QMSum 研究中,一个为查询式会议摘要训练的 1.2B 模型,在一块租用的云 GPU 上估算的服务成本为每次查询 0.00053 美元;按同步调用标价,Claude Opus 5 为 0.104 美元,GPT-5.6 Luna 为 0.0130 美元。它在单块 GPU 上 0.39 秒给出回答,而通过 API 调用 Claude Opus 5 需要 9.0 秒。这个估算不含训练成本,而且质量因任务而异,所以下文的切换要以您自己的评估集为准。
这是清单上投入最大的一项,因为它需要一项稳定的任务、足够用来学习的真实流量、一个定义标准的评估集,以及一种安全迁移流量的方式。下文关于高流量任务何时值得拥有专属模型的一节,会讨论这个决定。
2. 为每项任务选对模型规格
档位之间的价差,是大多数团队还没动用的最大杠杆。以下是截至 2026 年 10 月当前产品线每百万 token 的标价。
| 服务商 | 模型 | 输入 | 输出 |
|---|---|---|---|
| OpenAI | GPT-6 Astra | $10.00 | $50.00 |
| OpenAI | GPT-6.1 Sol | $2.00 | $10.00 |
| OpenAI | GPT-6 Luna | $0.10 | $0.50 |
| Anthropic | Claude Fable 5.1 | $10.00 | $50.00 |
| Anthropic | Claude Opus 5 | $5.00 | $25.00 |
| Anthropic | Claude Sonnet 5.5 | $2.00 | $10.00 |
| Anthropic | Claude Haiku 4.5 | $1.00 | $5.00 |
在每条产品线里,最高档每个输出 token 的价格是最低档的 10 到 100 倍,所以一项能在较低档位上通过的任务,只改一行代码就能省下一大笔。
方法是评估集:几百条带有已知正确输出的真实输入,加上一条评分规则。让每个候选档位都跑一遍,选出达到标准的最便宜档位;每当服务商发布新模型,就重跑一次评估集,因为能通过的最便宜档位会随每次发布而变化。
3. 路由请求,或采用级联
路由是按任务标签或分类器,预先为每个请求选定模型。级联则先尝试便宜的模型,当答案未通过校验或置信度检查时,再升级到更强的模型。
级联的算术很简单。如果便宜模型的成本是强模型的 5%,并把 30% 的请求升级,期望成本就是 0.05 + 0.30 = 0.35,即全部交给强模型时成本的 0.35,节省 65%。升级率越高,节省越少,所以要按任务类型分别测量。
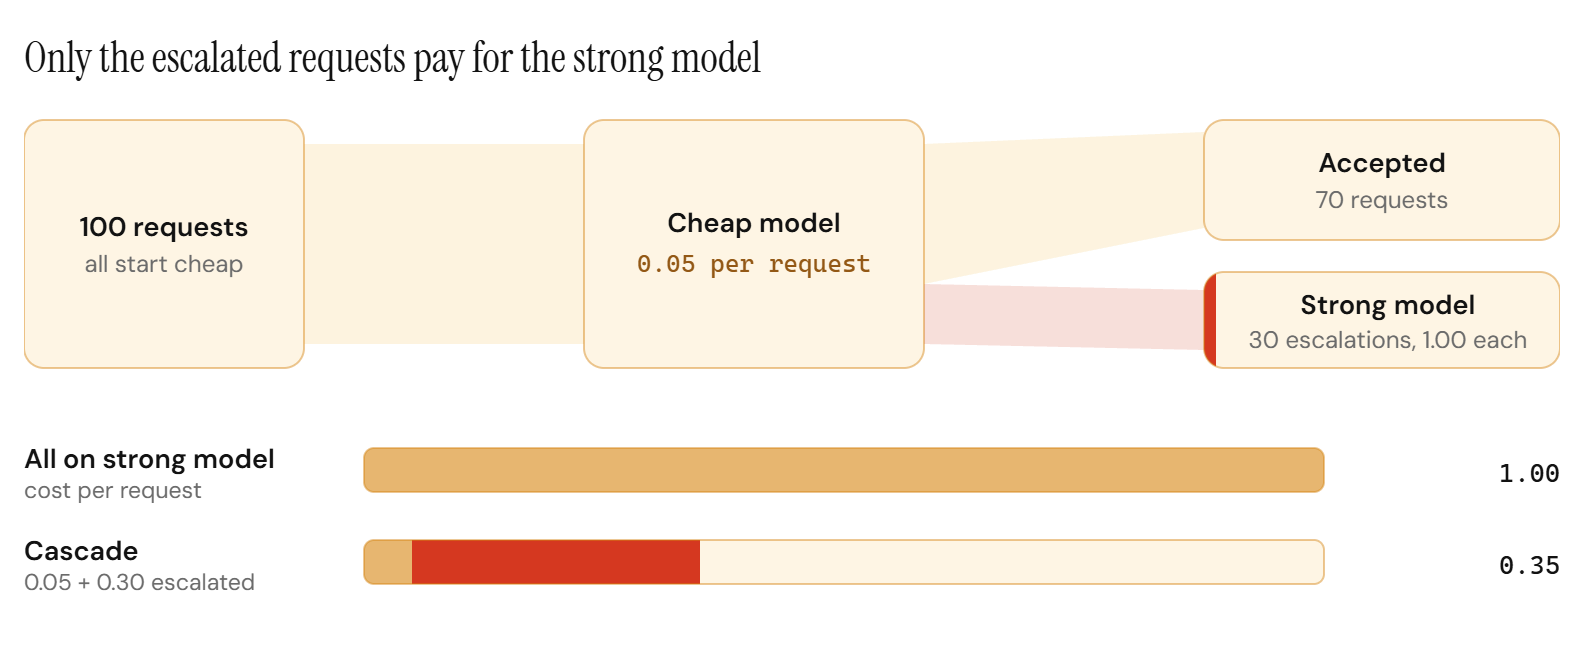
先按明确的任务标签路由,例如用请求头标注,或为工作流的每一步单独设一个端点;等积累了带标签的流量、可以用来训练和衡量时,再加入学习型路由器。一次路由错误会损失质量,而预测难度本身就是一个难题。我们之前关于 SLM 优先的 80/20 路由模式和如何在微调模型、API 与 RAG 之间选择的文章,对架构有更深入的讨论。如需并列比较各种路由策略,以及如何安全地把流量迁到更便宜的模型,请看LLM 路由策略:降低前沿模型 API 成本。
4. 能等的工作,一律批处理
截至 2026 年 10 月,OpenAI 和 Anthropic 的批处理价格都是标准输入和输出费率的 50%,OpenAI 还把 GPT-6 产品线的 Flex 档定在与 Batch 相同的价格。评估运行、历史数据回填、夜间摘要、数据补全任务和积压内容分类都适用。
工程上的代价是异步管道:把请求写入一个带稳定自定义 ID 的文件,提交后轮询状态或接收 webhook,再核对结果并重试部分失败。让每个请求保持幂等,这样重试永远不会把一个结果写两遍。
5. 缓存稳定的前缀
提示缓存会把提示中已经处理过的前缀存起来,之后共享这段前缀的 API 调用按缓存费率计费。截至 2026 年 10 月,Anthropic 对大多数 Claude 模型的缓存命中按基础输入价格的 0.1 倍计费,5 分钟缓存的写入为 1.25 倍,1 小时缓存为 2 倍。OpenAI 对 GPT-6 Astra 和 GPT-6 Luna 的缓存输入按标准输入的十分之一计价,缓存写入为 1.25 倍。
按这些倍数,缓存从第一次复用起就开始回本:两次未缓存的 API 调用花费 2.0 个单位的输入,而一次写入加一次命中只花 1.25 + 0.1 = 1.35。
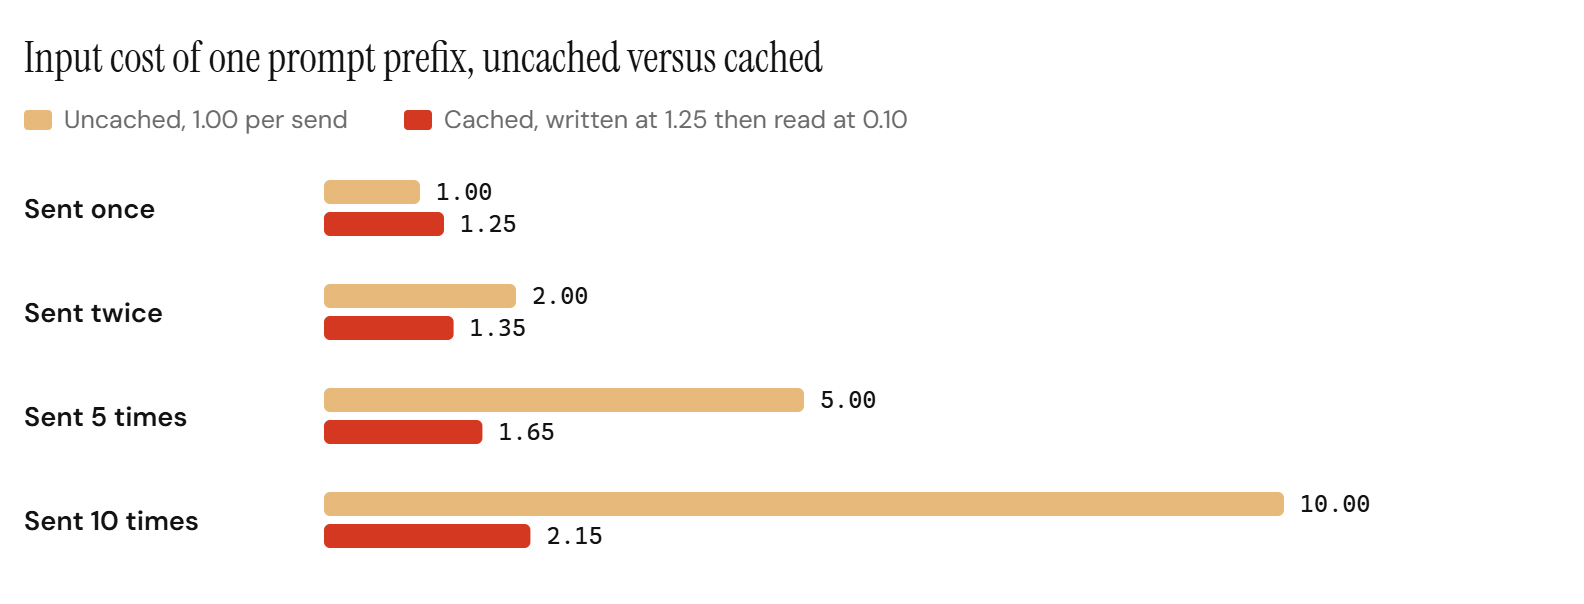
要提高命中率:
- 把稳定内容放在前面:系统提示、工具定义、参考文档。把可变内容放在最后。
- 时间戳、请求 ID 和按用户变化的数据不要放进前缀,因为任何改动都会让其后的所有内容失效。
- 工具定义保持固定顺序。
- 检查最小可缓存长度。Anthropic 的文档列出 Claude Opus 5 为 512 个 token,所以过短的提示永远不会被缓存。
- 按任务类型跟踪缓存命中率,因为一次调整了提示顺序的重构,可能悄无声息地把命中率降到零。
缓存改变的是输入的价格,输出不受影响。当单靠缓存已经不够时,我们关于从提示缓存转向微调的文章介绍了下一步。
6. 限制输出,使用结构化输出
在两家服务商当前的产品线上,输出 token 的价格都是输入的五倍:Claude Opus 5 为 5 美元和 25 美元,GPT-6 Luna 为每百万 0.10 美元和 0.50 美元。为每次 API 调用设置最大输出长度。当消费结果的是代码时,要求返回字段简短、使用枚举值的 JSON schema。如果只用到最终标签,就从生产提示中删掉“解释你的推理过程”这类指令。
7. 控制推理强度
OpenAI 的推理指南说明,推理 token 按输出 token 计费,尽管 API 从不返回它们;Anthropic 也把思考 token 计入计费的输出。用评估集逐一测试每个推理强度或思考预算,选用能通过的最低设置。
OpenAI 的 max_output_tokens 同时限制推理和可见输出,其指南提醒,响应可能在产生任何可见输出之前就停止,却仍然对输入和推理 token 计费。给上限留出余量,并监控未完成的响应。
8. 裁剪上下文,调优检索
提示中的每个 token,在每次 API 调用中都会计费。对于检索流水线,先广泛召回,再重排序,只发送排名最靠前的几个片段。去掉相互重叠的片段,并在建立索引之前,删除源文档中的导航文字、页眉和标记等样板内容。
长上下文窗口让人很容易忽视这一点。截至 2026 年 10 月,Anthropic 对其完整的 1M token 上下文按标准的每 token 费率计费,所以一个 90 万 token 的请求,成本是一个 9000 token 请求的一百倍。上下文变长还会在窗口填满之前很早就降低回答质量,详见有效上下文长度问题。
9. 压缩对话和智能体的历史
聊天产品和智能体在每一轮都会重新发送整段对话。如果每一轮新增的 token 数差不多,一段对话的总输入就会随对话长度的平方增长,因为第 n 轮要重新发送之前的全部 n 轮。
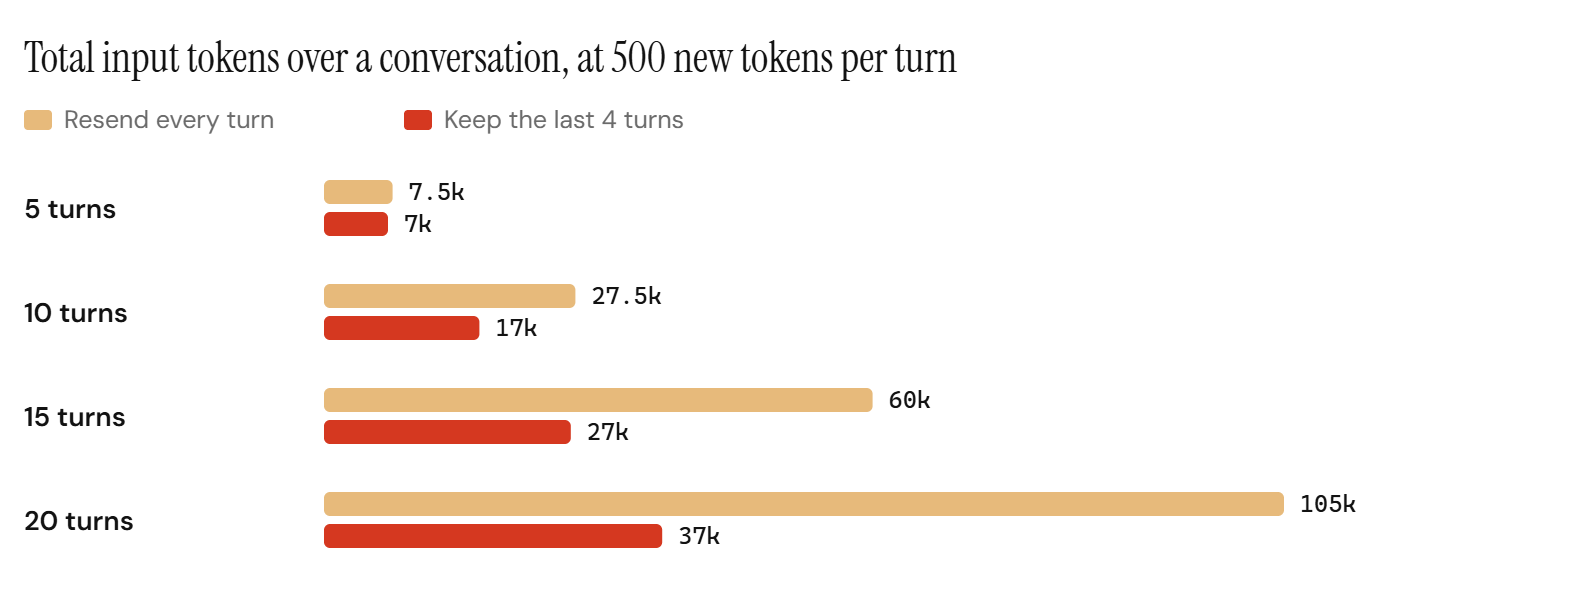
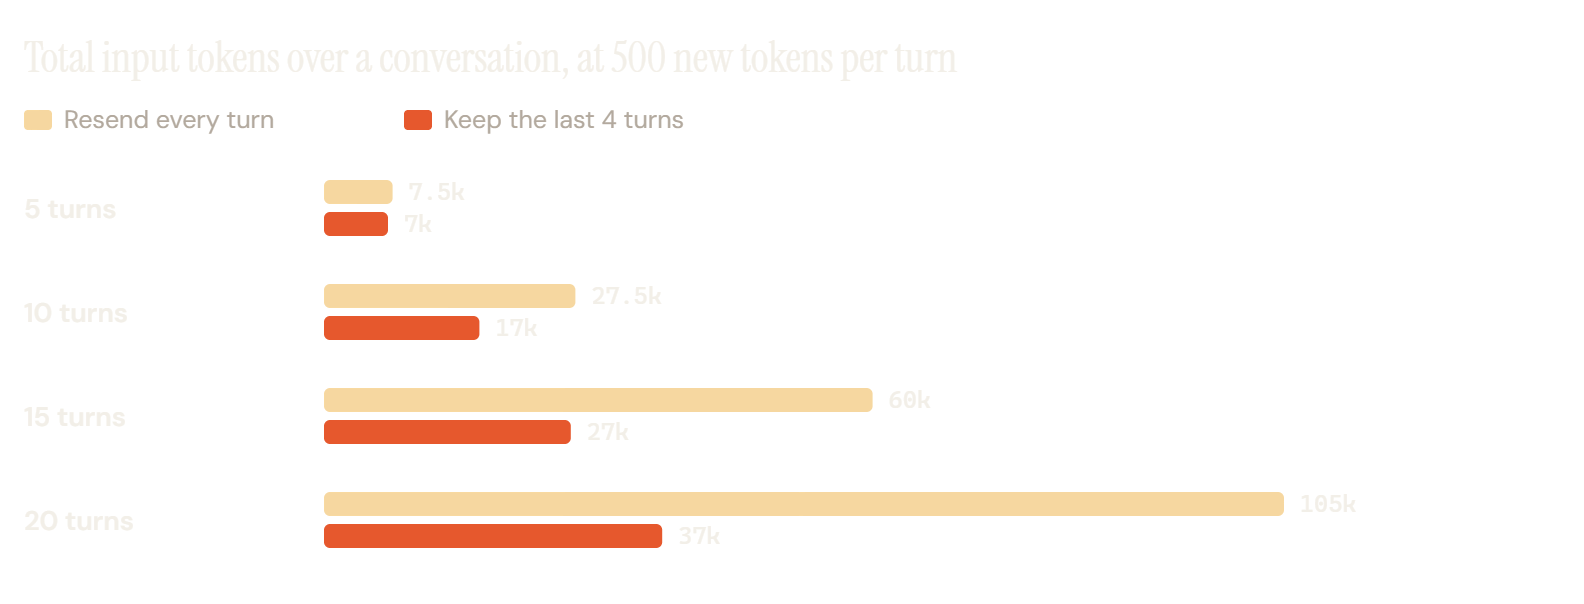
保留一个近期轮次的滑动窗口,把较早的轮次总结成一段简短的状态块,并在智能体用完工具输出后将其丢弃。缓存能降低重复发送历史的价格,但 token 数量仍在增长,所以在长会话中,压缩依然值得做。
10. 限制智能体步数和工具输出
智能体每次运行的长度差异很大,账单主要由长尾驱动。限制每次运行的步数,设定每次运行的 token 预算,任一上限被触及时就以交接方式结束运行。在工具端就截断工具输出:只返回匹配的行、相关的函数或排名靠前的结果,绝不返回整个文件或整张表。把每次成功运行的 token 数和成功率一起记录,这样一次让运行变长的提示改动,在上线当天就能被发现。我们的指南智能体 AI 成本优化把这些做法逐步应用到一次完整的智能体运行上。
11. 为重复请求缓存完整响应
当同一个请求反复出现,例如常见问题的回答或对已知输入的分类,就直接返回已存储的响应,完全跳过 API 调用。用规范化后的输入、模型和提示版本作为缓存键,并在任一版本变化时让缓存失效。
语义缓存通过嵌入相似度匹配近似重复的请求,可以提高命中率,代价是偶尔会把另一个问题的答案返回出去。使用严格的相似度阈值,并只在近似匹配也能接受的工作负载上使用。
12. 压缩提示
更短的指令和更少的少样本示例,能在每次 API 调用中减少输入 token。节省是真实的,但不多;如果前缀已经按十分之一的价格缓存,节省就更少。在缓存之后再做,并在每次删减后重跑评估集,因为少样本示例对质量的贡献,往往比它们的长度所显示的更大。
高流量任务什么时候值得拥有自己的模型?
当一项任务的流量高且稳定、好输出的定义不变,并且评估集可以自动为它打分时,它就值得拥有自己的模型。比较时要用您实际会支付的前沿模型价格,包括异步工作可享受的批处理折扣,因为那才是真正的替代方案。盈亏平衡的计算见定制模型何时比前沿 API 更省钱。
| 信号 | 指向定制模型的情况 |
|---|---|
| 流量 | 单一任务每天数千次 API 调用 |
| 稳定性 | 每周的输入和输出格式相同 |
| 可衡量性 | 有能自动为输出打分的评估集 |
| 延迟 | 响应时间对用户很重要 |
| 数据位置 | 必须留在您的云或本地 |
当这些信号大多具备时,剩下的问题就是模型长期运行的成本。定制模型是一条需要持续运营的流水线:收集和整理训练数据、训练、评估每个候选版本、提供服务、监测漂移,并随着任务变化重新训练。训练本身只是其中较小的一部分。
自适应模型端点替您运营这条流水线。自适应模型端点是为您的某一项任务提供的单一 API 端点:起初由前沿模型回答,用您的请求和团队反馈训练出的定制模型在通过您的评估集后接手,难的案例继续留在前沿模型上。
新版本上线时,您的应用代码保持不变,因此重新训练不需要您这边做任何部署。
具体来说:
- 您只需改一个模型名称,把任务指向这个端点。起初由前沿模型处理所有请求,所以不会有任何工作等待训练。
- 定制模型的每个新版本都会在后台用真实请求运行,并按您的评估集打分。
- 未经您的批准,什么都不会切换。版本通过后,越来越多的请求转给它,难的案例继续留在前沿模型上。
- 我们监控模型,并随着您的任务变化重新训练,每个新版本都要通过同样的关卡。
模型可以由我们托管运行,也可以部署在您的云或本地,并且归您所有。该端点目前仅限受邀企业使用,我们正在开发一个更简化的版本,让更多企业可以接入。
常见问题
降低 LLM 成本最快的方法是什么?
批处理和提示缓存,因为两者都是不影响输出质量的配置调整。截至 2026 年 10 月,OpenAI 和 Anthropic 的批处理便宜 50%,而在大多数当前模型上,缓存输入按标准输入价格的十分之一或更低计费。
提示缓存能降低输出成本吗?
提示缓存只降低重复输入 token 的价格。输出 token,包括推理 token,都按完整的输出费率计费,所以要把缓存与输出上限、以及用评估集测试过的推理强度设置结合起来。
更便宜的模型按任务算一定更便宜吗?
更便宜的模型按 token 算确实更便宜,但按任务算要看重试和升级。一个需要多次尝试、或把大部分请求升级给更强模型的模型,可能会失去优势。要测量单次成功任务的成本,并计入每一次重试和升级。
定制模型的服务成本和前沿 API 相比如何?
在我们的 QMSum 研究中,一个为会议摘要训练的 1.2B 模型,估算的服务成本为每次查询 0.00053 美元;按同步调用标价,Claude Opus 5 为 0.104 美元,GPT-5.6 Luna 为 0.0130 美元。这个估算不含训练成本。您的数字取决于模型规模、流量大小,以及服务硬件的利用程度。
这些 LLM 成本优化技术可以组合使用吗?
大多数可以叠加,因为它们作用于成本公式中的不同项。缓存降低输入的价格,输出上限减少输出 token,选对模型规格则同时降低两者的价格,所以节省会在同一次 API 调用上相乘。
运行定制模型需要机器学习团队吗?
自己运行需要数据整理、训练、评估、服务和重新训练,对团队来说是实打实的投入。使用自适应模型端点时,由 Ertas 运营这条流水线,您的工程师只需改一个模型名称,您的团队按自己的评估集批准每一次切换。
简短版
在优化任何东西之前,先测量单次成功任务的成本。先拿下配置层面的收益:能等的工作批处理,缓存稳定的前缀,限制输出和推理。然后把每项任务交给能通过评估集的最便宜模型,再为调用量最大的任务配一个专门训练的模型。
如果某一项任务占据了您 token 账单的大头,预约通话,我们和您一起评估。
资料来源:OpenAI API 定价、Anthropic 定价、Anthropic 提示缓存文档和 OpenAI 推理指南。价格核实于 2026 年 10 月 6 日。