


AI token 预算是一笔按月计算的 AI 用量支出额度,按团队或按任务设定,以美元计量。它由三部分组成:每位员工所用 AI 工具的默认用量额度;成本展示(showback),让每个团队看到自己的花费;以及为产品中每个工作负载设定的单任务成本预算。
2026 年,token 预算成了管理层的议题。据 Quartz 报道,Uber 的 CTO 在 4 月表示,公司 2026 年的 Claude Code 预算在开年四个月后就已用完。6 月,彭博社报道,Uber 现在把每位员工在每款 AI 编程工具上的 token 支出限制在每月 1,500 美元,沃尔玛也已限制员工对其内部 AI 智能体的使用。
钱花完之后才加上的上限,是 token 预算最粗放的版本。本指南讲的是有计划的版本:预算什么、在哪个层级设定,以及如何让预算成为有用工作的护栏。它建立在如何降低企业的 AI token 成本的基础上,那篇文章讲的是 token 花在了哪里,以及哪些手段能把它降下来。
什么是 AI token 预算?
AI token 预算是一个团队或一项任务每月可以花在 AI 模型用量上的金额,以美元设定,同时用美元和 token 两种单位汇报。用美元做单位,是因为 token 的价格差距太大。截至 2026 年 10 月,GPT-6 Astra 的一个输出 token 价格是 GPT-6 Luna 的 100 倍,所以一百万个输出 token 可能花 0.50 美元,也可能花 50 美元,取决于所用的模型。
您的 AI 支出分为两类,每一类都需要自己的预算。
| 席位工具预算 | 工作负载预算 | |
|---|---|---|
| 覆盖范围 | 聊天助手、编程智能体、各类 Copilot | 产品功能、自动化流程、内部智能体 |
| 单位 | 每人每月的美元金额 | 每完成一项任务的美元金额 |
| 随什么增长 | 人数和使用习惯 | 业务量 |
| 负责人 | 各团队经理 | 产品或工程负责人 |
| 主要控制手段 | 用量额度和默认模型 | 单任务成本 |
大多数管理者最先在席位工具上感受到压力,因为用量取决于每个人的工作方式。随着 AI 进入产品,越来越多的钱流向工作负载,因为一个功能每小时就可能发出成千上万次 API 调用,全程不需要任何人输入提示词。
如何为每个团队设定 AI token 预算?
从实测用量出发,按角色设定额度,把更便宜的模型设为默认,并提前决定达到上限时怎么办。
1. 先测出基线,再定数字。 打开用量报告,放宽上限,运行一到两个月,然后按人员、工具和模型查看支出。截至 2026 年 10 月,Anthropic 的 Claude Code 文档给出的企业部署平均成本是每位开发者每月 150 至 250 美元,90% 的用户每个活跃日低于 30 美元。据 Quartz 报道,Uber 的数字也在同一区间,用量最大的员工每月 500 至 2,000 美元。把公开的平均值当作核对自家数字是否合理的参照。
2. 按角色设定额度。 全公司统一一个数字,对使用编程智能体的工程师来说太紧,对一天只打开几次聊天助手的员工来说又太松。
| 角色群体 | 主要 AI 用途 | 额度怎么定 |
|---|---|---|
| 大多数员工 | 聊天和写作辅助 | 席位套餐自带的用量 |
| 分析和运营人员 | 长文档和研究 | 实测中位数加一定余量 |
| 软件工程师 | 编程智能体 | 每款工具一个月度预算 |
| 自动化流程负责人 | 定时智能体和数据管道 | 按任务计算的工作负载预算 |
Uber 的上限是工程师这一行很好的参照。每款工具每月 1,500 美元,比常见的 150 至 250 美元高出六到十倍,所以它削掉的是长尾,日常使用不受影响。
3. 把更便宜的模型设为默认。 席位工具账单的很大一部分,取决于没人选择时工具默认用哪个模型。编程默认用中档模型,简单聊天默认用低档模型,顶级模型留给难题,作为有意识的选择。Anthropic 的文档把 Claude Code 支出意外偏高归因于两个习惯:长时间会话从不清空,以及把 Opus 留作默认模型。
4. 写明达到上限时怎么办。 决定额度用完的人是等待重置、换用更便宜的模型,还是申请更多额度,并把申请流程控制在一天以内。截至 2026 年 10 月,工具已经支持这样做:Claude Team 和 Enterprise 套餐的成员可以在 Claude Code 里直接向管理员申请更多用量,Cursor Enterprise 和 GitHub Copilot 则允许管理员按人设定上限。
长时间自主运行的智能体任务也照此处理。一次要跑好几个小时、或者拆分给许多并行智能体的任务,值得快速审批,并配一份单独的预算。Anthropic 的文档指出,当队友在规划模式下运行时,Claude Code 智能体团队消耗的 token 约为普通会话的七倍。我们的智能体 AI 成本优化指南介绍了工程师如何把这个数字降下来。
如何避免 token 预算拖慢团队?
当每个人都能看到自己的花费、上限高于日常用量、申请更多额度只需一天以内时,token 预算才能发挥作用。三种做法可以做到这一点。
先做成本展示,再做成本分摊。 成本展示(showback)是指每月把各团队的 AI 支出按人员、工具和模型汇报给该团队,而资金仍留在中央预算里。成本分摊(chargeback)则把费用转入团队自己的预算。先从成本展示开始,因为可见性本身就会改变习惯。据 Quartz 报道,Uber 的 COO 观察到,从来看不到发票的工程师,可能会把 AI 工具当成几乎免费的东西。等各团队有了几个月自己的数据、能据此做计划时,再转向成本分摊。
奖励成果,别把 token 用量当成绩。 token 用量排行榜会把花费变成一种身份象征。据彭博社援引 Business Insider 的报道,亚马逊关闭了一个追踪 AI token 用量的内部排行榜,因为它促使部分员工只为冲排名而运行任务。在汇报支出时,把各团队交付了什么、单任务成本是多少一并列出。
每月复盘,三十分钟。 一场会,一张表,由预算负责人主持。
| 议程 | 要回答的问题 |
|---|---|
| 支出与预算对比 | 哪些团队超支或未用完,原因是什么? |
| 用量最大的用户 | 是值得推广的工作流程,还是失控的循环? |
| 默认模型 | 是否有更便宜的档位通过了团队的测试? |
| 已调高的上限 | 上个月的审批值不值得? |
| 工作负载 | 单任务成本有没有变化? |
用量最大的用户,往往是工作流程最值得学习的人,偶尔也是某个早被遗忘、仍在运行的定时任务的主人。两种情况都值得找出来。
如何减少 Claude Code、Cursor 和 Copilot 的 token 用量?
教团队几个会话习惯,默认使用中档模型,并用好各家厂商现在提供的支出控制。对大多数工程团队来说,编程智能体是席位工具里最大的一笔开支,因为每条消息都会带上已读取的文件、命令输出和到目前为止的整段对话。
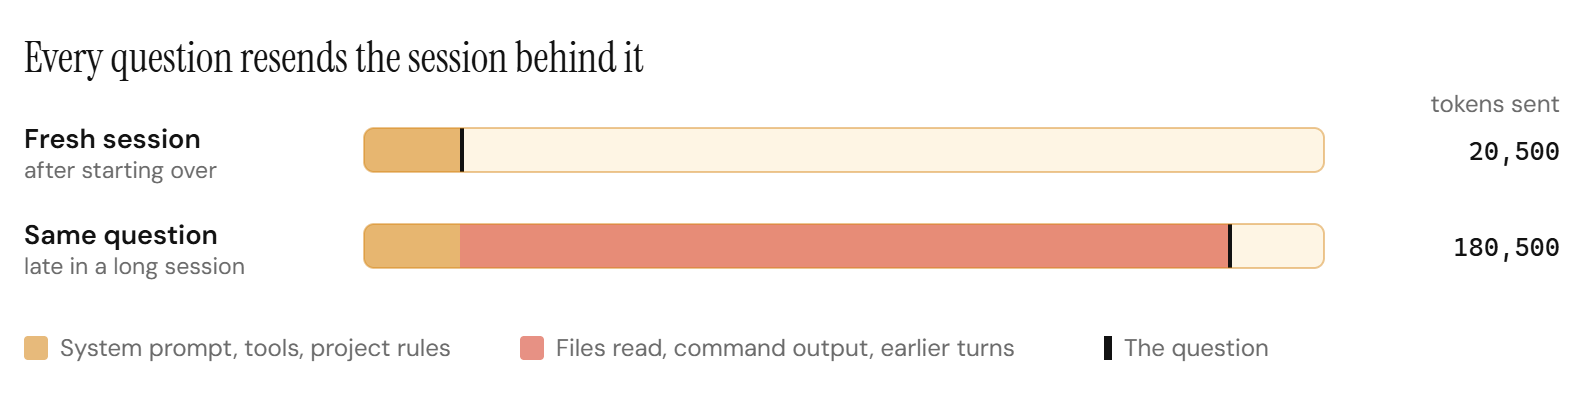
以下习惯来自 Anthropic 的 Claude Code 指南,同样的原则也适用于 Cursor 和 Copilot:
- 在不相关的任务之间开启新会话。 在 Claude Code 里就是
/clear。在开了一整天的会话里问一个一行的问题,仍要为一整天的上下文付费。 - 默认使用中档模型。 把顶级模型留给架构决策和棘手的调试。
- 让始终加载的说明保持简短。 项目规则文件会进入每一次会话。Anthropic 建议把 CLAUDE.md 控制在 200 行以内,并把专门的说明移到只在使用时才加载的 skills 中。
- 简单工作调低推理强度。 思考 token 按输出 token 计费,而输出 token 是最贵的一类。
- 提出具体的修改要求。 要求给某个指定函数加上输入校验,只会读几个文件;要求改进整个代码库,会读很多文件。
- 留意后台任务。 定时循环、并行智能体和智能体团队会在无人看管时继续花钱。
管理端的工具如今已经比较完善。截至 2026 年 10 月,各工具在哪里显示支出、如何设定上限如下。
| 工具和套餐 | 在哪里看支出 | 如何设上限 |
|---|---|---|
| Claude Code,Team 或 Enterprise | 按用户和模型的支出报告 | 按组织、群组或成员设定上限 |
| Claude Code,Console(API) | Console 用量页面和仪表板 | 工作区支出上限 |
| Cursor,Teams | 管理仪表板,按用户 | 一个全团队月度上限 |
| Cursor,Enterprise | 管理仪表板,按用户 | 团队、群组和成员上限 |
| GitHub Copilot,Business 或 Enterprise | 以 AI 积分显示用量 | 按企业、成本中心或用户设预算 |
设定时有三个细节要注意。在 Claude Team 和 Enterprise 套餐上,用量先消耗每个席位自带的额度,支出上限管的是超出额度的部分。自 2026 年 6 月起,GitHub Copilot 对 Business 和 Enterprise 的用量按 token 计费,以每个价值 1 美分的 AI 积分结算,并把各席位自带的积分汇入整个组织的共享池,所以如果不设用户级预算,少数重度用户就可能替所有人把池子用光。Cursor 对超出包含额度的第三方模型用量,按 API 标价另加每百万 token 0.25 美元收费。
如何为 AI 工作负载编制预算?
每个工作负载的预算等于每月任务数乘以单任务成本,告警要设在单任务成本上。总额随业务增长而增长,这通常是好消息。单任务成本上涨,则说明某个环节效率变差了,例如提示词变长、换了更贵的模型,或者智能体多走了几步。
以一个客服工作负载为例:每月分拣 200,000 张工单,每张 0.06 美元,这一项支出是 12,000 美元。
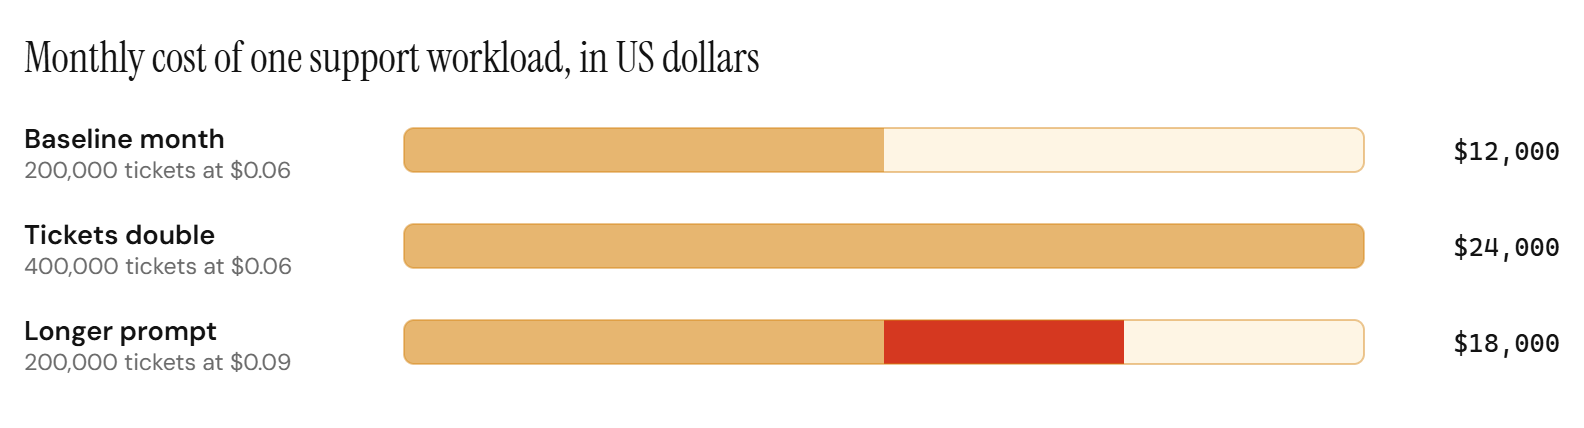
因此,一个工作负载预算有两部分:
- 业务量预测,由业务部门负责,取自预测工单、理赔或订单的同一份计划。
- 单任务成本目标,由工程团队负责,在偏离超过约定幅度(例如 10%)时触发告警。
降低单任务成本先从配置做起:把可以等待的工作改用批处理,缓存重复的上下文,把每项任务换到能通过测试的最便宜的模型,这些手段都在 LLM 成本优化:12 种技术排名中排好了序。我们的单任务成本与 AI 单位经济指南介绍了如何设定目标。
当一项任务占了某个工作负载支出的大头,例如分拣工单或从理赔单中提取字段,更大的手段就是这项任务本身的价格。为这项任务训练的定制模型,可以用低得多的单任务成本处理常规部分,难的案例则继续交给前沿模型。
定制模型在 token 预算中处于什么位置?
定制模型属于预算中的工作负载一侧,适合流量高且稳定、好答案的定义稳定、并且有评估集可以检验的任务。它降低这一项的单任务成本,前沿模型仍留在预算里,处理难的案例和其他所有工作。
这正是自适应模型端点的用途。自适应模型端点是为您的某一项任务提供的单一 API 端点:起初由前沿模型回答,用您的请求和团队反馈训练出的定制模型在通过您的评估集后接手,难的案例继续留在前沿模型上。
定制模型每回答一个请求,这个请求就离开了预算中的前沿模型那一项,而难的请求仍会交给前沿模型。
对预算负责人来说,这意味着三件事。
最大的那一项变小了。 在我们已发表的 QMSum 研究中,一个为会议摘要任务训练的模型,估算的单次查询服务成本为 0.00053 美元,而按同步标价计算,Claude Opus 5 为 0.104 美元,GPT-5.6 Luna 为 0.0130 美元;它的响应时间为 0.39 秒,Claude Opus 5 为 9.0 秒。这一估算不含训练成本,而且每项任务都不同,所以每一次切换都要等您的评估集通过。
这一项变得更可预测。 任务中的常规部分运行在归您所有的模型上,所以当前沿模型的价目表或默认模型变化时,它的单任务成本保持不变。
控制权在您的团队手里。 每个新版本都会先在后台用真实请求运行,未经您的批准,什么都不会切换。我们监控模型,并随着您的任务变化重新训练它。模型可以由我们托管运行,也可以部署在您的云或本地,并且归您所有。该端点目前仅限受邀企业使用,我们正在开发一个更简化的版本,让更多企业可以接入。
关于这一项如何与明年计划中的其他部分放在一起,请见我们的企业 AI 预算规划指南。
常见问题
什么是 token 预算?
token 预算是对一个人、一个团队或一项任务在一段时间内(通常是一个月)可以花在 AI 模型用量上的金额所设的限额。它以美元设定,因为不同模型的 token 价格最多相差 100 倍;同时用美元和 token 两种单位汇报,让团队看清是什么推高了支出。
每位员工的 AI 工具预算应该定多少?
根据自己实测的用量,按角色来定。作为参照,截至 2026 年 10 月,Anthropic 报告的企业部署中 Claude Code 平均成本为每位开发者每月 150 至 250 美元,而 Uber 把智能体编程工具的上限定为每位员工每款工具每月 1,500 美元。大多数非工程岗位的员工需要的要少得多,往往席位套餐自带的用量就够了。
token 预算应该用 token 还是美元来设定?
用美元设定,同时汇报两种单位。一百万个输出 token 可能花 0.50 美元,也可能花 50 美元,取决于模型,所以以 token 计的预算很难反映成本。token 数在报告里仍然有用,因为它能说明支出上涨是因为用得更多,还是因为换了更贵的模型。
token 预算会拖慢我们的工程师吗?
设定得当的预算高于日常用量,所以大多数工程师永远碰不到它。Uber 每款工具 1,500 美元的上限,是 Anthropic 报告的 Claude Code 常见月度成本的六到十倍。给上限配上快速的申请流程和成本展示,并避免奖励 token 用量,因为那会助长浪费。
成本展示和成本分摊有什么区别?
成本展示(showback)把各团队的 AI 支出汇报给该团队,而资金仍留在中央预算里。成本分摊(chargeback)则把费用转入每个团队自己的预算。先从成本展示开始,建立习惯和基线,等各团队能预测自己的用量后,再转向成本分摊。
定制模型如何影响一个工作负载的 token 预算?
它降低所服务工作负载的单任务成本,而这通常是预算中最大的一项。使用自适应模型端点时,起初由前沿模型回答,并继续处理难的案例;定制模型通过您的评估集后,承接常规部分。模型可以由我们托管运行,也可以部署在您的云或本地,并且归您所有。
简短版
AI token 预算规定每个团队、每项任务每月可以在 AI 上花多少钱。先测量,再按角色设定额度,默认使用更便宜的模型,让每个团队看到自己的花费,并按单任务成本为工作负载编制预算。当一项任务主导了工作负载支出时,为它配一个专门训练的模型。
如果某一个工作负载已经占了您大部分的 token 预算,预约通话,我们和您一起看看。
资料来源:Quartz、彭博社关于 Uber 上限的报道、彭博社(经 Transport Topics 转载)、Claude Code 成本文档、Cursor 支出上限、Cursor Teams 定价、GitHub Copilot 按用量计费和 OpenAI API 定价。价格和产品控制功能核实于 2026 年 10 月 6 日。