


Un modelo personalizado cuesta menos que una API de frontera cuando el volumen mensual de una tarea cubre sus costos fijos: las GPU que mantiene encendidas, el trabajo de evaluación, supervisión y reentrenamiento, y la construcción amortizada. El punto de equilibrio es esa suma dividida entre el ahorro por llamada a la API, al precio de frontera que de verdad pagas.
Esta guía es para el responsable de ingeniería o el arquitecto que hace esa comparación. Incluye la fórmula de cada lado, un ejemplo práctico con todas las cifras a la vista, los costos que los equipos olvidan y una ruta de migración que protege la calidad mientras se mueve el tráfico. Los precios son precios de lista de OpenAI y Anthropic a octubre de 2026. Aplica primero las técnicas de configuración de optimización de costos de LLM: 12 técnicas, porque cambian el precio de frontera con el que comparas.
¿Cómo se calcula lo que cuesta una API de frontera al mes?
Multiplica las llamadas a la API del mes por el costo de una llamada a la API, y calcula ese costo con la tarifa que de verdad pagarías después de aplicar caché, procesamiento por lotes y el nivel más barato que apruebe tu evaluación. El precio de lista del modelo con el que hiciste el prototipo infla el lado de frontera y hace que cualquier modelo personalizado parezca más barato de lo que es.
costo de frontera al mes = llamadas a la API al mes x costo por llamada a la API

costo por llamada a la API = tokens de entrada sin caché x precio de entrada
                           + tokens de entrada en caché  x precio de caché
                           + tokens de salida            x precio de salida   (el razonamiento cuenta como salida)
Ajusta el precio antes de comparar. Cada fila de la tabla mueve el lado de frontera, y la mayoría lo mueve a la baja.
| Ajuste | Efecto en el precio de frontera | Cuándo se aplica |
|---|---|---|
| Nivel más barato que aprueba | Hasta 100 veces menos por token de salida | Un nivel más barato supera tu evaluación |
| Caché de prompts | Entrada en caché a una décima parte | Un prefijo de prompt largo y estable |
| Procesamiento por lotes | 50% menos en entrada y salida | Trabajo que puede esperar resultados |
| Esfuerzo de razonamiento | Menos tokens de razonamiento facturados | Ajustes más bajos siguen aprobando |
| Reintentos y escalados | Sube el precio efectivo | Toda carga de trabajo en producción |
A octubre de 2026, Anthropic factura los aciertos de caché a una décima parte del precio base de entrada en la mayoría de los modelos Claude, OpenAI cobra la entrada en caché de GPT-6 Astra y GPT-6 Luna a una décima parte de la entrada estándar, y ambos proveedores cobran el procesamiento por lotes al 50% de la tarifa estándar. Los reintentos empujan en sentido contrario: una tarea que reintenta el 5% de sus llamadas a la API paga un 5% más por tarea.
Ejemplo práctico: el lado de frontera
Toma una tarea de clasificación de siniestros con 2,000 tokens de entrada y 200 tokens de salida por llamada a la API, de los que 1,500 tokens de entrada son un prefijo de instrucciones estable que se guarda en caché. Se ejecuta de forma síncrona en Claude Sonnet 5.5, que a octubre de 2026 cuesta $2 por millón de tokens de entrada y $10 por millón de tokens de salida, con aciertos de caché a $0.20 por millón.
| Parte de la llamada a la API | Tokens | Precio por millón | Costo |
|---|---|---|---|
| Entrada sin caché | 500 | $2.00 | $0.0010 |
| Entrada en caché | 1,500 | $0.20 | $0.0003 |
| Salida | 200 | $10.00 | $0.0020 |
| Total por llamada a la API | 2,200 | $0.0033 |
Con tráfico constante el prefijo se mantiene en caché, así que las escrituras de caché suman poco y quedan fuera del cálculo. Sin caché, la misma llamada a la API cuesta $0.0060. Ten presente esa diferencia en el punto de equilibrio de más abajo, porque comparar contra $0.0060 lo situaría en torno a la mitad del volumen real.
¿Cuánto cuesta operar tu propio modelo personalizado?
Un modelo personalizado cuesta las GPU que mantienes encendidas para él, estén ocupadas o no, más el trabajo recurrente de mantenerlo bueno, más la construcción repartida a lo largo de su vida útil. Las solicitudes escaladas que siguen yendo a un modelo de frontera también se apuntan en este lado.
costo personalizado al mes = horas de GPU x precio de la GPU            (servicio)
                           + tiempo de ingeniería x costo total          (evaluación, supervisión, reentrenamiento, guardias)
                           + cómputo de reentrenamiento y evaluación
                           + costo de construcción / meses de vida útil
                           + llamadas a la API escaladas x precio de frontera
Servicio. A octubre de 2026, los precios bajo demanda de RunPod, Lambda y CoreWeave sitúan una H100 entre unos $2.90 y $6.20 por GPU-hora, y una L40S entre unos $1.10 y $2.25. La capacidad comprometida cambia la tarifa y te ata a esas horas, así que cotízala con tu propio proveedor.
Trabajo de operación. Tener un modelo en producción es trabajo continuo: renovar el conjunto de evaluación a medida que cambian las entradas, puntuar cada versión candidata, vigilar la calidad y la latencia, reentrenar cuando la tarea deriva y responder por el endpoint a cualquier hora. Calcúlalo como una fracción del tiempo de un ingeniero a su costo total. Dejarlo fuera compara un servicio gestionado, la API de frontera, solo contra la mitad de hardware de la alternativa.
Construcción. Recopilación y limpieza de datos, ejecuciones de entrenamiento, el primer conjunto de evaluación y la puesta en marcha del servicio. Repártela entre los meses que esperas que el modelo siga en servicio antes de reconstruirlo.
¿Por qué la utilización de la GPU es la variable oculta?
Una GPU se factura por hora tanto si atiende una solicitud como un millón, así que el costo de servir una solicitud es el precio por hora dividido entre las solicitudes que esa hora realmente atendió. La utilización, la parte de la capacidad que llena tu tráfico, decide esa cifra más que el precio de la GPU.
Supón que una prueba de carga muestra que una GPU sostiene 10 solicitudes por segundo en esta tarea a plena carga, es decir, 36,000 por hora. A $4.00 por GPU-hora, una GPU ocupada al 100% sirve una solicitud por unos $0.00011. La misma GPU ocupada al 5% cuesta $0.0022 por solicitud, dos tercios del precio de frontera con caché.
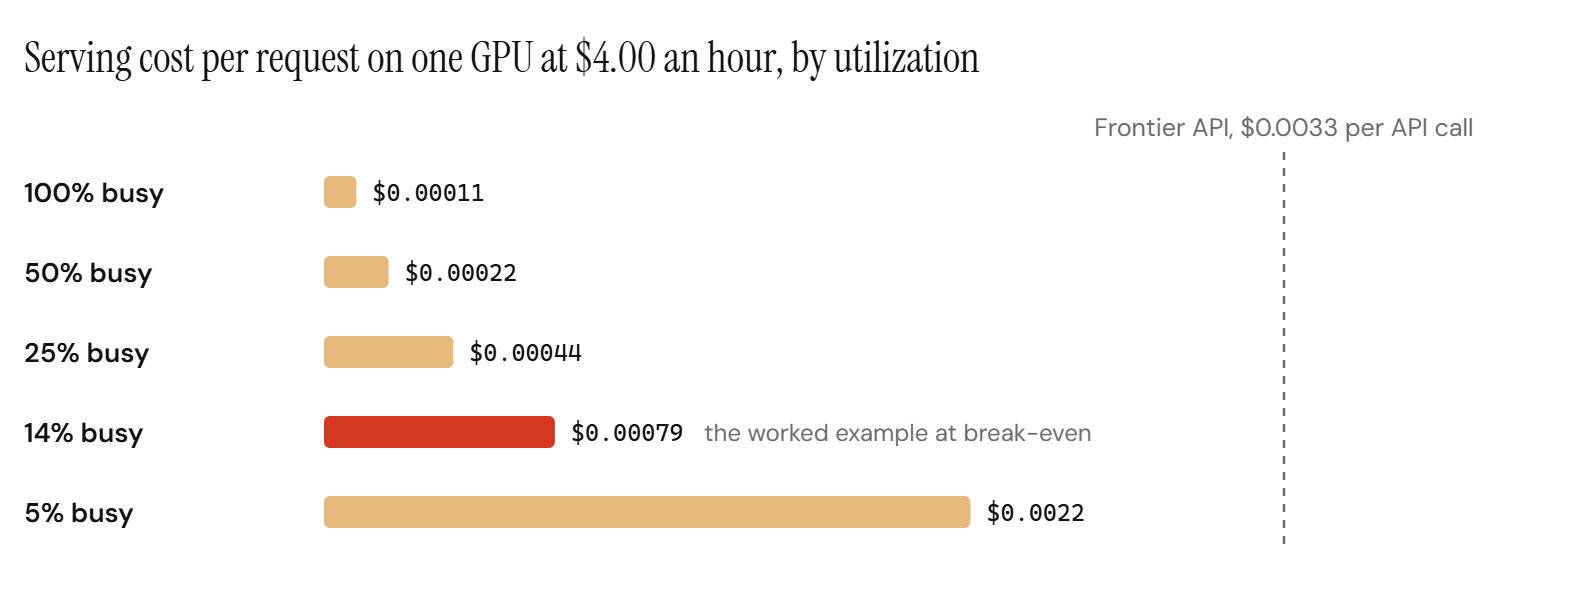
Las GPU quedan ociosas por razones normales. El tráfico alcanza su pico en horario laboral y la flota se dimensiona para ese pico. Un endpoint que sigue en pie durante un fallo o un despliegue necesita al menos dos réplicas. Los entornos de staging y de evaluación ocupan GPU propias. Servir con escalado a cero recorta horas ociosas a cambio de una primera respuesta lenta tras un periodo sin tráfico. Un modelo entrenado para una sola tarea suele funcionar con un prompt mucho más corto, porque sus instrucciones ya no viajan en cada solicitud, y eso aumenta las solicitudes que puede atender cada GPU.
Ejemplo práctico: el lado personalizado
Esta es la misma tarea de clasificación de siniestros con un modelo personalizado, con cada supuesto explícito para que lo sustituyas por el tuyo.
| Partida | Supuesto | Costo mensual |
|---|---|---|
| Servicio | 2 GPU × 730 horas × $4.00 | $5,840 |
| Trabajo de operación | Medio ingeniero a $20,000 al mes | $10,000 |
| Cómputo de reentrenamiento y evaluación | Asignación mensual | $1,000 |
| Construcción amortizada | $60,000 en 12 meses | $5,000 |
| Total fijo | $21,840 | |
| Escalados | 10% de las llamadas a la API a $0.0033 | $0.00033 por llamada a la API |
Dos GPU a 10 solicitudes por segundo cada una atienden unos 52.6 millones de solicitudes al mes a plena carga, así que la flota se queda en dos en todos los volúmenes de este ejemplo. El servicio supone algo más de una cuarta parte del total fijo. El tiempo de ingeniería es la partida más grande.
¿Cuál es el volumen de equilibrio de un modelo personalizado?
El volumen de equilibrio es el costo fijo mensual del modelo personalizado dividido entre lo que ahorra cada llamada a la API después de los escalados. En el ejemplo práctico son unos 7.35 millones de llamadas a la API al mes, alrededor de 240,000 al día.
llamadas a la API al mes en equilibrio = F / ((1 - e) x p - m)

F = costo fijo mensual del modelo personalizado (mínimo de la flota, trabajo de operación, cómputo, construcción amortizada)
e = parte de las llamadas a la API que se sigue escalando a un modelo de frontera
p = costo de frontera por llamada a la API, al precio que de verdad pagas
m = costo de servicio por llamada a la API por encima del mínimo de la flota (cero mientras haya capacidad)
Con F = $21,840, e = 10%, p = $0.0033 y m = 0, el punto de equilibrio es 21,840 / (0.9 × 0.0033) = 21,840 / 0.00297 = 7,353,535 llamadas a la API al mes.
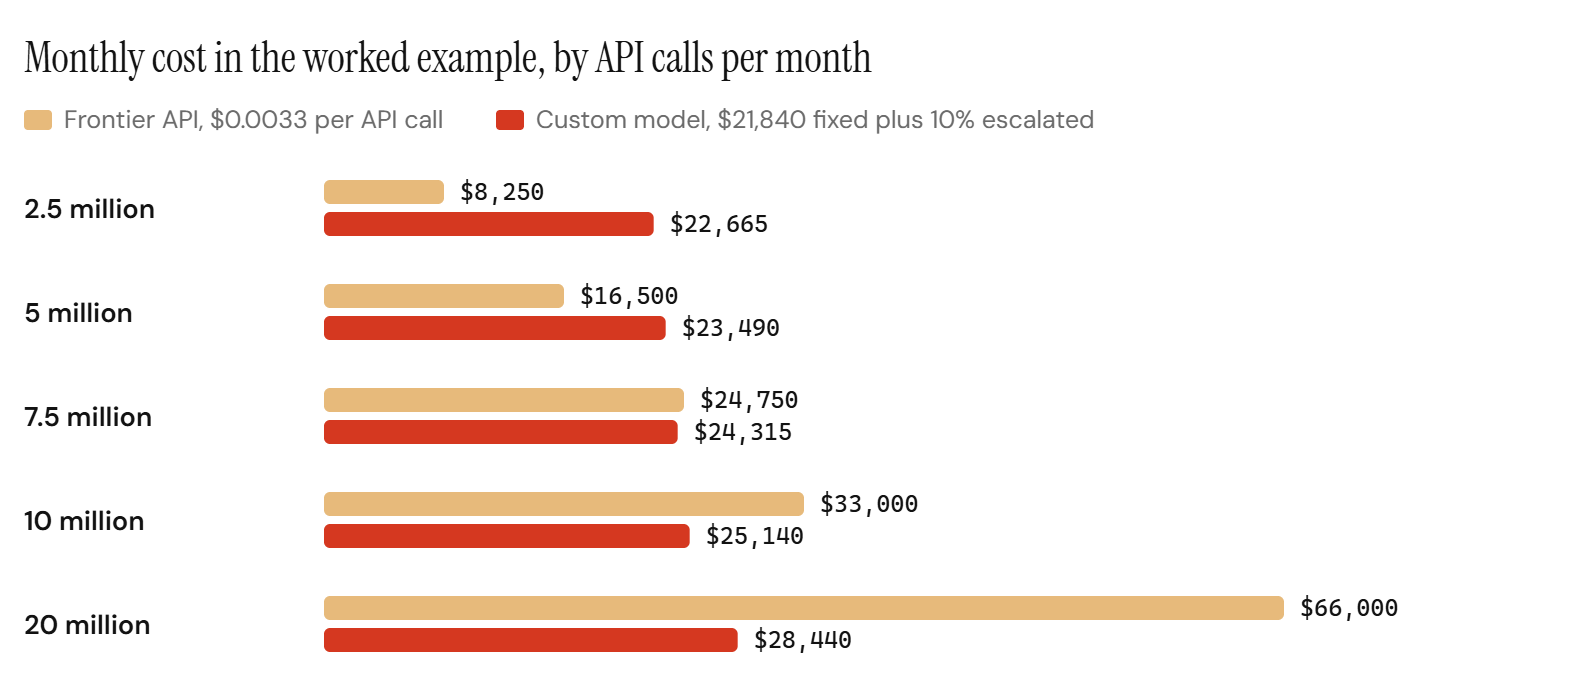
Por debajo de ese volumen, la API de frontera es más barata. Por encima, cada llamada a la API adicional ahorra 0.9 × $0.0033 = $0.00297, de modo que con 20 millones de llamadas a la API al mes el modelo personalizado cuesta $28,440 frente a $66,000, un ahorro del 57%.
¿Cuánto cambia el punto de equilibrio con cada dato de entrada?
Los datos de entrada son estimaciones, así que aplica la fórmula a todo el rango que consideres creíble. Cada fila cambia un solo dato del ejemplo práctico.
| Cambio respecto al ejemplo práctico | Llamadas a la API al mes en equilibrio |
|---|---|
| Ninguno, tal como está | 7.35 millones |
| Comparado con los $0.0060 sin caché | 4.04 millones |
| GPU a $6.00 en lugar de $4.00 | 8.34 millones |
| Escalados del 30% en lugar del 10% | 9.45 millones |
| Un ingeniero completo en lugar de medio | 10.7 millones |
| Precio de frontera a la mitad | 14.7 millones |
| Aprueba el nivel más barato, $0.0003 por llamada a la API | Más de 80 millones |
El precio de la GPU es lo que menos mueve el resultado. El precio de frontera con el que comparas es lo que más lo mueve, y cada $1,000 de costo fijo mensual suma unas 337,000 llamadas a la API al mes al punto de equilibrio. La última fila es la primera que conviene comprobar: a octubre de 2026, GPT-6 Luna cuesta $0.10 por millón de tokens de entrada y $0.50 por millón de tokens de salida, así que esta tarea costaría en él $0.0003 por llamada a la API sin contar la caché. Si un nivel tan barato aprueba tu evaluación, el costo por sí solo rara vez justifica un modelo personalizado, y el caso pasa a depender de la latencia o de dónde deben quedarse los datos.
¿Qué costos olvidan los equipos en cada lado?
Los dos lados tienen costos que nunca aparecen en una primera estimación. Súmalos antes de fiarte del punto de equilibrio.
| Lado | Costo olvidado | Por qué importa |
|---|---|---|
| Frontera | Reintentos y fallos de validación | Cada reintento es una llamada a la API completa |
| Frontera | Escalados a un nivel superior | Se facturan al precio más alto |
| Frontera | Tokens de razonamiento | Se facturan como salida y no se ven |
| Frontera | Crecimiento del prompt | Las instrucciones se alargan con cada corrección |
| Frontera | Cambios de precio y de modelo | Cada lanzamiento obliga a otra evaluación |
| Personalizado | Horas de GPU ociosa | Se facturan esté ocupada o no |
| Personalizado | Mantenimiento de la evaluación | Debe seguir a las entradas cambiantes |
| Personalizado | Deriva y reentrenamiento | La calidad baja cuando cambia la tarea |
| Personalizado | Guardias e incidentes | Alguien responde por el endpoint a toda hora |
| Personalizado | Respaldo en frontera | Los escalados se facturan a precio de frontera |
La guía de razonamiento de OpenAI indica que los tokens de razonamiento se facturan como tokens de salida aunque la API nunca los devuelva, y así es como el precio real por llamada a la API de un modelo de razonamiento se aleja de la estimación hecha con la salida visible. Mide los dos lados como costo por tarea exitosa, con todos los reintentos y escalados, como se explica en nuestra guía sobre el costo por tarea y la economía unitaria de la IA.
¿Cuándo conviene sustituir un modelo de frontera por un modelo personalizado?
Sustituye un modelo de frontera en una tarea cuando su volumen queda muy por encima de tu punto de equilibrio, la tarea es estable y una evaluación puede puntuarla automáticamente. La latencia y la ubicación de los datos suman razones más allá del costo. Quédate con el modelo de frontera cuando el volumen es bajo, la tarea cambia cada semana o nadie sabe definir una buena respuesta.
| Señal | Apunta hacia un modelo personalizado | Apunta a seguir con la API |
|---|---|---|
| Volumen | Muy por encima del equilibrio y estable | Cerca o por debajo del equilibrio |
| Estabilidad | Mismas entradas y formato cada mes | La tarea cambia cada semana |
| Medición | Una evaluación puntúa las salidas automáticamente | La calidad se juzga caso por caso |
| Latencia | Los usuarios esperan cada respuesta | Los resultados pueden esperar |
| Ubicación de los datos | Deben quedarse en tu nube u on-premise | Las condiciones del proveedor ya son aceptables |
| Nivel más barato que aprueba | Sigue siendo un nivel medio o alto | Ya aprueba un nivel bajo |
Deja margen por encima del punto de equilibrio, porque cada dato de la fórmula es una estimación hasta que el modelo atiende tráfico real. Nuestra comparación de un modelo pequeño ajustado con la API de GPT-4 cubre la precisión y la latencia por tipo de tarea, y cuándo un SaaS debería pasar de las llamadas a la API al fine-tuning recorre la decisión en una empresa de producto en crecimiento. Esta guía añade a ese panorama el trabajo de operación, la parte escalada y el precio de frontera después de la caché y los lotes.
¿Cómo se migra desde una API de frontera sin poner en riesgo la calidad?
Mueve el tráfico por etapas, cada una con su evaluación como control. Ejecuta el modelo personalizado en segundo plano con solicitudes reales, puntúalo contra tu nivel de calidad, dale una pequeña parte del tráfico en vivo con el modelo de frontera como respaldo y después amplíala. En cada etapa, los usuarios solo dependen de una versión que ya aprobó.
- Línea base. Registra el costo por tarea exitosa y puntúa el modelo de frontera actual con tu evaluación, para que el modelo personalizado tenga un nivel que superar y un costo que batir.
- Puntuación en segundo plano. Envía una copia de las solicitudes reales al modelo personalizado mientras los usuarios siguen recibiendo respuestas de frontera. Puntúa sus salidas con la evaluación y vigila la latencia y la tasa de errores con carga real.
- Control de evaluación. Promueve solo una versión que alcance el nivel en la evaluación y en la muestra en segundo plano, con una persona concreta que la apruebe.
- Pequeña parte en vivo. Envía un pequeño porcentaje del tráfico en vivo al modelo personalizado, con respaldo automático al modelo de frontera ante un fallo de validación, un tiempo de espera agotado o una confianza baja.
- Ampliación. Sube la parte por escalones mientras los informes de calidad y de costo se mantengan.
- Mantén el respaldo. Los casos difíciles y los tipos de entrada nuevos siguen yendo a un modelo de frontera, y cada versión reentrenada vuelve a pasar por el mismo control.
Trata cada versión reentrenada como un modelo nuevo. Un reentrenamiento que mejora una parte del tráfico puede empeorar otra, y el control lo detecta antes que los usuarios. Los patrones de enrutamiento de los pasos 4 y 6 se explican en estrategias de enrutamiento de LLM para reducir costos de API de frontera.
¿Cómo cambia las cuentas un endpoint de modelo adaptativo?
Un endpoint de modelo adaptativo quita a tu equipo el lado de operación de la fórmula. Es un único endpoint de API para una de tus tareas: los modelos de frontera responden al principio, un modelo personalizado entrenado con tus solicitudes y los comentarios de tu equipo toma el relevo cuando supera tus evaluaciones, y los casos difíciles siguen en los modelos de frontera.
Las solicitudes escaladas se siguen facturando a precio de frontera, y por eso la fórmula del punto de equilibrio incluye una parte escalada.
La ruta de migración de arriba ya viene incluida. Cada nueva versión del modelo personalizado se ejecuta en segundo plano con solicitudes reales y se puntúa con tus evaluaciones, y nada cambia sin tu aprobación. Nosotros supervisamos el modelo y lo reentrenamos a medida que cambia tu tarea. Funciona gestionado por Ertas, en tu nube u on-premise, y es tuyo. Por ahora el endpoint funciona solo por invitación, y estamos desarrollando una versión más ágil para abrirlo a más empresas. Tus ingenieros cambian un nombre de modelo, y los modelos de frontera atienden todas las solicitudes al principio, así que nada espera al entrenamiento.
La cuestión de costos se reduce entonces a una comparación: el endpoint frente a la factura de frontera que sustituye en esa tarea, con tu propio tráfico y tus propios recuentos de tokens.
El lado de servicio puede ser muy barato para un modelo entrenado para un solo trabajo. En nuestro estudio QMSum publicado, un modelo de 1.2B entrenado para resumir reuniones a partir de consultas tuvo un costo estimado de servicio de $0.00053 por consulta en una GPU alquilada en la nube, frente a $0.104 de Claude Opus 5 y $0.0130 de GPT-5.6 Luna a precios de lista síncronos. Respondió en 0.39 segundos frente a 9.0 segundos de Claude Opus 5. La estimación no incluye el costo de entrenamiento, y la calidad depende de cada tarea, por eso cada cambio espera a tus evaluaciones.
Preguntas Frecuentes
¿Un modelo ajustado con fine-tuning es más barato que una API de GPT o Claude?
Por solicitud, un modelo ajustado para una sola tarea suele costar mucho menos de servir, porque puede ser bastante más pequeño y funciona con un prompt más corto. Por mes, solo es más barato por encima del volumen de equilibrio, porque las GPU, la evaluación, la supervisión y el reentrenamiento cuestan dinero llegue o no el tráfico. Aplica la fórmula con el precio de frontera que de verdad pagas.
¿Cuál es el punto de equilibrio para alojar un LLM por tu cuenta?
Es el costo fijo mensual del modelo autoalojado dividido entre el ahorro por llamada a la API después de los escalados, F / ((1 - e) × p - m). En nuestro ejemplo práctico, con $21,840 al mes de costo fijo y un precio de frontera con caché de $0.0033 por llamada a la API, el punto de equilibrio está en unos 7.35 millones de llamadas a la API al mes. Tus datos serán distintos, así que haz el cálculo con los tuyos.
¿Cuánto cuesta al mes operar tu propio LLM?
El servicio, el trabajo de operación y la construcción amortizada. A octubre de 2026, una H100 cuesta entre unos $2.90 y $6.20 por GPU-hora bajo demanda en RunPod, Lambda y CoreWeave, así que dos GPU encendidas todo el mes cuestan entre unos $4,200 y $9,000. En el ejemplo práctico, el tiempo de ingeniería para evaluar, supervisar y reentrenar el modelo es la partida más grande.
¿Debo comparar un modelo personalizado con los precios por lotes?
Para el trabajo que puede esperar resultados, sí. A octubre de 2026, OpenAI y Anthropic cobran el procesamiento por lotes al 50% de la tarifa estándar, y reducir a la mitad el precio de frontera duplica el volumen de equilibrio. Comparar una carga asíncrona con precios de lista síncronos favorece de forma artificial al modelo personalizado.
¿Qué pasa con las solicitudes difíciles después de cambiar a un modelo personalizado?
Siguen yendo a un modelo de frontera. Enruta ante fallos de validación, tiempos de espera agotados y confianza baja, y presupuesta esa parte escalada en la fórmula, porque las llamadas a la API escaladas se facturan a precio de frontera. Con un endpoint de modelo adaptativo, los casos difíciles siguen en los modelos de frontera por diseño.
¿De quién es un modelo personalizado servido a través de un endpoint de modelo adaptativo?
Es tuyo. El modelo se entrena con tus solicitudes y los comentarios de tu equipo para tu tarea, y funciona gestionado por Ertas, en tu nube u on-premise. Nosotros lo supervisamos y lo reentrenamos a medida que cambia tu tarea.
La Versión Corta
Un modelo personalizado gana en costo a partir de un volumen concreto: su costo fijo mensual dividido entre lo que ahorra cada llamada a la API. Calcula el lado de frontera después de la caché, los lotes y el ajuste del nivel, cuenta en el lado personalizado el trabajo de operación y la parte escalada, y dimensiona las GPU para la utilización que de verdad vas a tener. Después migra detrás de un control de evaluación con respaldo en frontera.
Si una tarea se acerca a su punto de equilibrio o ya lo superó, agenda una llamada y hacemos las cuentas contigo con tu tráfico.
Fuentes: precios de la API de OpenAI, precios de Anthropic, documentación de caché de prompts de Anthropic, guía de razonamiento de OpenAI y los precios de GPU bajo demanda de RunPod, Lambda y CoreWeave. Precios verificados el 6 de octubre de 2026.