

Optimizar los costos de la IA agéntica significa bajar el costo de cada ejecución exitosa de un agente. La mayor parte de ese costo es contexto que se reenvía en cada paso, así que los mayores ahorros vienen de recortar la salida de las herramientas, limpiar resultados antiguos, cachear el prefijo estático, limitar los pasos por ejecución y pasar los pasos rutinarios a modelos más baratos.
Los agentes son donde las facturas de tokens crecen más rápido. En junio de 2025, Anthropic informó que, según sus datos, los agentes solían usar unas 4 veces más tokens que las interacciones de chat, y los sistemas multiagente unas 15 veces más. La misma publicación encontró que, en la evaluación BrowseComp, el uso de tokens por sí solo explicaba el 80% de la variación del rendimiento. Los tokens compran resultados, así que el trabajo consiste en encontrar los tokens que no compran nada.
Esta guía sigue una ejecución de un agente de principio a fin: adónde van sus tokens, cómo medirla y las correcciones en el orden en que más ahorran. Para las técnicas a nivel de modelo, consulta Optimización de costos de LLM: 12 técnicas. Para la visión de gestión, consulta cómo reducir los costos de tokens de IA en tu empresa.
¿Por qué los agentes de IA usan tantos tokens?
Un agente trabaja en bucle. Cada paso es una llamada a la API: el modelo lee todo lo anterior y luego pide una herramienta o escribe la respuesta. Cada llamada a la API se factura por toda la entrada del modelo, así que cada paso vuelve a pagar el prompt del sistema, las definiciones de herramientas, la tarea y el registro completo de los pasos anteriores, incluidos todos los resultados de herramientas.
Por eso la entrada de una ejecución crece más rápido que su número de pasos:
tokens de entrada por ejecución = n x (prefijo + tarea)
                                + (tokens añadidos por paso) x n(n-1)/2

n       = llamadas a la API de la ejecución
prefijo = prompt del sistema + definiciones de herramientas
El primer término crece al mismo ritmo que la ejecución. El segundo crece con el cuadrado del número de pasos, y los resultados de herramientas suelen dominarlo, porque una sola búsqueda o consulta a una base de datos puede devolver miles de tokens.
Toma como ejemplo un agente de soporte: un prefijo de 8.000 tokens (un prompt del sistema y 15 definiciones de herramientas), una tarea de 500 tokens y 12 llamadas a la API. Cada paso escribe 300 tokens de razonamiento y argumentos de herramienta, y cada herramienta devuelve 1.700 tokens. A lo largo de la ejecución, el agente envía 234.000 tokens de entrada y escribe 3.600.
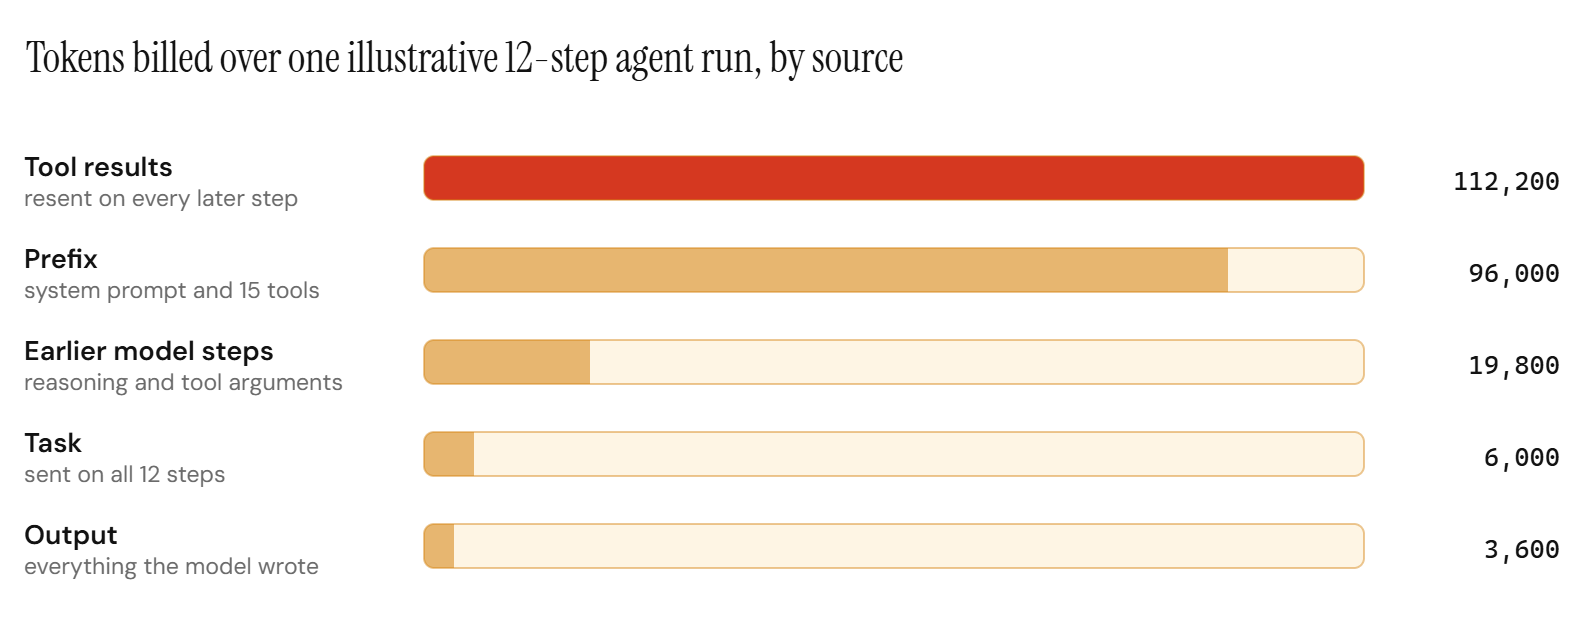
Así que reducir el costo de un agente es sobre todo trabajo de contexto. Los resultados de herramientas sobre los que el agente ya actuó son la partida más grande, y el prefijo, idéntico en cada paso, es la segunda. Ambos son baratos de corregir, y el resto de esta guía usa la misma ejecución para mostrar cuánto.
La longitud de la ejecución importa tanto como su contenido. Duplicar esta ejecución a 24 llamadas a la API más que triplica su entrada, hasta 756.000 tokens, y por eso la cola larga de ejecuciones pesa tanto en la factura de un agente.
¿Cómo se mide lo que cuesta una ejecución de un agente?
Registra el uso en cada llamada a la API con un ID de ejecución y luego informa por ejecución. Basta con un pequeño registro contable:
from dataclasses import dataclass, field

# USD por millón de tokens, precios de lista de Claude Opus 5 a octubre de 2026.
# cache_write es la tarifa de 5 minutos; las escrituras de 1 hora cuestan 2x la entrada base.
PRICE = {"input": 5.00, "cache_write": 6.25, "cache_read": 0.50, "output": 25.00}

@dataclass
class RunLedger:
    run_id: str
    task_type: str
    steps: int = 0
    tokens: dict = field(default_factory=lambda: dict.fromkeys(PRICE, 0))

    def record(self, usage):
        # Anthropic informa los tokens en caché en sus propios campos, junto a input_tokens.
        self.steps += 1
        self.tokens["input"] += usage.input_tokens
        self.tokens["cache_write"] += usage.cache_creation_input_tokens or 0
        self.tokens["cache_read"] += usage.cache_read_input_tokens or 0
        self.tokens["output"] += usage.output_tokens

    @property
    def cost(self):
        return sum(self.tokens[k] * PRICE[k] for k in PRICE) / 1_000_000
Pasa a record el objeto de uso de cada respuesta, incluidos los reintentos y cualquier subagente que trabaje para la ejecución. Después informa cuatro cifras por agente y tipo de tarea:
| Métrica | Qué te dice |
|---|---|
| Costo por ejecución exitosa | Gasto total entre ejecuciones que alcanzaron el nivel |
| Costo mediano por ejecución | Lo que cuesta una ejecución normal |
| Costo y pasos en el p95 | Hasta dónde llega la cola |
| Tasa de éxito | Si un ahorro te costó calidad |
import statistics

def cost_report(runs):
    """runs: lista de pares (ledger, succeeded) de un agente y tipo de tarea."""
    costs = sorted(ledger.cost for ledger, _ in runs)
    wins = sum(1 for _, ok in runs if ok)
    return {
        "cost_per_successful_run": sum(costs) / max(wins, 1),
        "median_run_cost": statistics.median(costs),
        "p95_run_cost": costs[int(0.95 * (len(costs) - 1))],
        "success_rate": wins / len(runs),
    }
Divide entre las ejecuciones exitosas y deja el costo de las fallidas en el numerador. Un cambio que reduce la mediana en un tercio pero empuja más ejecuciones a reintentos puede subir el costo por ejecución exitosa. El p95 es donde viven los bucles, los reintentos y las ejecuciones confusas, y como la entrada crece con el cuadrado del número de pasos, una ejecución del doble de la longitud mediana puede costar unas tres veces más.
Para fijar un objetivo para esa cifra a partir de lo que vale la tarea, consulta costo por tarea: cómo medir la economía unitaria de la IA.
¿Qué correcciones reducen más el uso de tokens de un agente?
Aplícalas más o menos en este orden. Las cinco primeras solo cambian el contexto y los límites, así que conllevan poco riesgo para la calidad. Las dos últimas cambian cuántos agentes o qué modelo hacen el trabajo, así que necesitan antes una evaluación.
| Corrección | Qué reduce | Esfuerzo | Riesgo de calidad |
|---|---|---|---|
| Recortar la salida en la herramienta | Tokens de resultados | Bajo | Bajo |
| Devolver resultados estructurados | Tokens de resultados | Bajo | Bajo |
| Limpiar resultados antiguos | Historial reenviado | Bajo | Medio |
| Cachear el prefijo estático | Precio del prefijo | Bajo | Ninguno |
| Limitar pasos y gasto por ejecución | La cola larga | Bajo | Bajo, con traspaso |
| Acotar los subagentes | Contexto duplicado | Medio | Medio |
| Elegir un modelo por paso | Precio por token | Medio | Requiere evaluación por paso |
Recorta la salida en la propia herramienta
La herramienta decide qué entra en el contexto, y todo lo que devuelve se vuelve a facturar en cada paso posterior. Una consulta al CRM que devuelve la ficha completa del cliente, una búsqueda que devuelve diez páginas enteras y una consulta de registros que devuelve líneas en bruto son los culpables habituales.
- Devuelve solo los campos que usa el agente. Define una vista por herramienta en lugar de serializar la fila de la base de datos.
- Limita filas y caracteres dentro de la herramienta e indica qué se recortó: "mostrando 20 de 1.240 filas, pide la página 2 para ver más". El agente puede pedir más cuando lo necesite.
- Filtra la salida extensa en la herramienta: la prueba que falla y su error, las líneas de registro que coinciden, la sección relevante de un documento.
- Mantén los mensajes de error breves y accionables, porque una traza de pila también se reenvía.
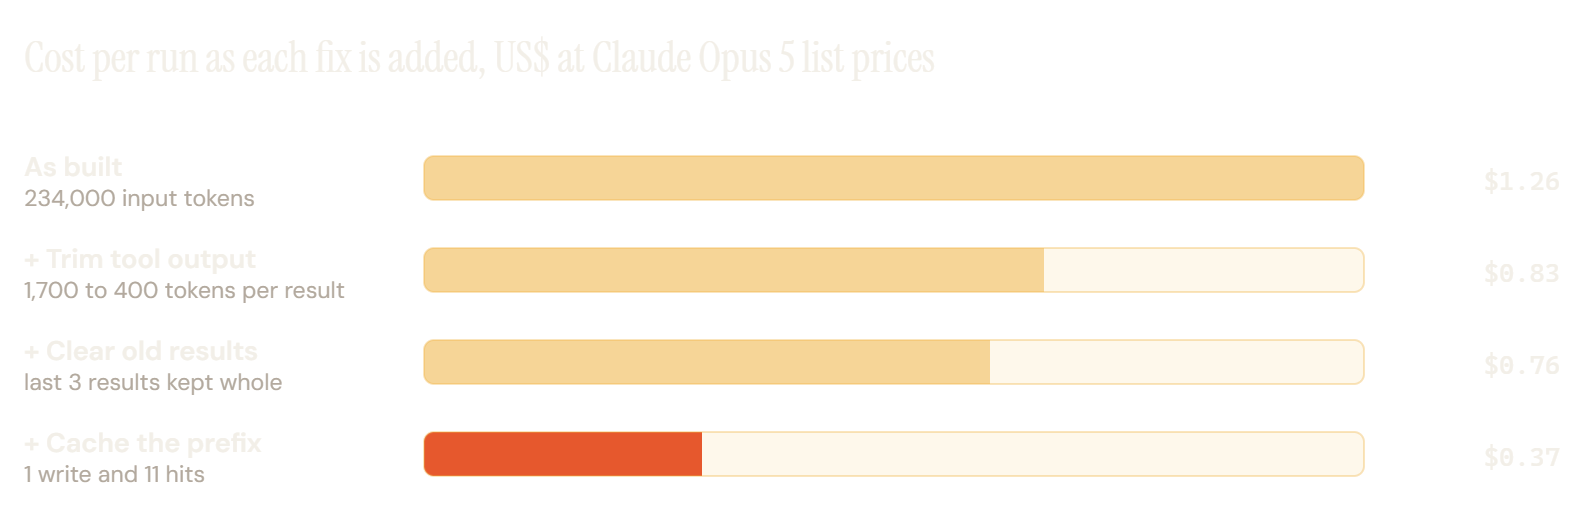
En la ejecución de ejemplo, recortar cada resultado de herramienta de 1.700 a 400 tokens baja la entrada de 234.000 a 148.200 tokens por ejecución.
Devuelve resultados de herramientas estructurados
Un JSON con claves cortas y solo los campos necesarios es compacto, y el modelo lo lee con más fiabilidad que el texto libre. Devuelve ID y deja que el agente pida detalles de los pocos registros que de verdad necesita. Mantén estable el orden de las claves, porque la documentación de caché de prompts de Anthropic advierte que los lenguajes que reordenan las claves al convertir a JSON rompen la caché.
Limpia los resultados antiguos de herramientas
Una vez que el agente ha actuado sobre un resultado, rara vez necesita el texto completo otra vez. Sustituye los resultados antiguos por un marcador de una línea, o por el dato que el agente sacó de ellos, y conserva enteros los más recientes.
Anthropic ofrece esto en el servidor. A octubre de 2026, su función de edición de contexto, en beta, incluye una estrategia de limpieza de resultados de herramientas que sustituye los resultados antiguos por un texto marcador cuando la entrada supera un umbral que tú fijas, 100.000 tokens por defecto. Su función de compactación, también en beta, sustituye los turnos antiguos por un resumen. La documentación señala que limpiar resultados de herramientas invalida el prefijo en caché desde el punto de la limpieza, así que limpia en lotes grandes, lo bastante para compensar la reescritura de la caché.
Conservar enteros los tres últimos resultados en la ejecución de ejemplo lleva la entrada de 148.200 a 133.800 tokens. El ahorro es modesto aquí porque los resultados ya estaban recortados. En la ejecución sin recortar, la misma regla ahorraría por sí sola 61.200 tokens.
Cachea el prefijo estático
Los agentes son el mejor caso para la caché de prompts, porque el mismo prefijo se envía en cada paso, con segundos o minutos de diferencia. La documentación de caché de Anthropic describe el prefijo en caché como herramientas, sistema y mensajes, en ese orden, así que las definiciones de herramientas y el prompt del sistema se cachean juntos al principio. A octubre de 2026, Anthropic factura los aciertos de caché a una décima parte del precio de entrada en la mayoría de los modelos Claude, y las escrituras de caché de 5 minutos a 1,25 veces.
Tres reglas mantienen alta la tasa de aciertos en un agente:
- Mantén fijas las definiciones de herramientas, y en un orden fijo, durante toda la ejecución. La misma documentación indica que modificar las definiciones de herramientas invalida toda la caché, así que carga el conjunto completo de herramientas al principio y evita añadir herramientas a mitad de la ejecución.
- Deja fuera del prompt del sistema las marcas de tiempo, los nombres de usuario y los ID de ejecución. Ponlos en el primer mensaje del usuario.
- Registra en cada paso los campos de lectura y escritura de caché, porque un fallo silencioso solo aparece como una factura más alta.
En la ejecución de ejemplo, cachear el prefijo de 8.000 tokens convierte 96.000 tokens a precio completo en una escritura y 11 aciertos, el equivalente en costo a 18.800 tokens.
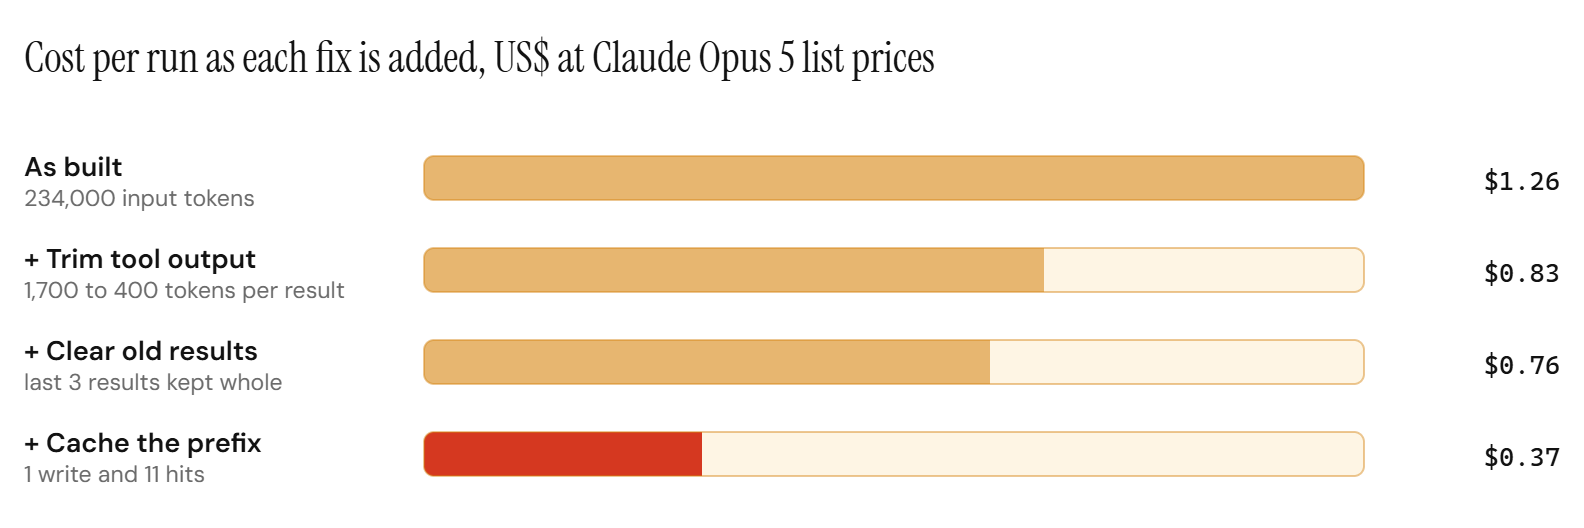
Limita pasos y gasto por ejecución, con un traspaso limpio
Las ejecuciones largas cuestan más de lo que sugiere su longitud, así que la cola necesita un tope firme. Comprueba los límites antes de cada llamada a la API:
class BudgetExceeded(Exception):
    pass

def check_budget(ledger, max_steps=20, max_cost_usd=2.00):
    if ledger.steps >= max_steps or ledger.cost >= max_cost_usd:
        raise BudgetExceeded(
            f"run {ledger.run_id}: {ledger.steps} steps, ${ledger.cost:.2f}"
        )
Fija los límites a partir de los datos. Empieza cerca del p95 de las ejecuciones exitosas más algo de margen, y revísalos cada vez que cambie el agente. Cuando una ejecución llegue a un límite, ciérrala limpiamente: guarda un resumen breve de su estado, pasa la tarea a una persona o a una vía más simple y cuenta la ejecución como fallida en el registro. Nuestra guía sobre humanos en el bucle para agentes de IA cubre el diseño del traspaso.
Añade también una comprobación de bucles. Un agente que pide la misma herramienta con los mismos argumentos dos veces seguidas suele estar atascado, y detenerlo ahí sale más barato que esperar al tope de pasos.
La función de presupuestos de tarea de Anthropic, en beta a octubre de 2026, le dice a Claude cuántos tokens tiene para un bucle agéntico completo, para que pueda dosificarse. La documentación describe ese presupuesto como orientativo, así que mantén el límite firme en tu propio bucle y usa el presupuesto para marcar el ritmo.
Acota bien los subagentes
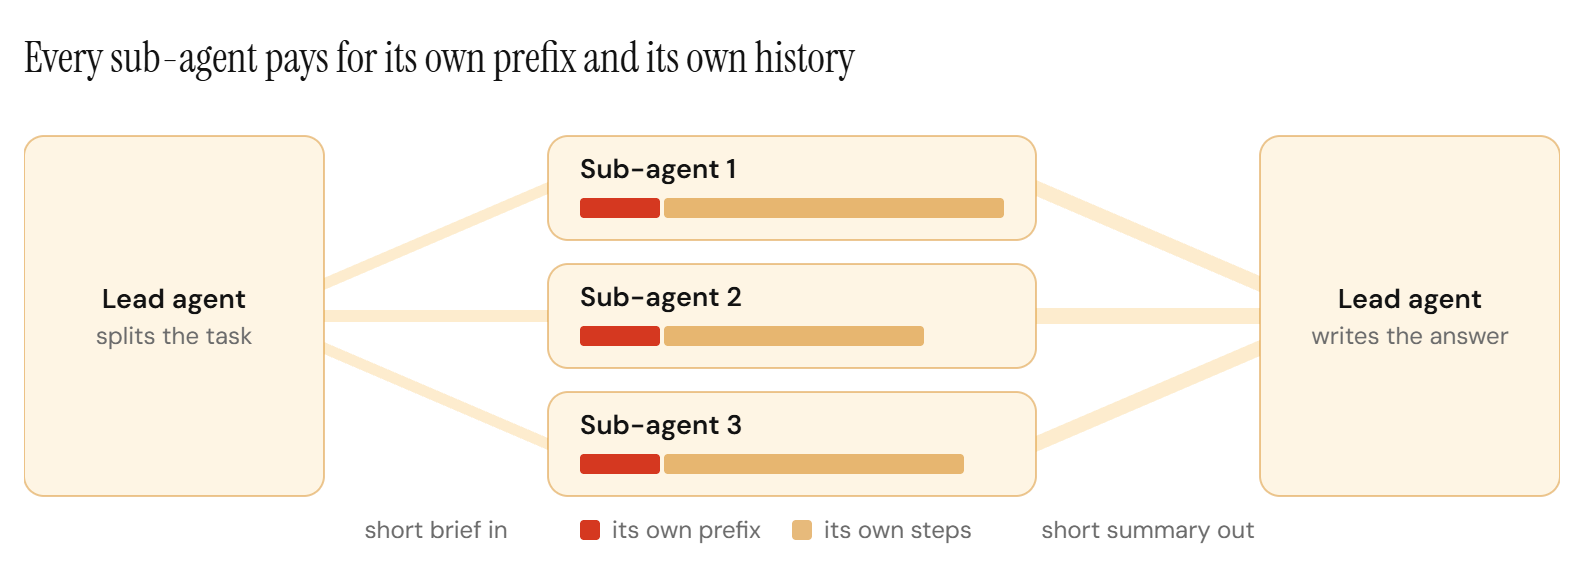
Un subagente empieza con un contexto nuevo: su propio prefijo, su propio encargo y su propio historial. Repartir el trabajo multiplica el prefijo y el historial por el número de subagentes, y el agente principal paga después por leer lo que vuelve. El sistema de investigación de Anthropic es el caso de referencia. Sus ejecuciones multiagente usaron unas 15 veces los tokens de un chat, y Anthropic escribió que los sistemas multiagente necesitan tareas lo bastante valiosas como para pagar el mayor rendimiento.
- Usa subagentes para trabajo amplio que de verdad corre en paralelo, como investigar varias fuentes independientes. El trabajo secuencial cuesta menos en un solo agente.
- Dale a cada subagente solo las herramientas que necesita su tarea, porque un conjunto de herramientas más pequeño es un prefijo más pequeño en cada uno de sus pasos.
- Haz que los subagentes devuelvan un resultado condensado. Escribe las salidas grandes en almacenamiento y pasa una referencia, para que el contexto del agente principal siga siendo pequeño.
- Limita el número de subagentes por ejecución y somete a cada uno a los mismos controles de pasos y gasto.
Elige un modelo por paso
La mayoría de los agentes usan un mismo modelo para todos los pasos, aunque los pasos sean distintos. Planificar el enfoque y escribir la respuesta final necesitan el modelo más fuerte que puedas pagar. Muchos pasos intermedios son rutinarios: elegir la siguiente herramienta, extraer campos de un resultado, clasificar un documento, decidir si una comprobación pasó.
Esos pasos rutinarios son donde un nivel más barato compensa. A octubre de 2026, Claude Haiku 4.5 cuesta una quinta parte que Claude Opus 5 por token, a 1 y 5 USD por millón de tokens de entrada y salida frente a 5 y 25 USD, y GPT-6 Luna cuesta una centésima parte que GPT-6 Astra. Prueba a nivel de paso: registra cada paso con un tipo de paso, reproduce una muestra de cada tipo con el nivel más barato y mueve solo los tipos de paso que pasen. Mide la tasa de aciertos de caché por modelo después de la división. Nuestra guía de estrategias de enrutamiento de LLM explica cómo mover ese tráfico de forma segura.
¿Dónde encaja un modelo personalizado en un agente?
Un agente en producción repite los mismos pocos tipos de paso miles de veces al día. Clasifica la solicitud, extrae los campos, decide la siguiente acción y enruta el caso. Cada uno de esos pasos es una tarea acotada con una salida verificable y un volumen estable, que es el perfil en el que un modelo entrenado para la tarea sirve a una fracción del precio de frontera.
La latencia también se acumula en los agentes. Cada paso espera a un modelo, así que recortar segundos de un tipo de paso acorta la ejecución una vez por cada vez que ese paso aparece en ella.
Ese es el trabajo del endpoint de modelo adaptativo. Un endpoint de modelo adaptativo es un endpoint de API para una de tus tareas: los modelos de frontera responden al principio, un modelo personalizado entrenado con tus solicitudes y los comentarios de tu equipo toma el relevo cuando supera tus evaluaciones, y los casos difíciles siguen en modelos de frontera. En un agente, cada tipo de paso rutinario recibe su propio endpoint.
La planificación y la respuesta final pueden quedarse en modelos de frontera todo el tiempo, así que el agente conserva su criterio mientras sus pasos repetidos se abaratan.
Para el código del agente, el cambio es un nombre de modelo en la llamada a la API de ese paso. Cada nueva versión del modelo personalizado se ejecuta en segundo plano sobre solicitudes reales y se puntúa con tus evaluaciones, y nada cambia sin tu aprobación. Supervisamos el modelo y lo reentrenamos a medida que cambian tus tareas. Funciona gestionado por Ertas, en tu nube o en tus instalaciones, y es tuyo. Por ahora el endpoint funciona solo por invitación, y estamos desarrollando una versión más ágil para abrirlo a más empresas.
En nuestro estudio QMSum, un modelo de 1,2B entrenado para resumir reuniones a partir de una consulta tuvo un costo estimado de servicio de 0,00053 USD por consulta, frente a 0,104 USD de Claude Opus 5 y 0,0130 USD de GPT-5.6 Luna con precios de lista síncronos. Respondió en 0,39 segundos frente a 9,0 segundos de Claude Opus 5. La estimación excluye el costo de entrenamiento, y cada tarea es distinta, por eso cada cambio espera a tus propias evaluaciones. Para la aritmética del punto de equilibrio en una tarea concreta, consulta cuándo un modelo personalizado supera en costo a una API de frontera.
¿En qué orden conviene aplicar estas correcciones?
- Instrumenta primero: el registro por ejecución, el costo por ejecución exitosa, la mediana y el p95.
- Recorta y estructura la salida de las herramientas, normalmente la partida más grande de una ejecución.
- Cachea el prefijo estático y corrige todo lo que en el prompt lo rompa.
- Añade límites de pasos, de gasto y de bucles, cada uno terminando en un traspaso.
- Limpia o compacta los resultados antiguos de herramientas en las ejecuciones largas.
- Acota los subagentes y pasa los tipos de paso rutinarios a niveles más baratos que superen sus evaluaciones por paso.
- Dales un modelo propio a los tipos de paso de mayor volumen.
Vuelve a revisar el registro después de cada cambio y lee juntos el costo por ejecución exitosa y la tasa de éxito. Un ahorro que baja la tasa de éxito suele costar más de lo que ahorra.
Preguntas Frecuentes
¿Cuántos tokens más que un chat usan los agentes de IA?
Según los datos de Anthropic, publicados en junio de 2025, los agentes solían usar unas 4 veces más tokens que las interacciones de chat, y los sistemas multiagente unas 15 veces más. El multiplicador viene del bucle: cada paso reenvía el prefijo y el historial completo de los pasos anteriores.
¿Qué encarece más los tokens de un agente de IA?
El contexto reenviado. Los resultados de herramientas y el prefijo estático se vuelven a facturar en cada paso, así que los tokens de entrada suelen ser la mayor parte de la factura de un agente. En la ejecución ilustrativa de esta guía, la entrada fue el 93% del costo con los precios de lista de Claude Opus 5 a octubre de 2026.
¿Funciona la caché de prompts con agentes de IA?
Los agentes son el mejor caso, porque el mismo prompt del sistema y las mismas definiciones de herramientas se reenvían en cada paso en cuestión de minutos. Mantén fijas y en orden las definiciones de herramientas, deja los datos variables fuera del prompt del sistema y cuenta con que limpiar resultados antiguos invalida el historial en caché desde ese punto.
¿Cómo evitas que un agente acumule una factura grande?
Comprueba un límite de pasos y un límite de gasto antes de cada llamada a la API, detén las ejecuciones que repiten la misma petición a una herramienta y cierra cada ejecución detenida con un traspaso a una persona o a una vía más simple. Fija los límites a partir del p95 de las ejecuciones exitosas y revísalos cuando cambie el agente.
¿Todos los pasos de un agente deben usar el mismo modelo?
La planificación y la respuesta final suelen necesitar el modelo más fuerte, mientras que los pasos rutinarios como la extracción y la clasificación a menudo pasan con un nivel más barato. Prueba cada tipo de paso con su propia evaluación y mueve solo los tipos que pasen.
¿Cuándo tiene sentido un modelo personalizado dentro de un agente?
Cuando un tipo de paso se ejecuta miles de veces al día, su salida se puede comprobar automáticamente y la tarea se mantiene estable de una semana a otra. Esos pasos pueden pasar a un modelo entrenado para ellos detrás de un endpoint de modelo adaptativo, mientras los modelos de frontera se quedan con los casos difíciles.
La Versión Corta
El costo de un agente es sobre todo contexto reenviado en cada paso. Mide el costo por ejecución exitosa con su mediana y su p95, recorta y estructura la salida de las herramientas, cachea el prefijo estático, limpia los resultados antiguos, limita cada ejecución con un traspaso limpio y mantén acotados los subagentes. Después pasa a modelos más baratos los tipos de paso rutinarios que tu agente más repite, empezando por un modelo entrenado para el más frecuente.
Si un paso de tu agente domina tu factura, agenda una llamada y lo revisamos contigo.
Fuentes: Anthropic, How we built our multi-agent research system, edición de contexto de Anthropic, compactación de Anthropic, presupuestos de tarea de Anthropic, caché de prompts de Anthropic, precios de Anthropic y precios de la API de OpenAI. Precios y funciones verificados el 6 de octubre de 2026.