


El costo por tarea de IA es el gasto total en modelos detrás de una unidad de trabajo terminada, como un ticket resuelto o una reclamación procesada, contando cada llamada a la API, reintento y escalamiento que necesitó. El costo mensual es tareas por costo por tarea, y así sabes si la factura creció con el negocio o con el desperdicio.
El recuento de tokens es una medida de ingeniería. Quien decide si una carga de trabajo de IA se paga sola necesita el costo del trabajo en sí, junto a lo que ese trabajo cuesta hoy. La FinOps Foundation describe la misma evolución para la IA generativa: la economía unitaria suele empezar con el costo por token y avanza hacia medidas de resultado, como el costo por acción de un agente o por caso desviado.
Esta guía explica cómo calcular el costo por tarea, cuánto cuesta un agente de IA al mes, cómo fijar un objetivo y un tope, y por qué la cifra se mueve. Para las palancas que lo reducen, consulta cómo reducir costos de tokens de IA en tu empresa y la visión de ingeniería en optimización de costos de LLM: 12 técnicas.
¿Qué es el costo por tarea de IA?
El costo por tarea de IA es lo que gastas en modelos para un tipo de trabajo, dividido entre las unidades de ese trabajo completadas. Está en lo alto de una escalera de medidas, y cada una le sirve a una persona distinta.
| Medida | Qué cuenta | Para qué sirve |
|---|---|---|
| Costo por token | Precio de una unidad de uso del modelo | Comparar modelos y proveedores |
| Costo por llamada a la API | Tokens de una solicitud y su respuesta | Depurar un solo paso |
| Costo por tarea | Todas las llamadas a la API de una tarea | Prever la factura mensual |
| Costo por tarea exitosa | Gasto total entre tareas que cumplen el nivel | Decidir si la IA compensa |
La última fila es la que hay que gestionar. El costo por tarea exitosa cuenta todo lo que consumió el trabajo:
- Cada llamada a la API que hizo la tarea, en cada paso de la ejecución de un agente
- Los reintentos tras una respuesta fallida o mal formada
- Los escalamientos a un modelo más potente y más caro
- El tiempo de personas que revisan resultados o terminan las tareas que la IA les pasó
Divide ese total entre las tareas que cumplieron tu nivel de calidad. Una ejecución fallida también costó dinero, y ese costo recae sobre las tareas que salieron bien.
¿Cómo se calcula el costo por tarea de IA?
Empieza por un tipo de tarea y un mes de tráfico. Este es un ejemplo práctico para un agente de soporte, con cada supuesto a la vista.
| Supuesto | Valor |
|---|---|
| Tarea | Resolver un ticket de soporte al cliente |
| Volumen | 100,000 tickets al mes |
| Modelo | Claude Opus 5, $5 entrada y $25 salida por 1M tokens |
| Una ejecución del agente | 5 llamadas a la API, 40,000 tokens de entrada y 2,000 de salida |
| Repeticiones | 1 de cada 5 tickets necesita una segunda ejecución |
| Resueltos por el agente | El 80% de los tickets cumple el nivel de calidad |
Los precios son los precios de lista de Anthropic a octubre de 2026. La cifra de salida incluye los tokens de pensamiento, porque los modelos de razonamiento facturan su pensamiento como salida, como indica la guía de razonamiento de OpenAI para sus propios modelos. El ejemplo deja fuera el almacenamiento en caché de prompts para que la aritmética se vea con claridad.
- Una ejecución. 40,000 tokens de entrada a $5 por millón son $0.20, y 2,000 tokens de salida a $25 por millón son $0.05. Una ejecución cuesta $0.25.
- Un ticket. Si uno de cada cinco tickets se ejecuta dos veces, el ticket medio necesita 1.2 ejecuciones, así que cuesta $0.30.
- Un ticket resuelto. El mes cuesta 100,000 × $0.30 = $30,000. El agente resuelve 80,000 tickets, así que cada ticket resuelto cuesta $30,000 ÷ 80,000 = $0.375.
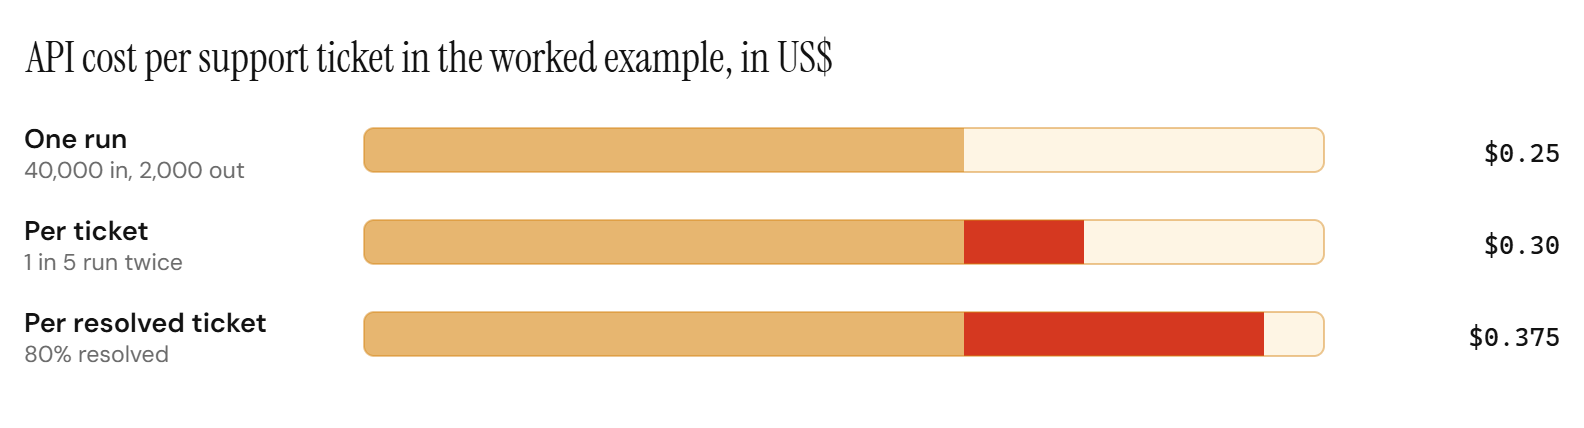
El costo por ticket resuelto es un 50% mayor que el costo de una ejecución, y toda la diferencia viene de trabajo repetido o fallido. La calidad pesa más que el precio en esa brecha: si el agente resolviera el 70% de los tickets en lugar del 80%, el costo por ticket resuelto subiría a unos $0.43 sin que cambiara el precio de ningún token.
Los otros 20,000 tickets pasan a tu equipo de soporte, y su costo vuelve a entrar cuando comparas la vía de IA con tu proceso actual.
¿Cuánto cuesta un agente de IA al mes?
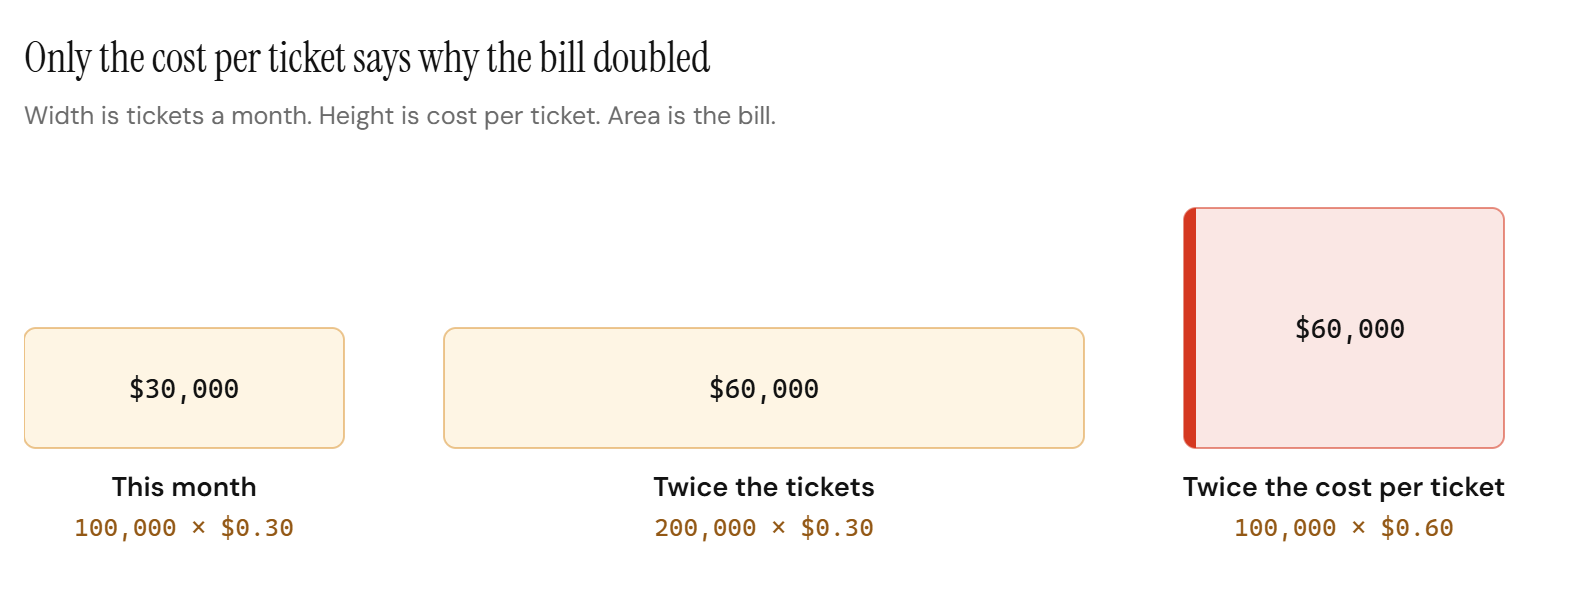
Un agente de IA cuesta su volumen mensual de tareas multiplicado por su costo por tarea. En el ejemplo, 100,000 tickets a $0.30 son $30,000 al mes en llamadas a la API a precios de lista de octubre de 2026. El mismo agente con 10,000 tickets cuesta $3,000, y con un millón de tickets cuesta $300,000. Cualquier cifra mensual que se dé sin un volumen y un costo por tarea omite justo los dos números que la determinan.
Separar la factura en esos dos números también te dice por qué cambió.
Para decidir si el agente compensa, pon su costo junto a lo que cuesta hoy ese mismo ticket. Toma tu costo total actual por ticket atendido por una persona, llámalo H, de tus informes de soporte u operaciones. La vía de IA cuesta entonces:
Vía de IA, por ticket = costo de IA por ticket
                      + proporción escalada a una persona x H
                      + tiempo de revisión por ticket
En el ejemplo eso es $0.30 + 0.2 × H, más las revisiones puntuales que mantengas sobre los tickets resueltos. La vía de IA sale ganando cuando $0.30 más el tiempo de revisión queda por debajo de 0.8 × H con el mismo nivel de calidad. Pon tu propio H y la decisión cabe en una línea, que es justo para lo que sirve medir por tarea. Nuestra guía sobre human-in-the-loop para agentes de IA explica dónde conviene colocar esas revisiones.
¿Cómo se fija un objetivo de costo por tarea?
Dale a cada tipo de tarea en producción dos números: un objetivo con el que planifica el negocio y un tope que el código hace cumplir.
| Ajuste | Qué es | Quién lo gestiona |
|---|---|---|
| Objetivo | Costo por tarea exitosa con el que planificas | Responsable de negocio de la tarea |
| Tope | Lo máximo que puede gastar una ejecución | Ingeniería, aplicado en el código |
| Frecuencia de revisión | Cuándo se compara lo real con el objetivo | Finanzas con el responsable de la tarea |
Fija el objetivo a partir del costo actual. Trabaja hacia atrás desde la comparación anterior. Si la vía de IA tiene que quedar bastante por debajo del costo actual por ticket para justificar el cambio, ese margen define el objetivo. En el ejemplo, un objetivo de $0.40 por ticket resuelto deja al agente dentro, en $0.375, con poco margen. Si uno de cada tres tickets necesitara una segunda ejecución en lugar de uno de cada cinco, el costo por ticket resuelto subiría a unos $0.42 y superaría el objetivo.
Fija el tope a partir de la ejecución típica. Un tope es un límite estricto de pasos y tokens por ejecución, para que un agente atascado en un bucle no gaste sin límite. Con una ejecución típica de $0.25, un tope de $1.00 por ejecución deja espacio para los tickets largos y detiene los descontrolados. Una ejecución que llega al tope debería pasar el ticket a una persona.
Los topes por ejecución y las asignaciones por equipo funcionan juntos. Nuestra guía para fijar un presupuesto de tokens de IA para tus equipos cubre la parte de los equipos, y la guía de planificación del presupuesto de IA empresarial muestra dónde encajan estos números en un plan anual.
¿Por qué cambia el costo por tarea de IA de un mes a otro?
El costo por tarea se mueve por cuatro motivos, y cada uno necesita una señal distinta para detectarlo.
| Origen | Qué se mueve | Qué vigilar |
|---|---|---|
| Variación de pasos del agente | Pasos e historial reenviado por ejecución | Costo por ejecución en el percentil 95 |
| Cambios de modelo | Precio, longitud de salida y tasa de éxito | Resultados de evaluación junto al costo por ejecución |
| Cambios de prompt | Tokens por llamada a la API | Costo por ejecución tras cada versión |
| Cambios de precio | Precio de lista por token | La fecha de cada precio que uses |
La variación de pasos es el origen más propio de los agentes. Un agente reenvía su historial en cada paso, así que una ejecución larga cuesta desproporcionadamente más. En el ejemplo, supón que la primera llamada a la API envía 6,000 tokens de instrucciones y ticket, que cada paso añade 1,000 tokens de historial y que cada llamada a la API escribe 400 tokens. Cinco pasos envían 40,000 tokens de entrada, que es la ejecución de $0.25. Una ejecución de doce pasos envía 138,000 tokens de entrada y escribe 4,800, y cuesta $0.81. La ejecución tuvo 2.4 veces los pasos y costó 3.2 veces más. Las soluciones de ingeniería están en nuestra guía de optimización de costos de IA agéntica.
Los cambios de modelo y de prompt mueven el costo y la calidad a la vez. Pasar la ejecución del ejemplo a Claude Sonnet 5.5 o a GPT-6.1 Sol, ambos a $2 y $10 por millón de tokens a octubre de 2026, la bajaría de $0.25 a $0.10, y el ahorro solo se mantiene mientras se mantenga la tasa de éxito. Una nueva versión de modelo también puede escribir respuestas más largas o resolver menos tareas, y cualquiera de las dos cosas sube el costo por tarea exitosa aunque baje el precio del token. Vuelve a correr la evaluación y recalcula el costo por ejecución cada vez que cambie el modelo o el prompt.
Informa la mediana y un percentil alto por tipo de tarea. Un promedio esconde la cola larga de ejecuciones caras. Cada mes, informa para cada tipo de tarea:
- Tareas completadas y tasa de éxito
- Mediana del costo por ejecución, el caso típico
- Costo por ejecución en el percentil 95, la ejecución más cara de cada veinte
- Costo por tarea exitosa frente a su objetivo
La mediana te dice lo que cuesta normalmente el trabajo. El percentil 95 te dice si el tope está bien puesto, y una subida en él suele ser la primera señal de que algo cambió.
¿Cómo cambia el costo por tarea si el modelo es tuyo?
En una tarea de alto volumen, el mayor cambio individual en el costo por tarea viene de atenderla con un modelo personalizado entrenado para esa tarea. Un modelo entrenado para un solo trabajo lleva solo la capacidad que ese trabajo necesita, así que cada tarea cuesta menos de servir.
El costo por tarea también se vuelve más predecible. Tú decides cuándo cambia el modelo: cada nueva versión entra en producción solo después de superar tus evaluaciones, así que el lanzamiento de un modelo por parte de un proveedor deja sin cambios el costo unitario del tráfico que atiende el modelo personalizado. El volumen sigue moviendo la factura, y los cambios en el costo unitario ocurren en el calendario que tú apruebas.
Este es el trabajo que hace Ertas con el endpoint de modelo adaptativo. Un endpoint de modelo adaptativo es un único endpoint de API para una de tus tareas: al principio responden los modelos de frontera, un modelo personalizado entrenado con tus solicitudes y los comentarios de tu equipo toma el relevo cuando supera tus evaluaciones, y los casos difíciles siguen en los modelos de frontera.
La bajada del costo por tarea llega el día en que apruebas una versión, así que se ve con facilidad en un informe mensual.
Cada nueva versión se ejecuta primero en segundo plano sobre solicitudes reales, y nada cambia sin tu aprobación. Supervisamos el modelo y lo reentrenamos a medida que cambian tus tareas. Funciona gestionado por Ertas, en tu nube o en tus propias instalaciones, y es tuyo. Por ahora el endpoint funciona solo por invitación, y estamos desarrollando una versión más ágil para abrirlo a más empresas.
En el ejemplo de soporte, cada ticket que el modelo personalizado resuelve con el nivel exigido se atiende a su costo en lugar de la ejecución de $0.30 en un modelo de frontera, y cada ticket que deriva mantiene el precio de frontera. Como referencia de escala, en nuestro estudio QMSum publicado, un modelo entrenado para una tarea de resumen de reuniones tuvo un costo estimado de servicio de $0.00053 por consulta, frente a $0.104 de Claude Opus 5 y $0.0130 de GPT-5.6 Luna a precios de lista síncronos, y respondió en 0.39 segundos frente a 9.0 segundos de Claude Opus 5. La estimación no incluye el costo de entrenamiento. Cada tarea es distinta, y por eso cada cambio espera a tus evaluaciones. Para la aritmética del punto de equilibrio en tu propia tarea, consulta cuándo un modelo personalizado sale más barato que una API de frontera.
Preguntas Frecuentes
¿Cuál es la fórmula del costo por tarea de IA?
Suma el costo de cada llamada a la API que hizo un tipo de tarea en un mes, incluidos reintentos y escalamientos, y divídelo entre las tareas completadas. Para el costo por tarea exitosa, divide entre las tareas que cumplieron tu nivel de calidad y añade el tiempo de revisión humana que todavía necesitó el trabajo.
¿Qué presupuesto mensual necesita un agente de IA?
El costo mensual es el número de tareas al mes multiplicado por el costo por tarea. En nuestro ejemplo, un agente de soporte con Claude Opus 5 a precios de lista de octubre de 2026 cuesta $0.30 por ticket, así que 100,000 tickets al mes cuestan $30,000 en llamadas a la API. Tu cifra depende del volumen, el modelo, los pasos por ejecución y la frecuencia con que se repiten las ejecuciones.
¿Qué diferencia hay entre el costo por token y el costo por tarea?
El costo por token es el precio del uso del modelo y lo fija el proveedor. El costo por tarea es lo que te cuesta una unidad de trabajo, y depende de cuántos tokens y llamadas a la API necesita ese trabajo y de con qué frecuencia sale bien. Dos modelos con el mismo precio por token pueden tener costos por tarea muy distintos.
¿La revisión humana cuenta en el costo por tarea de IA?
Sí, en el costo por tarea exitosa. El tiempo dedicado a revisar resultados, corregirlos y terminar tareas derivadas forma parte de lo que cuesta la vía de IA, y dejarlo fuera hace que la IA parezca más barata de lo que es al compararla con tu proceso actual.
¿Por qué subió nuestro costo por tarea si el precio del token no cambió?
Normalmente porque cada tarea necesita ahora más tokens o más intentos. Ejecuciones de agente más largas, un cambio de prompt que añadió contexto, una versión de modelo que escribe respuestas más largas o una caída en la tasa de éxito suben el costo por tarea con el mismo precio por token. El costo por ejecución en el percentil 95 y la tasa de éxito muestran cuál fue.
¿Un modelo personalizado hace que los costos de IA sean fijos?
Un modelo personalizado hace que el costo por tarea sea más bajo y más predecible en la tarea que atiende, porque cada nueva versión entra en producción solo después de superar tus evaluaciones. El gasto sigue creciendo con el volumen, y los casos difíciles que van a modelos de frontera mantienen el precio de frontera.
La Versión Corta
Gestiona el gasto en IA por costo por tarea exitosa: cada llamada a la API, reintento, escalamiento y revisión detrás de una unidad de trabajo, dividido entre las unidades que cumplen tu nivel de calidad. El costo mensual es el número de tareas multiplicado por esa cifra. Informa la mediana y el percentil 95 por tipo de tarea, dale a cada tarea un objetivo y un tope, y dale a tu tarea de mayor volumen un modelo propio para que su costo sea más bajo y más predecible.
Si ya conoces tu costo por tarea y quieres bajarlo, agenda una llamada y lo trabajamos contigo.
Fuentes: FinOps Foundation, Unit Economics, precios de Anthropic, precios de la API de OpenAI y guía de razonamiento de OpenAI. Precios verificados el 6 de octubre de 2026.