


Las técnicas de optimización de costos de LLM con mayor efecto son, en este orden: servir una tarea de alto volumen con un modelo personalizado, ajustar el modelo a cada tarea, enrutar las solicitudes entre modelos, procesar por lotes el trabajo que puede esperar y la caché de prompts. Mide primero el costo por tarea, porque cada técnica de esta lista se juzga con esa cifra.
Esta guía clasifica doce técnicas según cuánto ahorran en el tráfico que tocan, con el esfuerzo y el riesgo de calidad de cada una. Los precios son precios de lista de OpenAI y Anthropic a octubre de 2026. Para la visión de gestión del mismo problema, consulta cómo reducir costos de tokens de IA en tu empresa.
¿Qué es la optimización de costos de LLM?
La optimización de costos de LLM es la práctica de reducir lo que cuesta cada tarea completada en uso de modelos, ya sea enviando menos tokens, enviándolos a modelos más baratos o pagando una tarifa menor por ellos, sin bajar del nivel de calidad acordado. La unidad que hay que gestionar es el costo por tarea, porque un modelo barato que necesita tres reintentos puede costar más que uno caro que acierta a la primera.
Cada técnica actúa sobre un término del costo de una tarea:
costo por tarea = suma, sobre las llamadas a la API de la tarea, de
    tokens de entrada sin caché x precio de entrada
  + tokens de entrada en caché  x precio de caché
  + tokens de salida            x precio de salida   (el razonamiento cuenta como salida)
La tabla relaciona cada término con las técnicas que lo reducen.
| Término | Técnicas que lo reducen |
|---|---|
| Llamadas a la API por tarea | Límites de pasos de agentes, caché de respuestas |
| Tokens de entrada por llamada a la API | Recorte de contexto, compactación del historial, compresión de prompts |
| Precio por token de entrada | Caché de prompts, procesamiento por lotes, niveles más baratos |
| Tokens de salida por llamada a la API | Topes de salida, salida estructurada, esfuerzo de razonamiento |
| Precio por token de salida | Procesamiento por lotes, niveles más baratos, modelos personalizados |
Como las técnicas actúan sobre términos distintos, sus ahorros se multiplican. Guardar el prefijo en caché, limitar la salida y pasar a un nivel más barato se acumulan sobre la misma llamada a la API.
¿Cómo se mide el costo por tarea de un LLM?
Registra el uso de tokens en cada llamada a la API con un ID de tarea y un tipo de tarea, y luego agrégalo por tarea completada. Ambos proveedores devuelven el uso en cada respuesta, así que bastan unas pocas líneas de código:
# USD por millón de tokens, precios de lista a octubre de 2026.
PRICES = {
    "claude-opus-5": {"input": 5.00, "cache_read": 0.50, "cache_write": 6.25, "output": 25.00},
    "gpt-6-luna": {"input": 0.10, "cache_read": 0.01, "cache_write": 0.125, "output": 0.50},
}

def api_call_cost(model, uncached_in, cache_read, cache_write, output):
    p = PRICES[model]
    return (
        uncached_in * p["input"]
        + cache_read * p["cache_read"]
        + cache_write * p["cache_write"]
        + output * p["output"]
    ) / 1_000_000
Revisa cómo cuenta cada proveedor los tokens en caché antes de fiarte de los totales. La documentación de caché de prompts de Anthropic informa input_tokens como solo los tokens posteriores al último punto de corte de la caché, con cache_read_input_tokens y cache_creation_input_tokens al lado, así que la entrada total es la suma de los tres. Comprueba en los campos de uso de tus otros proveedores si los tokens en caché están dentro del recuento de entrada o al lado, o tu panel los contará dos veces.
Informa el costo por tarea exitosa: el costo de todas las llamadas a la API que hizo una tarea, incluidos reintentos y escalados, dividido entre las tareas que alcanzaron el nivel de calidad. Esa es la cifra que cada técnica de esta lista tiene que mover.
¿Qué técnicas de optimización de costos de LLM ahorran más?
La clasificación ordena las técnicas según el ahorro en el tráfico que toca cada una. Tu ahorro total depende de a qué parte de tu tráfico se aplica cada una.
| Puesto | Técnica | Ahorro en el tráfico afectado | Esfuerzo | Riesgo de calidad |
|---|---|---|---|---|
| 1 | Modelo personalizado para una tarea de alto volumen | Hasta 99% en nuestro estudio | Alto | Controlado por una evaluación |
| 2 | Ajuste del modelo a la tarea | De 10x a 100x entre niveles | Bajo | Medio, requiere una evaluación |
| 3 | Enrutamiento y cascadas | Depende de la parte desviada | Medio | Medio |
| 4 | Procesamiento por lotes | 50% de entrada y salida | Bajo | Ninguno |
| 5 | Caché de prompts | 90% o más en la entrada en caché | Bajo | Ninguno |
| 6 | Topes de salida y salida estructurada | La salida cuesta 5x la entrada | Bajo | Bajo |
| 7 | Control del esfuerzo de razonamiento | Menos tokens de razonamiento facturados | Bajo | Medio |
| 8 | Recorte de contexto y ajuste de la recuperación | Proporcional a los tokens eliminados | Medio | Medio |
| 9 | Compactación del historial | Crece con la longitud de la conversación | Medio | Bajo a medio |
| 10 | Límites de pasos de agentes y de salida de herramientas | Varía según el flujo | Medio | Bajo |
| 11 | Caché de respuestas | Costo completo de las solicitudes repetidas | Medio | Bajo |
| 12 | Compresión de prompts | Pequeño, solo en las instrucciones | Bajo | Bajo |
Los puestos 4 a 7 son cambios de configuración que la mayoría de los equipos puede lanzar en una semana. Los puestos 1 a 3 cambian qué modelo hace el trabajo, así que necesitan una evaluación antes de mover tráfico.
1. Servir una tarea de alto volumen con un modelo personalizado
Cuando una sola tarea, como la clasificación de tickets, la extracción de documentos o el resumen de conversaciones con clientes, representa una gran parte de tus llamadas a la API, un modelo entrenado para esa tarea puede servirla por una fracción del costo de frontera. Un modelo entrenado para un solo trabajo lleva solo la capacidad que ese trabajo necesita, así que servirlo cuesta menos por token y responde más rápido.
En nuestro estudio QMSum, un modelo de 1.2B entrenado para resumir reuniones a partir de consultas tuvo un costo estimado de servicio de $0.00053 por consulta en una GPU alquilada en la nube, frente a $0.104 de Claude Opus 5 y $0.0130 de GPT-5.6 Luna a precios de lista síncronos. Respondió en 0.39 segundos en una sola GPU, frente a 9.0 segundos de Claude Opus 5 a través de la API. La estimación excluye el costo de entrenamiento y la calidad depende de cada tarea, y por eso el cambio que se describe más abajo se condiciona a tus propias evaluaciones.
Es la técnica que más esfuerzo exige de la lista, porque necesita una tarea estable, suficiente tráfico real del que aprender, una evaluación que defina el nivel de calidad y una forma segura de mover el tráfico. La sección sobre cuándo una tarea merece su propio modelo, más abajo, cubre esa decisión.
2. Ajustar el modelo a cada tarea
La diferencia de precio entre niveles es la palanca más grande que la mayoría de los equipos todavía no ha usado. Estos son los precios de lista de octubre de 2026 por millón de tokens de las familias actuales.
| Proveedor | Modelo | Entrada | Salida |
|---|---|---|---|
| OpenAI | GPT-6 Astra | $10.00 | $50.00 |
| OpenAI | GPT-6.1 Sol | $2.00 | $10.00 |
| OpenAI | GPT-6 Luna | $0.10 | $0.50 |
| Anthropic | Claude Fable 5.1 | $10.00 | $50.00 |
| Anthropic | Claude Opus 5 | $5.00 | $25.00 |
| Anthropic | Claude Sonnet 5.5 | $2.00 | $10.00 |
| Anthropic | Claude Haiku 4.5 | $1.00 | $5.00 |
Dentro de cada familia, el nivel superior cuesta entre 10x y 100x lo que el inferior por token de salida, así que una tarea que funciona en un nivel más bajo supone un gran ahorro por un cambio de una línea.
El método es una evaluación: unos cientos de entradas reales con salidas correctas conocidas y una regla de puntuación. Prueba cada nivel candidato con ella, elige el más barato que alcance el nivel de calidad y vuelve a ejecutarla cada vez que un proveedor lance un modelo nuevo, porque el nivel más barato que aprueba cambia con cada lanzamiento.
3. Enrutar las solicitudes o encadenarlas en cascada
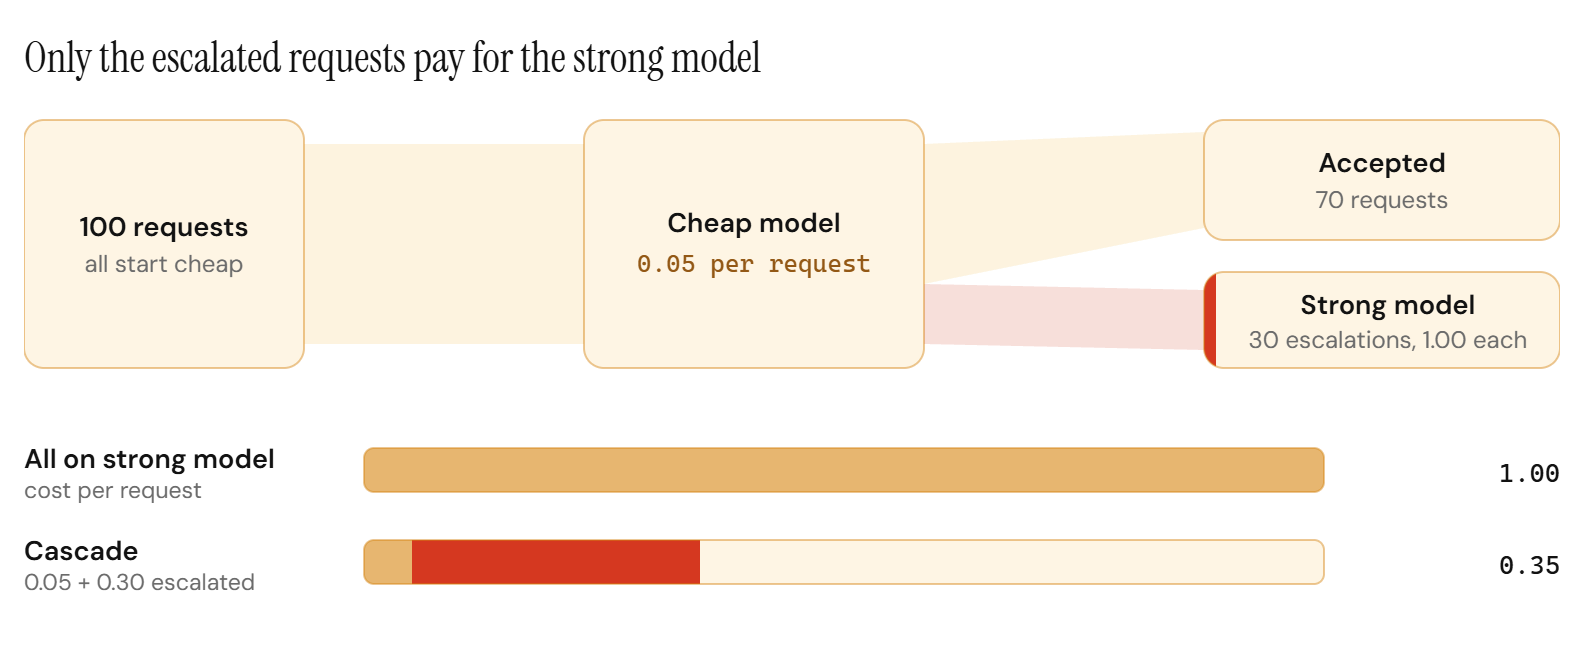
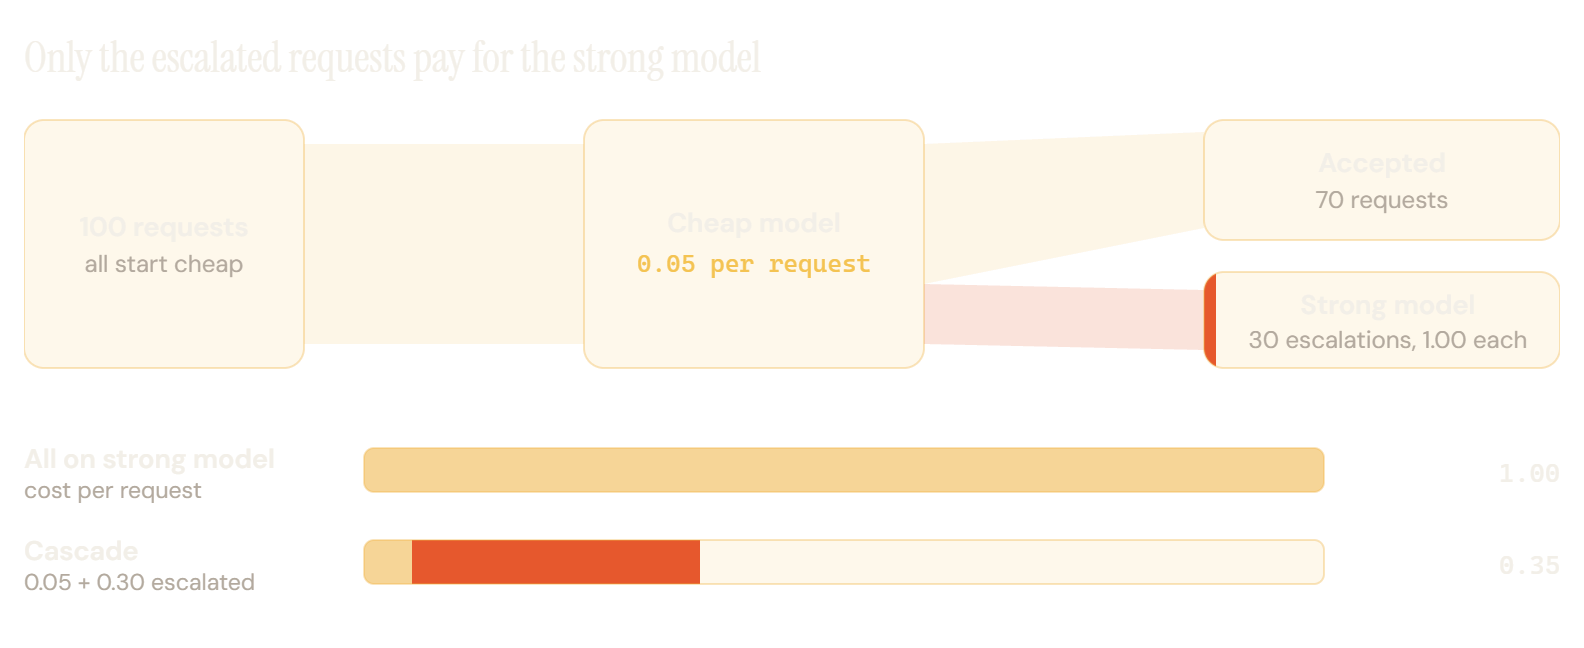
El enrutamiento envía cada solicitud a un modelo elegido de antemano, por etiqueta de tarea o mediante un clasificador. Una cascada prueba primero el modelo barato y escala a uno más potente cuando la respuesta no pasa la validación o un control de confianza.
La aritmética de la cascada es sencilla. Si el modelo barato cuesta el 5% del potente y escala el 30% de las solicitudes, el costo esperado es 0.05 + 0.30 = 0.35 del costo de enviarlo todo al modelo potente, un ahorro del 65%. El ahorro desaparece a medida que sube la tasa de escalado, así que mídela por tipo de tarea.
Enruta primero con etiquetas de tarea explícitas, como una cabecera o un endpoint por cada paso del flujo, y añade un enrutador aprendido solo cuando tengas tráfico etiquetado con el que entrenarlo y medirlo. Una solicitud mal enrutada cuesta calidad, y predecir la dificultad es un problema difícil por sí mismo. Nuestros artículos anteriores sobre el patrón de enrutamiento 80/20 SLM-first y sobre cómo elegir entre modelos ajustados, API y RAG profundizan en la arquitectura. Para comparar las estrategias de enrutamiento y ver cómo mover tráfico a un modelo más barato sin riesgo, consulta enrutamiento de LLM para reducir costos de API.
4. Procesar por lotes todo lo que puede esperar
A octubre de 2026, OpenAI y Anthropic cobran el procesamiento por lotes al 50% de la tarifa estándar en tokens de entrada y de salida, y OpenAI fija su nivel Flex en las mismas tarifas que Batch para la familia GPT-6. Las ejecuciones de evaluación, la recarga de datos históricos, los resúmenes nocturnos, los trabajos de enriquecimiento y la clasificación de pendientes acumulados encajan aquí.
El costo de ingeniería es la fontanería asíncrona: escribe las solicitudes en un archivo con IDs personalizados estables, envíalo, consulta el estado o recibe un webhook, y luego concilia los resultados y reintenta los fallos parciales. Haz que cada solicitud sea idempotente para que un reintento nunca escriba un resultado dos veces.
5. Guardar en caché el prefijo estable
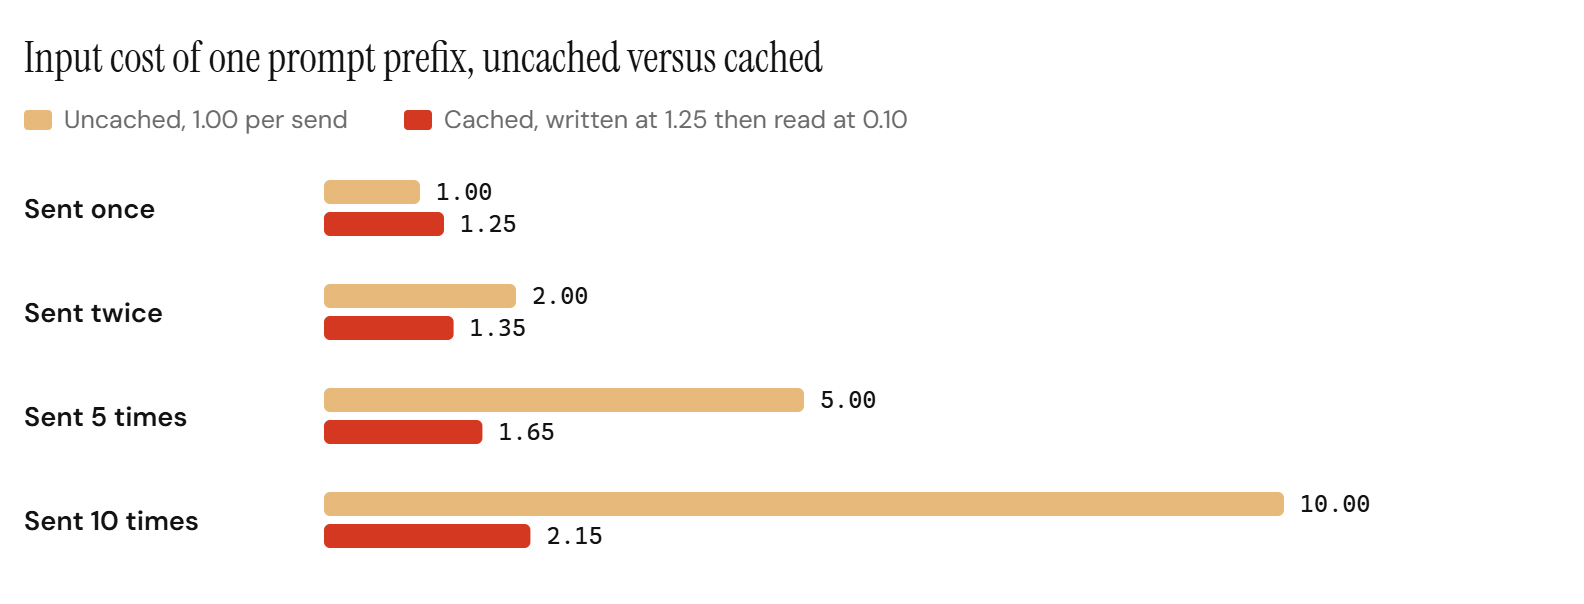
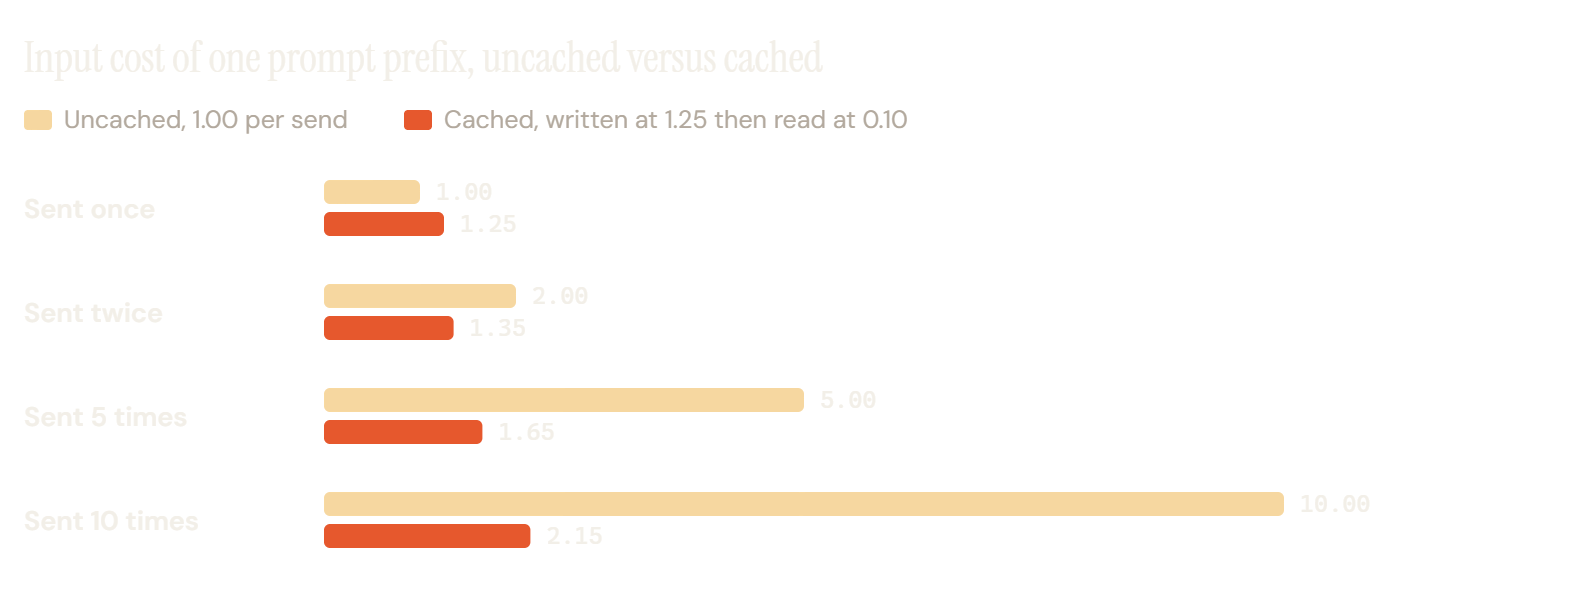
La caché de prompts guarda el prefijo ya procesado de un prompt para que las llamadas a la API posteriores que lo comparten se facturen a la tarifa de caché. A octubre de 2026, Anthropic factura los aciertos de caché a 0.1x el precio base de entrada en la mayoría de los modelos Claude, con escrituras en caché a 1.25x para una caché de 5 minutos y a 2x para una de 1 hora. OpenAI fija la entrada en caché de GPT-6 Astra y GPT-6 Luna en una décima parte de la entrada estándar, con escrituras en caché a 1.25x.
Con esos multiplicadores, la caché compensa desde la primera reutilización: dos llamadas a la API sin caché cuestan 2.0 unidades de entrada, mientras que una escritura más un acierto cuestan 1.25 + 0.1 = 1.35.
Para conseguir tasas de acierto altas:
- Pon primero el contenido estable: prompt de sistema, definiciones de herramientas, documentos de referencia. Deja el contenido variable para el final.
- Mantén las marcas de tiempo, los IDs de solicitud y los datos por usuario fuera del prefijo, porque cualquier cambio invalida todo lo que viene después.
- Mantén las definiciones de herramientas en un orden fijo.
- Comprueba la longitud mínima que se puede guardar en caché. La documentación de Anthropic indica 512 tokens para Claude Opus 5, así que los prompts cortos nunca entran en caché.
- Sigue la tasa de aciertos de caché por tipo de tarea, porque una refactorización que reordena un prompt puede bajarla a cero sin avisar.
La caché cambia el precio de la entrada y deja la salida intacta. Cuando la caché por sí sola ya no basta, nuestro artículo sobre pasar de la caché de prompts al fine-tuning cubre el siguiente paso.
6. Limitar la salida y usar salida estructurada
Los tokens de salida cuestan cinco veces más que los de entrada en las familias actuales de ambos proveedores: Claude Opus 5 a $5 y $25, GPT-6 Luna a $0.10 y $0.50 por millón. Fija una longitud máxima de salida en cada llamada a la API. Pide un esquema JSON con campos cortos y enums cuando quien consume la respuesta es código. Elimina instrucciones como "explica tu razonamiento" de los prompts de producción cuando solo se usa la etiqueta final.
7. Controlar el esfuerzo de razonamiento
La guía de razonamiento de OpenAI indica que los tokens de razonamiento se facturan como tokens de salida aunque la API nunca los devuelva, y Anthropic informa los tokens de pensamiento como parte de la salida facturada. Ejecuta tu evaluación con cada nivel de esfuerzo de razonamiento o presupuesto de pensamiento y usa el ajuste más bajo que apruebe.
El parámetro max_output_tokens de OpenAI limita a la vez el razonamiento y la salida visible, y su guía advierte que una respuesta puede detenerse antes de producir salida visible y aun así facturar los tokens de entrada y de razonamiento. Dimensiona el tope con margen y vigila las respuestas incompletas.
8. Recortar el contexto y ajustar la recuperación
Cada token del prompt se factura en cada llamada a la API. En los pipelines de recuperación, recupera en amplitud, reordena y envía solo los primeros fragmentos. Elimina los fragmentos que se solapan y quita el contenido de relleno, como textos de navegación, cabeceras y marcado, de los documentos de origen antes de indexarlos.
Las ventanas de contexto largas hacen que esto sea fácil de descuidar. A octubre de 2026, Anthropic factura su contexto completo de 1M tokens a las tarifas estándar por token, así que una solicitud de 900 mil tokens cuesta cien veces lo que una de 9 mil. Un contexto más largo también degrada la calidad de las respuestas mucho antes de llenar la ventana, como explicamos en el problema de la longitud de contexto efectiva.
9. Compactar el historial de conversaciones y de agentes
Los productos de chat y los agentes reenvían la conversación en cada turno. Si cada turno añade un número similar de tokens, la entrada total de una conversación crece con el cuadrado de su longitud, porque el turno n reenvía los n turnos anteriores.
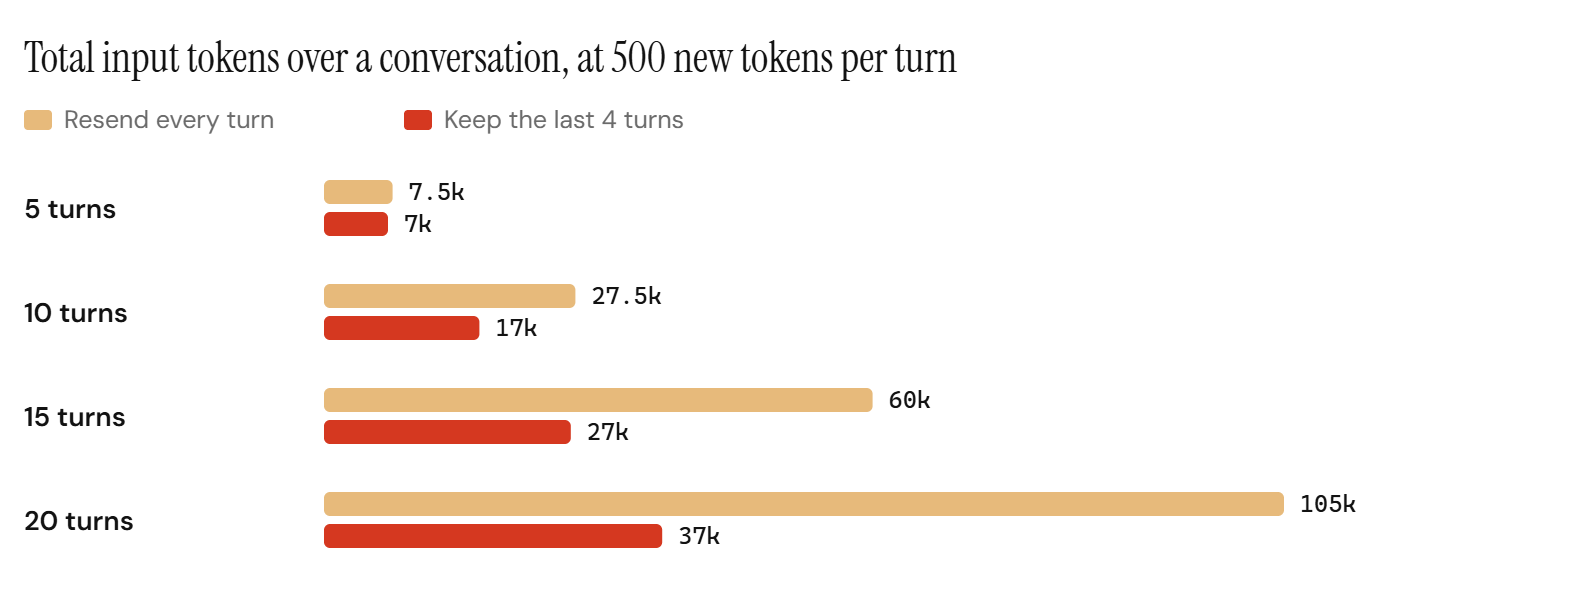
Mantén una ventana deslizante con los turnos recientes, resume los turnos antiguos en un bloque de estado corto y descarta las salidas de herramientas cuando el agente ya las haya usado. La caché baja el precio del historial reenviado, pero el número de tokens sigue creciendo, así que compactar sigue valiendo la pena en sesiones largas.
10. Limitar los pasos de los agentes y la salida de las herramientas
La duración de las ejecuciones de agentes varía mucho, y la cola larga es la que impulsa la factura. Limita los pasos por ejecución, fija un presupuesto de tokens por ejecución y termina con un traspaso cualquier ejecución que alcance uno de los dos límites. Recorta la salida de las herramientas en la propia herramienta: devuelve las filas que coinciden, la función relevante o los primeros resultados, nunca el archivo o la tabla completos. Registra los tokens por ejecución exitosa junto con la tasa de éxito, para que un cambio de prompt que alarga las ejecuciones sea visible el mismo día que se publica. Nuestra guía de optimización de costos de IA agéntica aplica estas correcciones a una ejecución completa de un agente, paso a paso.
11. Guardar en caché respuestas completas para solicitudes repetidas
Cuando la misma solicitud llega una y otra vez, como la respuesta a una pregunta frecuente o la clasificación de una entrada conocida, sirve la respuesta guardada y evita por completo la llamada a la API. Usa como clave de la caché la entrada normalizada, el modelo y la versión del prompt, e invalídala cuando cambie cualquiera de las dos versiones.
La caché semántica, que empareja solicitudes casi duplicadas por similitud de embeddings, aumenta la tasa de aciertos a costa de servir de vez en cuando la respuesta a una pregunta distinta. Usa un umbral de similitud estricto y limítala a cargas de trabajo en las que una coincidencia cercana sea una respuesta aceptable.
12. Comprimir los prompts
Las instrucciones más cortas y menos ejemplos few-shot reducen los tokens de entrada en cada llamada a la API. El ahorro es real pero pequeño, y menor todavía cuando el prefijo ya está en caché a una décima parte del precio. Hazlo después de la caché y vuelve a ejecutar la evaluación tras cada recorte, porque los ejemplos few-shot suelen aportar más calidad de lo que sugiere su longitud.
¿Cuándo merece una tarea de alto volumen su propio modelo?
Una tarea merece su propio modelo cuando se ejecuta con un volumen alto y estable, la definición de una buena salida no cambia y una evaluación puede puntuarla automáticamente. Compara con el precio de frontera que realmente pagarías, incluidos los descuentos por lotes para el trabajo asíncrono, porque esa es la alternativa real. El cálculo del punto de equilibrio está en modelo personalizado vs API de frontera: costos.
| Señal | Apunta hacia un modelo personalizado |
|---|---|
| Volumen | Miles de llamadas a la API al día en una tarea |
| Estabilidad | Mismas entradas y formato de salida cada semana |
| Medición | Una evaluación que puntúa las salidas automáticamente |
| Latencia | El tiempo de respuesta importa a los usuarios |
| Ubicación de los datos | Deben quedarse en tu nube u on-premise |
Cuando la mayoría de estas señales están presentes, la pregunta que queda es el costo de operar el modelo a lo largo del tiempo. Un modelo personalizado es un pipeline que hay que operar: recopilar y depurar datos de entrenamiento, entrenar, evaluar cada candidato, servirlo, vigilar la deriva y reentrenarlo a medida que cambia la tarea. El entrenamiento en sí es la parte más pequeña de ese trabajo.
El endpoint de modelo adaptativo opera ese pipeline por ti. Un endpoint de modelo adaptativo es un único endpoint de API para una de tus tareas: los modelos de frontera responden al principio, un modelo personalizado entrenado con tus solicitudes y los comentarios de tu equipo toma el relevo cuando supera tus evaluaciones, y los casos difíciles siguen en los modelos de frontera.
El código de tu aplicación no cambia cuando sale una nueva versión, así que reentrenar no exige ningún despliegue por tu parte.
En la práctica:
- Apuntas la tarea al endpoint cambiando un nombre de modelo. Los modelos de frontera atienden todas las solicitudes al principio, así que nada espera al entrenamiento.
- Cada nueva versión del modelo personalizado se ejecuta en segundo plano con solicitudes reales y se puntúa con tus evaluaciones.
- Nada cambia sin tu aprobación. Cuando una versión aprueba, una parte creciente de las solicitudes pasa a ella, y los casos difíciles siguen en los modelos de frontera.
- Nosotros supervisamos el modelo y lo reentrenamos a medida que cambian tus tareas, y cada nueva versión pasa por el mismo control.
El modelo funciona gestionado por Ertas, en tu nube u on-premise, y es tuyo. Por ahora el endpoint funciona solo por invitación, y estamos desarrollando una versión más ágil para abrirlo a más empresas.
Preguntas Frecuentes
¿Cuál es la forma más rápida de reducir los costos de LLM?
El procesamiento por lotes y la caché de prompts, porque ambos son cambios de configuración que no afectan a la calidad de la salida. A octubre de 2026, el procesamiento por lotes cuesta un 50% menos en OpenAI y Anthropic, y la entrada en caché se factura a una décima parte del precio de entrada estándar o menos en la mayoría de los modelos actuales.
¿La caché de prompts reduce los costos de salida?
La caché de prompts solo baja el precio de los tokens de entrada repetidos. Los tokens de salida, incluidos los de razonamiento, se facturan a la tarifa de salida completa, así que combina la caché con topes de salida y con un nivel de esfuerzo de razonamiento probado con tu evaluación.
¿Un modelo más barato siempre es más barato por tarea?
Un modelo más barato lo es por token, pero por tarea depende de los reintentos y los escalados. Un modelo que necesita varios intentos, o que escala la mayoría de sus solicitudes a un modelo más potente, puede perder su ventaja. Mide el costo por tarea exitosa, incluidos todos los reintentos y escalados.
¿Cuánto cuesta servir un modelo personalizado comparado con una API de frontera?
En nuestro estudio QMSum, un modelo de 1.2B entrenado para resumir reuniones tuvo un costo estimado de servicio de $0.00053 por consulta, frente a $0.104 de Claude Opus 5 y $0.0130 de GPT-5.6 Luna a precios de lista síncronos. Esa estimación excluye el costo de entrenamiento. Tus cifras dependen del tamaño del modelo, del volumen de tráfico y de lo bien que se aproveche el hardware de servicio.
¿Se pueden combinar estas técnicas de optimización de costos de LLM?
La mayoría se acumulan, porque actúan sobre términos distintos de la ecuación de costo. La caché baja el precio de la entrada, los topes de salida recortan los tokens de salida y el ajuste del modelo baja el precio de ambos, así que los ahorros se multiplican sobre la misma llamada a la API.
¿Necesito un equipo de machine learning para operar un modelo personalizado?
Operarlo por tu cuenta exige depuración de datos, entrenamiento, evaluación, servicio y reentrenamiento, lo que supone un compromiso de equipo real. Con un endpoint de modelo adaptativo, Ertas opera ese pipeline, tus ingenieros cambian un nombre de modelo y tu equipo aprueba cada cambio con sus propias evaluaciones.
La Versión Corta
Mide el costo por tarea exitosa antes de optimizar nada. Toma primero las mejoras de configuración: procesa por lotes lo que puede esperar, guarda en caché los prefijos estables y limita la salida y el razonamiento. Después pasa cada tarea al modelo más barato que apruebe su evaluación y dale a tu tarea de mayor volumen un modelo entrenado para ella.
Si una sola tarea domina tu factura de tokens, agenda una llamada y la analizamos contigo.
Fuentes: precios de la API de OpenAI, precios de Anthropic, documentación de caché de prompts de Anthropic y guía de razonamiento de OpenAI. Precios verificados el 6 de octubre de 2026.