


El enrutamiento de LLM reduce los costos de las API de frontera enviando cada solicitud al modelo más barato que cumple su nivel de calidad. Las estrategias, de la más simple a la más compleja, son el enrutamiento estático por tarea, las reglas, el enrutamiento semántico, los enrutadores aprendidos y las cascadas, con respaldos entre proveedores para la fiabilidad. Mueve el tráfico a un modelo más barato por etapas (sombra, canario y rampa), con una evaluación como control.
La diferencia de precios es lo que justifica construir un enrutador. A octubre de 2026, OpenAI cobra GPT-6 Astra a $10 por millón de tokens de entrada y $50 por millón de tokens de salida, y GPT-6 Luna a $0.10 y $0.50. Anthropic cobra Claude Opus 5 a $5 y $25, y Claude Haiku 4.5 a $1 y $5. Cada solicitud que un enrutador baja de nivel se factura a una fracción del precio.
Esta guía compara las estrategias, muestra cómo combinarlas y expone el plan para trasladar tráfico manteniendo estable la calidad mientras se mueve. El enrutamiento es la técnica 3 de nuestra clasificación de 12 técnicas de optimización de costos de LLM, que también cubre la aritmética de la cascada. Nuestros artículos anteriores sobre el patrón de enrutamiento 80/20 SLM-first y sobre cómo elegir entre modelos ajustados, API y RAG cubren la arquitectura. Para la visión de gestión de la misma factura, consulta cómo reducir costos de tokens de IA en tu empresa.
¿Qué es el enrutamiento de LLM?
El enrutamiento de LLM es una capa entre tu aplicación y sus modelos que decide, solicitud por solicitud, qué modelo responde. La aplicación envía la solicitud junto con lo que sabe de ella. El enrutador elige un destino, como un nivel de frontera, un nivel más barato, otro proveedor o un modelo personalizado, y devuelve la respuesta en un formato único y coherente.
Bajo la palabra "enrutamiento" hay tres decisiones distintas, y cada una se basa en una señal diferente.
| Decisión | Pregunta que responde | Señal que usa |
|---|---|---|
| Enrutamiento | ¿Qué modelo recibe primero la solicitud? | Etiqueta de tarea, atributos o contenido |
| Escalado | ¿Qué pasa si la respuesta falla? | Una comprobación de la respuesta |
| Respaldo | ¿Qué pasa si falla el proveedor? | Errores, tiempos de espera y límites de tasa |
Mantenerlas separadas permite probar cada una con sus propios criterios. Una regla de enrutamiento se juzga por el costo por tarea, una comprobación de escalado por cuántas respuestas malas detecta y un respaldo por lo rápido que se recupera de una caída.
Un enrutador también tiene un costo propio. Las reglas estáticas no añaden nada por solicitud, los enrutadores semánticos y aprendidos añaden un embedding o una pasada de clasificador a cada solicitud, y una cascada añade una segunda llamada a la API a cada escalado. Ese costo y esa latencia salen del ahorro que produce el enrutador, así que suele ganar la estrategia más simple que capture la mayor parte del ahorro.
¿Qué estrategias de enrutamiento de LLM existen?
Seis estrategias cubren casi todos los enrutadores en producción. Se diferencian en qué usan para decidir, qué añaden a cada solicitud y cómo fallan.
| Estrategia | Decide según | Añadido por solicitud | Riesgo principal |
|---|---|---|---|
| Enrutamiento estático por tarea | Etiqueta de tarea o endpoint | Nada | Un solo modelo para toda la tarea |
| Reglas y heurísticas | Atributos de la solicitud | Nada apreciable | Las reglas se desfasan con el tráfico |
| Enrutamiento semántico | Similitud con ejemplos etiquetados | Una solicitud de embedding | Coincidencias cercanas mal enrutadas |
| Enrutador aprendido | Clasificador entrenado con resultados | Una pasada de clasificador | Errores de ruta sin ningún aviso |
| Cascada | Una comprobación de la respuesta barata | Una llamada a la API por escalado | Latencia en las solicitudes escaladas |
| Respaldo entre proveedores | Errores y tiempos de espera | Nada hasta que algo falla | La calidad del respaldo varía |
1. Enrutamiento estático por tarea
Da a cada paso de un flujo de trabajo su propia ruta y fija el modelo de cada ruta en la configuración. Un flujo de soporte puede clasificar el ticket, extraer los datos del pedido, redactar una respuesta y resumir el caso para un agente humano. Cada uno de esos pasos es una ruta distinta con su propio modelo, su propia evaluación y su propio costo por tarea.
# Una ruta por paso del flujo. Cada ruta tiene su propia evaluación y su propio presupuesto.
ROUTES = {
    "classify_ticket": {"model": "gpt-6-luna", "fallback": "claude-haiku-4-5"},
    "extract_order": {"model": "claude-haiku-4-5", "fallback": "gpt-6.1-sol"},
    "draft_reply": {"model": "claude-sonnet-5-5", "fallback": "gpt-6.1-sol"},
    "case_summary": {"model": "claude-opus-5", "fallback": "gpt-6-astra"},
}

def route(task: str) -> dict:
    return ROUTES[task]
Los nombres de los modelos son ilustrativos. El modelo más barato que aprueba cada paso sale de ejecutar la evaluación de ese paso con cada candidato.
El enrutamiento estático captura una gran parte del ahorro con el menor riesgo. La aplicación ya sabe en qué paso está, así que nada tiene que adivinar, y cada ruta pasa a un modelo más barato con sus propias pruebas. Su límite es la granularidad: todas las solicitudes de una ruta van al mismo modelo, incluida la difícil de vez en cuando, y por eso el enrutamiento estático combina bien con una cascada dentro de cada ruta.
2. Reglas y heurísticas
Las reglas enrutan según atributos que la aplicación puede leer antes de que se ejecute ningún modelo: longitud de la entrada, idioma, tipo de documento, nivel del cliente y si hay adjuntos o herramientas de por medio. Una regla como "las entradas de más de 50,000 tokens van al modelo cuya calidad con contexto largo has probado" es barata de ejecutar y fácil de depurar.
Cada regla codifica una suposición sobre qué solicitudes son difíciles, y el tráfico cambia por debajo de ella. Registra qué regla se activó en cada solicitud, contrasta cada regla con los resultados de la evaluación para la parte del tráfico que gobierna y mantén el conjunto de reglas lo bastante corto como para que una sola persona del equipo de ingeniería pueda leerlo entero.
3. Enrutamiento semántico
El enrutamiento semántico genera el embedding de la solicitud entrante y lo compara con conjuntos de ejemplos etiquetados, uno por ruta. La solicitud va a la ruta cuyos ejemplos tiene más cerca, siempre que la similitud supere un umbral, y a una ruta por defecto cuando no supera ninguno.
Encaja con un único punto de entrada, como un chat o una dirección de correo de entrada, que recibe muchos tipos de solicitud. El costo es una solicitud de embedding y su latencia en cada solicitud. El riesgo es la coincidencia cercana: una solicitud que se parece a una rutinaria y resulta necesitar otra cosa. Usa un modelo de frontera como ruta por defecto, mantén un umbral estricto y trata todo lo que quede por debajo como fuera del alcance de las rutas más baratas.
4. Enrutadores aprendidos
Un enrutador aprendido es un clasificador que estima, para cada solicitud, si la respuesta de un modelo más barato será aceptable. Se entrena con resultados registrados de tu propio tráfico: solicitudes en las que la respuesta del modelo barato aprobó y solicitudes en las que falló.
Los resultados publicados en benchmarks son alentadores. RouteLLM, de investigadores de LMSYS en 2024, entrenó enrutadores con datos de preferencias humanas para elegir entre un modelo más potente y otro más débil. Informó reducciones de costos de más de 2 veces en ciertos casos en benchmarks ampliamente reconocidos sin comprometer la calidad de las respuestas, y sus enrutadores mantuvieron el rendimiento cuando se cambiaron los modelos fuerte y débil durante la prueba.
Con tu propio tráfico, la estimación de cualquier enrutador fallará en algunas solicitudes, y un error de ruta produce una respuesta peor sin ningún error que lo señale. Entrena un enrutador solo cuando tengas resultados etiquetados de tu propio tráfico, mantén una comprobación de la respuesta detrás de él y audita cada semana una muestra de sus decisiones contra la evaluación.
5. Cascadas con escalado por validación
Una cascada envía primero cada solicitud de una ruta al modelo más barato, comprueba la respuesta y escala a un modelo más potente cuando la comprobación falla. Una cascada vale lo que vale su comprobación, y las comprobaciones más sólidas son las que puede ejecutar el código.
- Comprobaciones de esquema: la salida se puede interpretar, los campos obligatorios están presentes y los valores de enumeración están dentro del conjunto permitido.
- Comprobaciones de coherencia: los totales extraídos cuadran, los ID citados existen en tu base de datos y las fechas están dentro del rango.
- Comprobaciones de alcance: la entrada pertenece a la tarea con la que se evaluó el modelo más barato.
- Señales de confianza: probabilidades de los tokens o una puntuación autodeclarada. Son más débiles que las comprobaciones anteriores, así que úsalas como una señal entre varias.
- Un modelo juez: un segundo modelo califica la respuesta. Detecta más, y su costo recae en cada solicitud que califica.
FrugalGPT, de investigadores de Stanford en 2023, planteó la cascada de LLM como una de tres estrategias para reducir el costo de inferencia y aprendió qué combinación de modelos usar para cada consulta. En sus experimentos igualó al mejor modelo individual de la época, GPT-4, con una reducción de costos de hasta el 98%.
La aritmética está en la técnica 3 de nuestra clasificación. Con un modelo más barato al 5% del precio del modelo potente y un 30% de solicitudes escaladas, la cascada cuesta 0.35 de lo que costaría enviarlo todo al modelo potente. La tasa de escalado decide el ahorro, y las solicitudes escaladas también esperan a dos modelos, así que las cascadas encajan con trabajos donde una respuesta más lenta de vez en cuando es aceptable.
Los casos difíciles llegan al modelo de frontera mediante este mecanismo, que decide con la información disponible en el momento de la solicitud. Una solicitud cuenta como difícil cuando su respuesta no pasa una comprobación, cuando queda fuera del alcance de la ruta o cuando su etiqueta de tarea la envía directamente a la ruta de frontera.
6. Respaldos entre proveedores
Los respaldos se ocupan de los fallos del proveedor. Tienen sitio en una guía de costos porque una ruta más barata sin respaldo es un punto único de fallo, y la primera caída devuelve al equipo al modelo caro por defecto para siempre. La referencia de errores de la API de Anthropic incluye un error 429 por límite de tasa y un error 529 por sobrecarga, que según la documentación puede producirse cuando la API recibe mucho tráfico de todos los usuarios. Todos los proveedores tienen equivalentes.
Da a cada ruta un modelo de respaldo en un segundo proveedor, con reintentos y espera exponencial antes del cambio y un disyuntor (circuit breaker) que deje de enviar solicitudes a un proveedor que sigue fallando. Hay dos detalles que suelen sorprender a los equipos.
- El modelo de respaldo también tiene que superar la evaluación de la ruta. Un respaldo que nunca se evaluó en la tarea cambia una caída visible por una pérdida de calidad que nadie ve.
- Las cachés de prompts se quedan con su proveedor. Un prefijo guardado en caché en un proveedor pierde su descuento cuando la solicitud pasa a otro, así que reserva presupuesto para un pico de costo durante la conmutación.
La misma referencia recomienda aumentar el tráfico de forma gradual para no alcanzar los límites de aceleración tras una subida brusca de uso. Es una razón más para mover el tráfico por etapas, como hace el plan de más abajo.
¿Cómo se combinan las estrategias de enrutamiento?
La mayoría de los enrutadores en producción apilan tres de las seis. El enrutamiento estático por tarea elige la ruta, una cascada dentro de cada ruta escala las respuestas que no pasan sus comprobaciones y los respaldos envuelven cada modelo con una alternativa en un segundo proveedor.
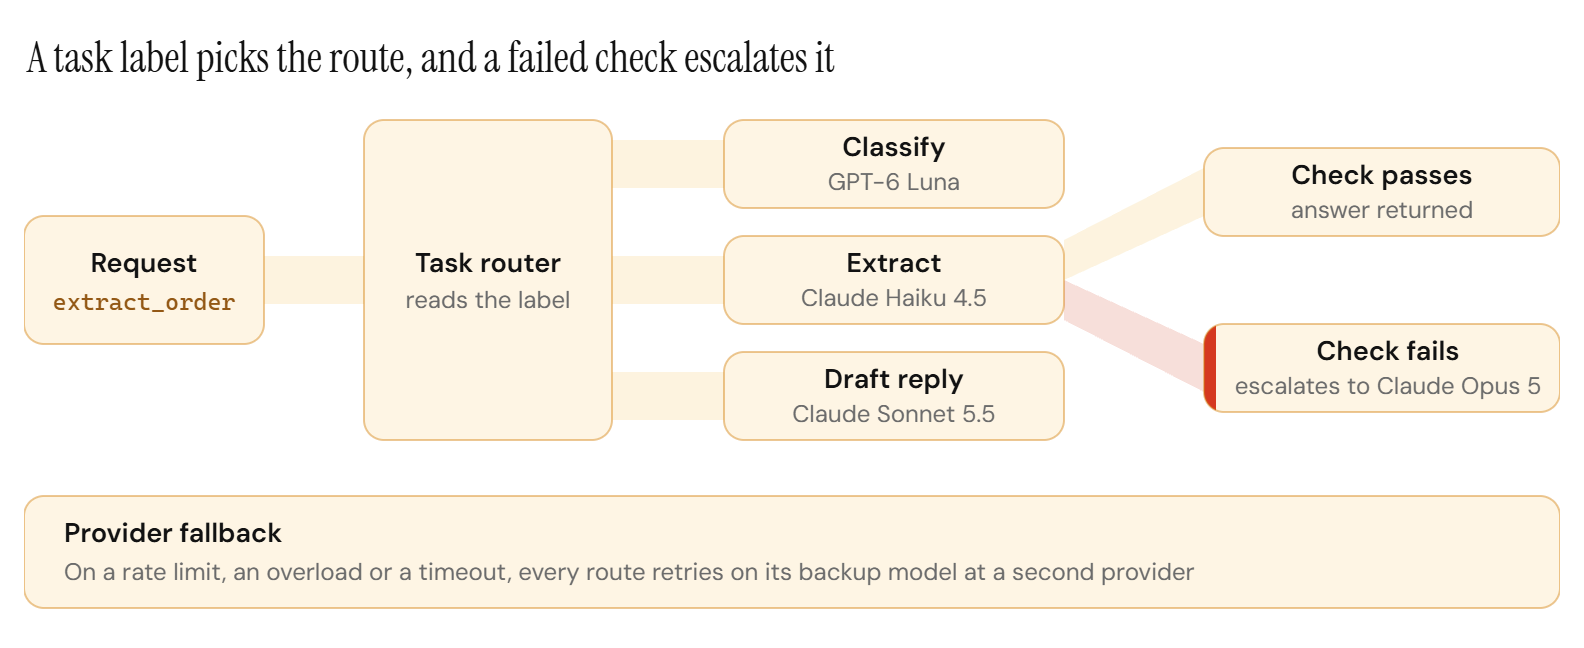
Añade enrutamiento semántico delante solo cuando un único punto de entrada recibe muchos tipos de solicitud. Añade un enrutador aprendido a una ruta solo cuando su volumen sea lo bastante alto, y sus resultados etiquetados lo bastante abundantes, como para que una mejor primera elección ahorre más de lo que cuesta el enrutador.
| Tu situación | Empieza con |
|---|---|
| Pasos distintos en un flujo de trabajo | Enrutamiento estático por tarea |
| Un punto de entrada, muchos tipos de solicitud | Enrutamiento semántico con frontera por defecto |
| Respuestas que el código puede comprobar | Una cascada dentro de la ruta |
| Alto volumen con resultados etiquetados | Un enrutador aprendido tras una comprobación |
| Un solo proveedor detrás de cada ruta | Respaldos antes que nada |
¿Cómo se mueve tráfico a un modelo más barato con seguridad?
Mueve el tráfico por etapas y deja que un control decida cuándo avanza cada una. Las etapas son las mismas tanto si el destino más barato es un nivel de frontera inferior, el modelo de otro proveedor o un modelo personalizado: evaluación offline, sombra, canario, rampa y, por último, estado estable con puntuación continua.
| Etapa | Quién ve las respuestas del candidato | Control para avanzar |
|---|---|---|
| Evaluación offline | Nadie; responde solicitudes reproducidas | Cumple el nivel en la evaluación |
| Sombra | Nadie; se puntúa en segundo plano | Mantiene el nivel con tráfico real |
| Canario | Una pequeña parte de los usuarios | Sin aumento de escalados ni quejas |
| Rampa | Una parte creciente de los usuarios | Cada control se mantiene en cada paso |
| Estado estable | Todas las solicitudes de la ruta | La puntuación continua sigue sobre el nivel |
Evaluación offline. Reproduce con el candidato una muestra reservada de solicitudes registradas y puntúala con la evaluación de la ruta. Es la etapa más barata y descarta a la mayoría de los candidatos.
Sombra. Envía al candidato una copia de las solicitudes reales en segundo plano mientras el modelo actual sigue respondiendo. Los usuarios nunca ven la salida del candidato. Puntúa ambas respuestas sobre las mismas solicitudes, lo que muestra cómo maneja el candidato entradas reales que tu evaluación nunca previó. El tráfico en sombra se factura dos veces, así que duplica solo una muestra cuando la ruta es grande.
Canario. Sirve con el candidato un pequeño porcentaje de las solicitudes reales, con las comprobaciones de la cascada entre él y el usuario. Una respuesta que no pasa una comprobación vuelve al modelo de frontera actual dentro de la misma solicitud, así que un candidato flojo se nota como un aumento de escalados y de latencia mientras los usuarios siguen recibiendo una respuesta que aprobó.
Rampa. Sube la proporción por pasos y mantén cada paso el tiempo suficiente para ver un ciclo completo de tu tráfico, como una semana que incluya un cierre de mes. Avanza solo cuando todos los controles se mantengan.
Estado estable. Sigue puntuando con la evaluación una muestra de las respuestas reales del candidato y deja armado el disparador de reversión. Una ruta puede degradarse semanas después de la rampa, cuando las entradas cambian o un alias de modelo pasa a apuntar a una versión nueva.
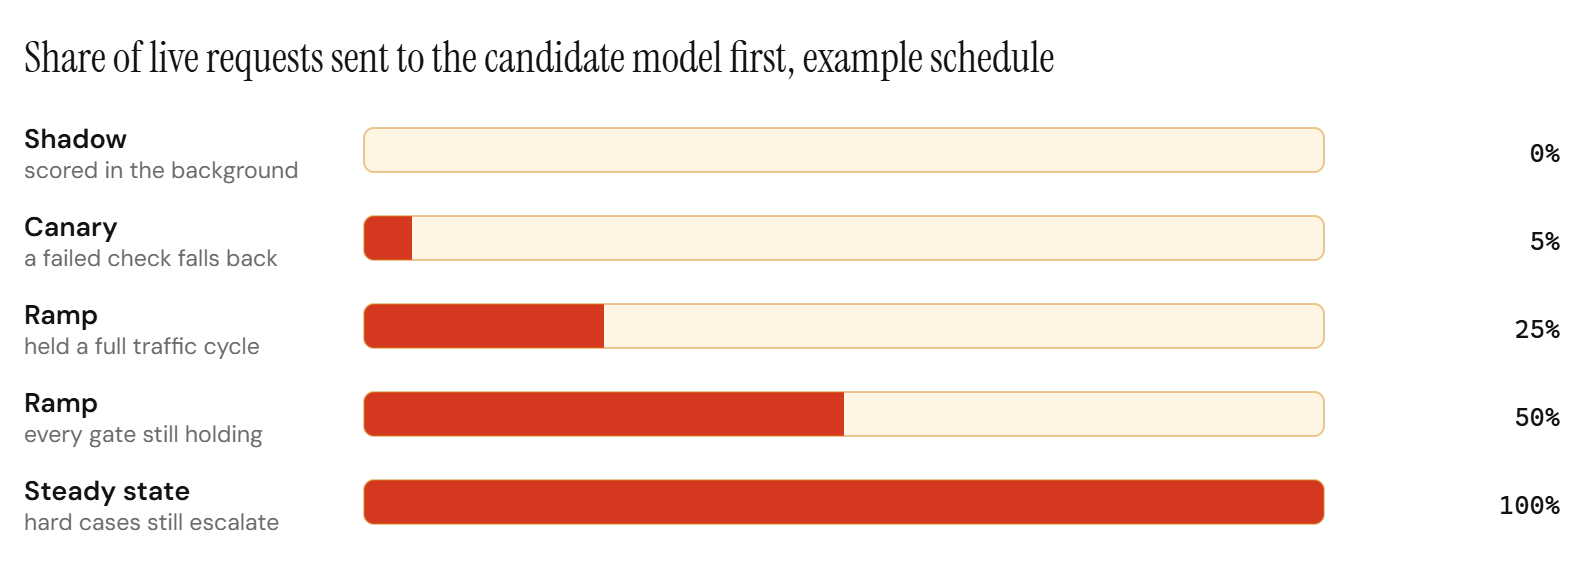
Haz que la reversión sea automática y por ruta. Una tasa de escalado por encima de su referencia, una puntuación de evaluación por debajo del nivel, una latencia p95 por encima del presupuesto de la ruta o un pico en la tasa de respaldo deberían devolver el tráfico de la ruta al modelo actual mientras alguien investiga.
¿Qué conviene medir en cada ruta?
Mide cada ruta por separado, porque los promedios de un enrutador esconden la ruta que pierde dinero o calidad. Guarda un registro por llamada a la API con la ruta, la etapa y el resultado.
log.info("api_call", extra={
    "task_id": task_id,
    "route": "extract_order",
    "stage": "canary",  # offline, shadow, canary, ramp o steady
    "model": model,
    "input_tokens": usage.input_tokens,
    "output_tokens": usage.output_tokens,
    "cost_usd": cost,
    "check_passed": passed,
    "escalated": not passed,
    "latency_ms": elapsed_ms,
})
Después agrega los registros por ruta y por etapa.
| Métrica | Qué te dice | Actúa cuando |
|---|---|---|
| Tasa de escalado | Lo que el modelo barato no puede terminar | Sube por encima de la referencia |
| Costo por tarea exitosa | Costo unitario con reintentos y escalados | Supera el objetivo de la ruta |
| Puntuación de evaluación | Si el nivel sigue cumpliéndose | Cae por debajo del nivel |
| Latencia p95 | Tiempo de espera, escalados incluidos | Supera el presupuesto de la ruta |
| Tasa de respaldo | Salud del proveedor | Tiene un pico |
El costo por tarea exitosa decide si una ruta se gana su sitio. Un modelo más barato con una tasa de escalado alta paga dos modelos en cada solicitud escalada, y un reintento paga dos veces la misma solicitud. Nuestra guía sobre el costo por tarea y la economía unitaria de la IA explica cómo fijar el objetivo de cada ruta, y la de optimización de costos de IA agéntica aplica la misma visión paso a paso a los agentes, donde cada paso de una ejecución es una decisión de enrutamiento.
¿Dónde encaja un modelo personalizado en una estrategia de enrutamiento?
Un modelo personalizado es un destino de enrutamiento más, y encaja en las estrategias anteriores sin cambiarlas. El enrutamiento estático da a una tarea de alto volumen su propia ruta, el modelo personalizado pasa a ser el destino más barato de esa ruta, el modelo de frontera queda detrás como vía de escalado y el plan de traslado de tráfico mueve la ruta.
Compensa donde cualquier otro destino sigue dejando una línea grande en la factura: una tarea con un volumen alto y estable, donde incluso el nivel de frontera más barato que supera la evaluación cuesta más que todo lo demás que ejecutas. Un modelo entrenado para un solo trabajo lleva solo la capacidad que ese trabajo necesita, así que cuesta menos servirlo y responde más rápido. Nuestro análisis de cuándo un modelo personalizado supera en costo a una API de frontera calcula el punto de equilibrio.
En nuestro estudio QMSum, un modelo de 1.2B entrenado para resumir reuniones a partir de consultas tuvo un costo estimado de servicio de $0.00053 por consulta, frente a $0.104 de Claude Opus 5 y $0.0130 de GPT-5.6 Luna a precios de lista síncronos. Respondió en 0.39 segundos en una sola GPU frente a 9.0 segundos de Claude Opus 5 a través de la API. La estimación excluye el costo de entrenamiento, y la calidad depende de cada tarea, por eso la ruta solo se mueve cuando el modelo personalizado supera tus evaluaciones.
El endpoint de modelo adaptativo empaqueta esa ruta por ti. Un endpoint de modelo adaptativo es un único endpoint de API para una de tus tareas: los modelos de frontera responden al principio, un modelo personalizado entrenado con tus solicitudes y los comentarios de tu equipo toma el relevo cuando supera tus evaluaciones, y los casos difíciles siguen en los modelos de frontera.
Con toda la ruta detrás de un solo endpoint, tu enrutador mantiene una única entrada para la tarea, sin importar cuántas versiones salgan detrás.
Ejecuta el plan anterior sobre esa única ruta. Cada nueva versión del modelo personalizado se ejecuta en segundo plano con solicitudes reales y se puntúa con tus evaluaciones, que es la etapa de sombra. Nada cambia sin tu aprobación, y cuando una versión aprueba, una parte creciente de las solicitudes pasa a ella, que son el canario y la rampa. Los casos difíciles siguen yendo a los modelos de frontera. Nosotros supervisamos el modelo y lo reentrenamos a medida que cambia tu tarea, y cada nueva versión pasa por el mismo control. Por ahora el endpoint funciona solo por invitación, y estamos desarrollando una versión más ágil para abrirlo a más empresas.
Para tu enrutador, adoptarlo significa apuntar una ruta a un nuevo nombre de modelo. El modelo funciona gestionado por Ertas, en tu nube u on-premise, y es tuyo.
Preguntas Frecuentes
¿Qué es un enrutador de LLM?
Un enrutador de LLM es una capa entre una aplicación y sus modelos que elige qué modelo responde cada solicitud. Puede decidir según una etiqueta de tarea, atributos de la solicitud, la similitud con ejemplos etiquetados o un clasificador entrenado. La mayoría de los enrutadores también gestionan el escalado cuando una respuesta no pasa una comprobación y el respaldo cuando falla un proveedor.
¿Un enrutador de LLM añade latencia?
El enrutamiento estático y las reglas no añaden casi nada, porque leen información que la aplicación ya tiene. El enrutamiento semántico añade una solicitud de embedding y un enrutador aprendido añade una pasada de clasificador. Una cascada es la que más añade en las solicitudes escaladas, que esperan tanto al modelo más barato como al más potente.
¿Es mejor un enrutador aprendido que las reglas de enrutamiento?
Un enrutador aprendido puede tomar decisiones más finas que las reglas cuando tiene resultados etiquetados de tu tráfico de los que aprender, y RouteLLM informó en 2024 reducciones de costos de más de 2 veces en ciertos casos en benchmarks. Las reglas son más baratas de ejecutar y más fáciles de depurar. Empieza con enrutamiento estático por tarea y añade un enrutador aprendido a una ruta solo cuando su volumen lo justifique.
¿Cómo se enruta entre modelos de OpenAI y Anthropic?
Pon una sola interfaz delante de ambos, normaliza el formato de respuesta y da a cada ruta un modelo principal y un respaldo en el otro proveedor. Ejecuta la evaluación de la ruta con cada modelo al que pueda llegar, incluido el respaldo, y cuenta con que los descuentos de la caché de prompts se reinicien cuando el tráfico pasa de un proveedor al otro.
¿Qué diferencia hay entre el enrutamiento de LLM y una cascada de LLM?
El enrutamiento elige un modelo antes de que se ejecute ninguno, a partir de lo que se sabe de la solicitud. Una cascada ejecuta primero el modelo más barato y escala a uno más potente cuando la respuesta no pasa una comprobación. La mayoría de los sistemas en producción usan ambos: el enrutamiento para elegir la ruta y una cascada dentro de ella.
¿Cómo se mueve tráfico a un modelo más barato sin perder calidad?
Por etapas: una evaluación offline con solicitudes reproducidas, puntuación en sombra con tráfico real, un canario con una pequeña parte de los usuarios y después una rampa por pasos. Condiciona cada etapa a la puntuación de la evaluación, la tasa de escalado y la latencia, mantén el modelo de frontera como respaldo dentro de cada solicitud y revierte automáticamente cuando falle un control.
La Versión Corta
Enruta primero por tarea, porque la aplicación ya sabe en qué paso está. Pon una cascada dentro de cada ruta donde el código pueda comprobar la respuesta, da a cada modelo un respaldo en un segundo proveedor y añade enrutamiento semántico o aprendido solo donde el volumen lo pague. Mueve el tráfico a cualquier destino más barato por etapas, con una evaluación como control, y mide el costo por tarea exitosa en cada ruta.
Si una sola ruta se lleva la mayor parte de tu factura de tokens, agenda una llamada y la analizamos contigo.
Fuentes: precios de la API de OpenAI, precios de Anthropic, errores de la API de Anthropic, RouteLLM (Ong et al., 2024) y FrugalGPT (Chen, Zaharia y Zou, 2023). Precios verificados el 6 de octubre de 2026.