


Para reducir los costos de tokens de IA, divide la factura en dos partes: las herramientas por puesto que usa tu equipo y las cargas de trabajo, es decir, las llamadas a la API que hacen tus productos y automatizaciones. La mayor parte del ahorro está en las cargas de trabajo y se consigue con cuatro medidas: ajustar el modelo a cada tarea, dejar de reenviar el mismo contexto, procesar por lotes el trabajo que puede esperar y darle a tu tarea de mayor volumen su propio modelo personalizado.
La presión detrás de esta pregunta es real. En abril de 2026, Axios informó que los presupuestos de TI se están desbordando porque algunas empresas ya gastan más en IA que en los salarios de sus empleados. El precio de un mismo nivel de capacidad de IA sigue bajando, pero el gasto total sigue subiendo, porque el uso crece más rápido de lo que caen los precios. Nuestra guía sobre por qué son tan altos los costos de la IA analiza esa tendencia en detalle.
Esta guía es para el directivo o responsable que tiene esa factura a su cargo. Cubre las preguntas que conviene hacer a tus equipos, el orden en que actuar y cuándo vale la pena un modelo personalizado. El detalle técnico de cada palanca está en nuestra guía complementaria, optimización de costos de LLM: 12 técnicas.
¿Qué es un token de IA y por qué la factura crece tan rápido?
Un token de IA es la unidad con la que facturan los proveedores de IA: un fragmento corto de texto, normalmente parte de una palabra, que se cuenta en todo lo que se envía a un modelo y en todo lo que el modelo devuelve. Tu factura es el número de tokens multiplicado por el precio del modelo que los procesó, así que crece cada vez que crece cualquiera de los dos.
Cuatro factores la empujan hacia arriba más rápido de lo que prevén la mayoría de los presupuestos.
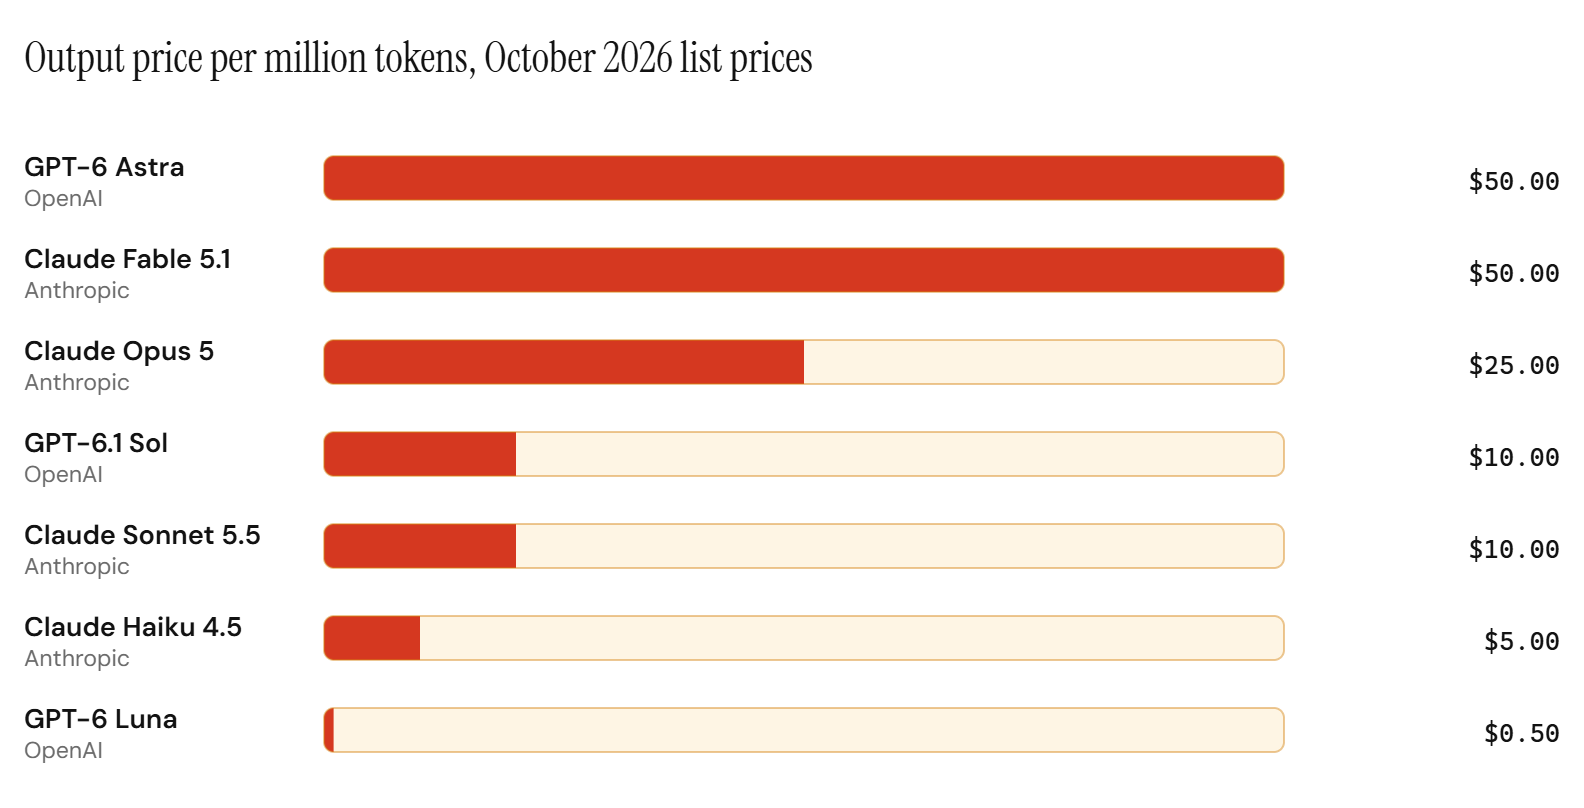
La salida cuesta más que la entrada. A octubre de 2026, Anthropic fija Claude Opus 5 en $5 por millón de tokens de entrada y $25 por millón de tokens de salida, y OpenAI fija GPT-6 Astra en $10 y $50. Cada token que escribe un modelo cuesta cinco veces más que cada token que lee.
El razonamiento añade tokens que nadie ve. La documentación de OpenAI indica que los tokens de razonamiento se facturan como tokens de salida, aunque la API nunca los muestra. Un modelo que piensa antes de responder también cobra por lo que piensa.
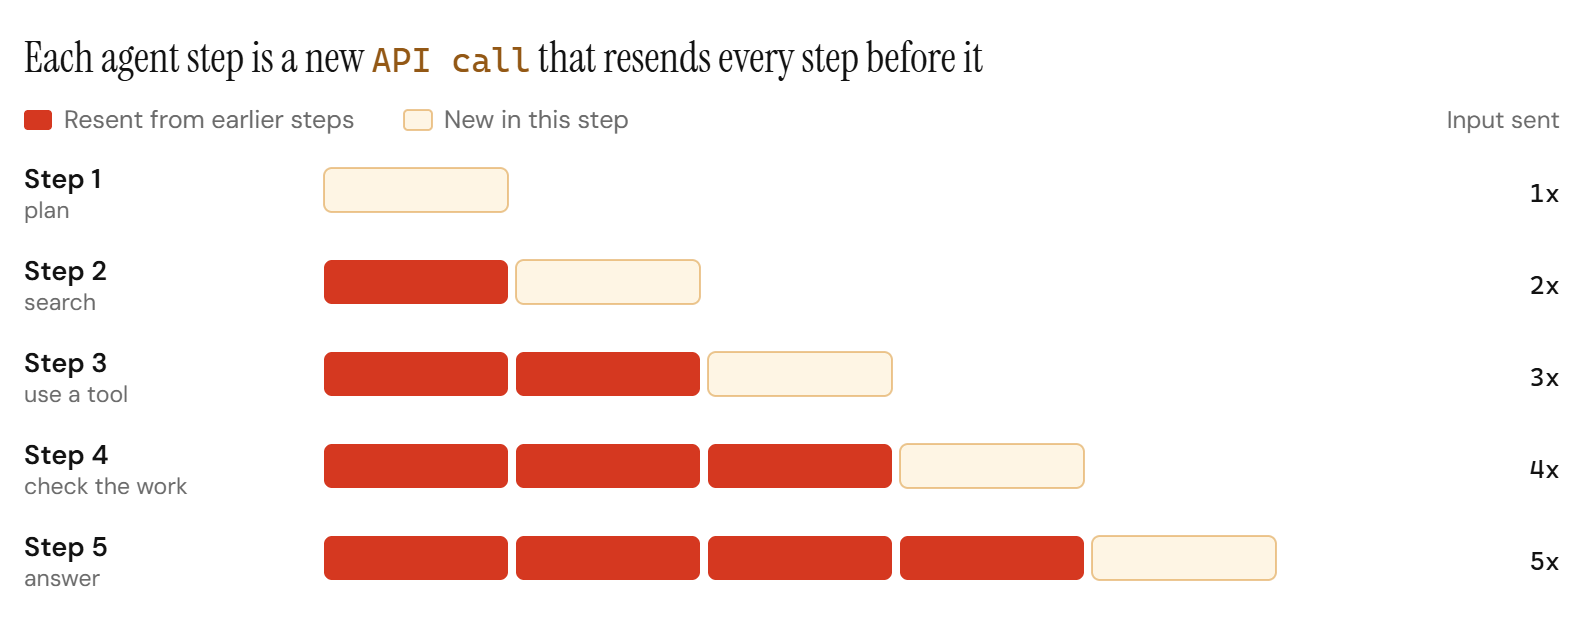
Una solicitud se convierte en muchas llamadas a la API. Un agente de IA que atiende una sola solicitud de un cliente puede planificar, buscar, usar herramientas y revisar su propio trabajo. Cada paso es una llamada a la API independiente que reenvía toda la conversación hasta ese momento, así que el costo de una solicitud sube con cada paso.
El modelo por defecto suele ser el más caro. Los equipos construyen un prototipo con el modelo más potente disponible y pasan a otra cosa. La diferencia entre niveles es enorme: a octubre de 2026, la salida de GPT-6 Astra cuesta $50 por millón de tokens y la de GPT-6 Luna $0.50, cien veces menos dentro de la familia de un mismo proveedor.
El precio por token tiene además sus propios multiplicadores ocultos, que explicamos en por qué el precio por token de IA cuesta de 3 a 5 veces lo estimado.
¿A dónde van realmente tus tokens de IA?
Empieza por dividir el gasto en IA en dos tipos. Crecen por motivos distintos y se recortan con palancas distintas.
| Tipo de gasto | Ejemplos | Quién impulsa el uso | Palanca principal |
|---|---|---|---|
| Herramientas por puesto | Asistentes de chat, agentes de código, copilotos | Cada empleado | Cuotas, valores por defecto y hábitos |
| Cargas de trabajo | Funciones de producto, automatizaciones, agentes internos | Equipos de ingeniería | Elección de modelo, caché, modelos personalizados |
Las herramientas por puesto se comportan como una suscripción de software con una cuota de uso encima. Las cargas de trabajo son donde se concentra el gasto a medida que la IA entra en los productos, porque una sola función puede hacer miles de llamadas a la API por hora sin que nadie escriba un prompt. Nuestra guía sobre presupuestos de tokens de IA para tus equipos explica cómo fijar cuotas, modelos predeterminados e informes para ambos.
Para cada carga de trabajo, pide a tu equipo de ingeniería cuatro cifras cada mes:
- Llamadas a la API por mes
- Tokens promedio de entrada y de salida por llamada a la API
- El modelo al que va cada llamada a la API
- El costo de una tarea completada, como un ticket resuelto, un siniestro tramitado o un informe redactado
La cuarta cifra es la que hay que gestionar. El costo por tarea vincula el gasto en IA con el trabajo que hace, así que puedes distinguir una factura que creció con el volumen del negocio de otra que creció porque cada tarea se encareció. Los proveedores informan el número de tokens en cada respuesta, así que obtener estas cifras es una tarea de registro para tus ingenieros. Nuestra guía sobre costo por tarea y economía unitaria de la IA muestra cómo calcularlo y fijar un objetivo.
¿Cómo recortar los costos de tokens de IA sin perder calidad?
Recorre las palancas en este orden. Las tres primeras son cambios de configuración que tu equipo puede hacer en pocas semanas. La última requiere más preparación y suele ahorrar más en tu mayor carga de trabajo.
| Palanca | Qué cambia | Esfuerzo | Ahorro en el trabajo afectado |
|---|---|---|---|
| Ajustar el modelo a la tarea | Un nivel más barato para tareas simples | Bajo | Hasta 100x de diferencia de precio |
| Reutilizar el contexto repetido | Caché de prompts | Bajo | Entrada en caché facturada al 10% |
| Procesar por lotes lo que puede esperar | Procesamiento por lotes asíncrono | Bajo | 50% menos en entrada y salida |
| Limitar los bucles de agentes | Topes de pasos y de presupuesto por ejecución | Medio | Varía según el flujo |
| Darle un modelo propio a una tarea grande | Modelo personalizado para una tarea | Mayor | El mayor en tareas de alto volumen |
Las cifras son precios de lista de OpenAI y Anthropic a octubre de 2026. Cada ahorro se aplica solo al trabajo que toca esa palanca, así que el efecto en tu factura total depende de tu combinación de cargas de trabajo.
Ajusta el modelo a la tarea
La mayoría de las empresas ejecutan todas las tareas con el modelo con el que empezaron. Clasificar un ticket de soporte, extraer campos de una factura o encaminar un correo rara vez necesita el modelo más capaz del mercado.
Pregunta qué cargas de trabajo se ejecutan en el nivel más alto y si alguien ha probado un nivel más barato con el mismo trabajo. La prueba necesita una evaluación: un conjunto de ejemplos reales con respuestas correctas conocidas en el que un modelo debe obtener buenos resultados antes de atender trabajo real. La evaluación es lo que vuelve seguras todas las decisiones posteriores de esta guía, así que conviene pedirla incluso antes de cambiar ningún modelo.
Deja de pagar precio completo por el contexto repetido
Muchas cargas de trabajo envían las mismas instrucciones largas, políticas o documentos de referencia en cada llamada a la API. La caché de prompts permite que el proveedor guarde esa parte repetida y cobre mucho menos por ella en las llamadas a la API siguientes.
A octubre de 2026, Anthropic factura los aciertos de caché a una décima parte del precio de entrada estándar en la mayoría de los modelos Claude, y OpenAI fija la entrada en caché de GPT-6 Luna en $0.01 por millón de tokens frente a $0.10 la estándar. Pregunta si tus mayores cargas de trabajo están estructuradas para aprovecharla.
Procesa por lotes todo lo que puede esperar
Los informes nocturnos, los documentos acumulados, los controles de calidad y el etiquetado masivo pueden esperar unas horas por los resultados. A octubre de 2026, tanto OpenAI como Anthropic cobran el procesamiento por lotes al 50% de la tarifa estándar en tokens de entrada y de salida. Suele ser el ahorro más rápido disponible, porque solo cambia el momento en que se hace el trabajo.
Pon límites a los agentes de IA
Los agentes son la partida que más rápido se mueve en la mayoría de las facturas de IA, porque cada ejecución puede dar un número impredecible de pasos. Fija un número máximo de pasos y un presupuesto de tokens por ejecución, e informa el costo por tarea completada de cada agente en producción. Una ejecución que llega a su límite debe detenerse y pasar el caso a una persona o a una vía más simple.
Dale a tu tarea de mayor volumen su propio modelo
Cuando una sola tarea representa una gran parte de tu factura de IA, como clasificar siniestros o resumir conversaciones con clientes, pagar precios de frontera en cada repetición deja de tener sentido. Un modelo personalizado entrenado para esa tarea puede encargarse de la parte rutinaria del trabajo con un costo por tarea mucho menor, mientras los modelos de frontera se quedan con los casos difíciles.
¿Cuándo tiene sentido un modelo personalizado para una tarea de alto volumen?
Un modelo personalizado tiene sentido cuando una tarea se ejecuta con un volumen alto y estable, la definición de una buena respuesta no cambia y puedes comprobar la calidad con una evaluación. Para tareas más pequeñas o que cambian rápido, las palancas de configuración anteriores suelen bastar.
Usa estas cinco preguntas con tu equipo.
| Pregunta | Buena señal para un modelo personalizado |
|---|---|
| ¿Con qué frecuencia se ejecuta la tarea? | Miles de llamadas a la API al día |
| ¿Es el mismo trabajo cada vez? | Una tarea con una salida consistente |
| ¿Se pueden comprobar las respuestas automáticamente? | Existe una evaluación o se puede construir |
| ¿Estamos de acuerdo en qué es una buena respuesta? | Un nivel de calidad claro |
| ¿Dónde deben quedarse los datos? | Gestionado por Ertas, en tu nube u on-premise |
Si la mayoría de las respuestas van en la buena dirección, la tarea es una candidata sólida. Si la tarea cambia cada semana o nadie sabe decir cómo es una buena respuesta, resuelve eso primero, porque a un modelo solo se le puede exigir un nivel de calidad que exista.
Este es el trabajo que hace Ertas con el endpoint de modelo adaptativo. Un endpoint de modelo adaptativo es un único endpoint de API para una de tus tareas: los modelos de frontera responden al principio, un modelo personalizado entrenado con tu trabajo toma el relevo cuando supera tus evaluaciones, y los casos difíciles siguen en los modelos de frontera.
Las nuevas versiones llegan detrás del mismo endpoint, así que reentrenar nunca espera a un despliegue de tu equipo.
Para tu equipo, adoptarlo significa cambiar un nombre de modelo en su código. Cada nueva versión del modelo personalizado se ejecuta primero en segundo plano con solicitudes reales, y nada cambia sin tu aprobación. Nosotros supervisamos el modelo y lo reentrenamos a medida que cambian tus tareas. Funciona gestionado por Ertas, en tu nube u on-premise, y es tuyo. Por ahora el endpoint funciona solo por invitación, y estamos desarrollando una versión más ágil para abrirlo a más empresas.
El ahorro viene de servir un modelo entrenado para un solo trabajo. En nuestro estudio QMSum publicado, un modelo entrenado para una tarea de resumen de reuniones tuvo un costo estimado de servicio por consulta alrededor de un 99% menor que Claude Opus 5 a precios de lista, y respondió 23 veces más rápido. Cada tarea es distinta, y por eso cada cambio espera a tus evaluaciones.
Un plan de 30 días para recortar tu factura de tokens de IA
Así encajan los pasos anteriores en un mes, con un responsable para cada uno.
| Semana | Acción | Responsable |
|---|---|---|
| 1 | Dividir el gasto en herramientas por puesto y cargas de trabajo | Finanzas con ingeniería |
| 2 | Registrar el costo por tarea de las principales cargas de trabajo | Ingeniería |
| 3 | Aplicar lotes, caché y ajuste del modelo | Ingeniería |
| 4 | Elegir una tarea de alto volumen y definir un modelo personalizado | Responsables de producto e ingeniería |
Al final del mes tienes una línea base, los ahorros rápidos asegurados y una decisión sobre tu mayor carga de trabajo. Incorpora las cifras al plan del próximo año junto con el resto de tu infraestructura de IA, como explicamos en nuestra guía de planificación del presupuesto de IA empresarial.
Preguntas Frecuentes
¿Cuánto puede ahorrar una empresa en costos de tokens de IA?
Depende de la combinación de trabajo. En el trabajo que toca cada palanca, los efectos a precios de lista de octubre de 2026 son claros: el procesamiento por lotes cuesta un 50% menos en OpenAI y Anthropic, la entrada en caché cuesta alrededor de una décima parte de la entrada estándar y los niveles más baratos pueden costar hasta 100 veces menos por token de salida. Un modelo personalizado en una tarea de alto volumen suele ser lo que más mueve el total, porque baja el precio de la mayor carga de trabajo.
¿Qué diferencia hay entre los costos por puesto y los costos de cargas de trabajo?
Los costos por puesto vienen de herramientas que los empleados usan directamente, como asistentes de chat y agentes de código, y se gestionan con licencias y cuotas de uso. Los costos de cargas de trabajo vienen de las llamadas a la API que hacen por su cuenta tus productos, automatizaciones y agentes, y escalan con el volumen del negocio. La mayor parte del ahorro de esta guía se aplica a las cargas de trabajo.
¿Los modelos más baratos bajarán la calidad de nuestras funciones de IA?
Pueden hacerlo si cambias a ciegas. Prueba el modelo más barato con una evaluación, un conjunto de ejemplos reales con respuestas correctas conocidas, y pasa solo las tareas en las que alcanza tu nivel de calidad. Mantén la evaluación en marcha después del cambio para que una caída aparezca en un informe antes que en las quejas de los clientes.
¿Perdemos el acceso a los modelos de frontera si usamos un modelo personalizado?
No. Con un endpoint de modelo adaptativo, los casos difíciles siguen yendo a los modelos de frontera, y el modelo personalizado asume la parte rutinaria cuando supera tus evaluaciones. Mantienes la calidad de frontera donde importa y pagas menos en el trabajo repetitivo.
¿De quién es un modelo personalizado que construye Ertas?
Es tuyo. El modelo se entrena con tu trabajo para tu tarea, y funciona gestionado por Ertas, en tu nube u on-premise. Nosotros lo supervisamos y lo reentrenamos a medida que cambian tus tareas.
¿Cuánto se tarda en ver los ahorros?
Los lotes, la caché y el ajuste del modelo pueden notarse en la próxima factura mensual, porque son cambios de configuración. Un modelo personalizado tarda más porque tiene que superar tus evaluaciones antes de recibir tráfico. Mientras tanto tu modelo de frontera sigue respondiendo, así que nada queda en espera.
La Versión Corta
Los costos de tokens de IA crecen con el volumen, la longitud de la salida, el razonamiento y los pasos de los agentes. Divide la factura, mide el costo por tarea, aplica primero los ahorros de configuración y después dale a tu mayor tarea repetida un modelo entrenado para ella.
Si una sola tarea ya domina tu factura, agenda una llamada y la revisamos contigo.
Fuentes: precios de la API de OpenAI, precios de Anthropic, guía de razonamiento de OpenAI y Axios. Precios verificados el 6 de octubre de 2026.