


Un presupuesto de tokens de IA es una asignación mensual de gasto en IA, fijada por equipo o por tarea y medida en dólares. Se arma en tres partes: una asignación por defecto para las herramientas de IA que usa cada empleado, showback para que cada equipo vea su propio gasto y un presupuesto por tarea para cada carga de trabajo de tus productos.
Los presupuestos de tokens se convirtieron en un tema de gestión en 2026. En abril, el CTO de Uber dijo que la empresa había agotado todo su presupuesto de 2026 para Claude Code a los cuatro meses del año, según informó Quartz. En junio, Bloomberg informó que Uber limita a cada empleado a $1,500 al mes en tokens por cada herramienta de programación con IA, y que Walmart había limitado el uso de su agente de IA interno.
Un tope que llega cuando el dinero ya se gastó es la versión tosca de un presupuesto de tokens. Esta guía es la versión planificada: qué presupuestar, a qué nivel y cómo lograr que el presupuesto sirva de barandilla para el trabajo útil. Parte de cómo reducir costos de tokens de IA en tu empresa, que explica a dónde van los tokens y qué palancas los reducen.
¿Qué es un presupuesto de tokens de IA?
Un presupuesto de tokens de IA es lo que un equipo o una tarea puede gastar en uso de modelos de IA en un mes, fijado en dólares y reportado en dólares y en tokens. El dólar es la unidad correcta porque los precios por token varían muchísimo. A octubre de 2026, un token de salida de GPT-6 Astra cuesta 100 veces lo que uno de GPT-6 Luna, así que un millón de tokens de salida puede costar $0.50 o $50 según el modelo.
Tu gasto en IA se divide en dos tipos, y cada uno necesita su propio presupuesto.
| Presupuesto de herramientas por puesto | Presupuesto de cargas de trabajo | |
|---|---|---|
| Cubre | Asistentes de chat, agentes de código, copilotos | Funciones de producto, automatizaciones, agentes internos |
| Unidad | Dólares por persona al mes | Dólares por tarea completada |
| Crece con | Plantilla y hábitos | Volumen de negocio |
| Responsable | El responsable de cada equipo | Líder de producto o ingeniería |
| Control principal | Asignaciones y modelos por defecto | Costo por tarea |
Las herramientas por puesto son donde la mayoría de los responsables notan el problema primero, porque el uso depende de cómo trabaja cada persona. Las cargas de trabajo concentran cada vez más dinero a medida que la IA entra en los productos, porque una sola función puede hacer miles de llamadas a la API por hora sin que nadie escriba un prompt.
¿Cómo fijar un presupuesto de tokens de IA para cada equipo?
Parte del uso medido, fija asignaciones por rol, haz que el modelo más barato sea el predeterminado y decide de antemano qué pasa al llegar al límite.
1. Mide una línea base antes de fijar una cifra. Deja uno o dos meses con los informes activados y límites holgados, y después revisa el gasto por persona, por herramienta y por modelo. A octubre de 2026, la documentación de Claude Code de Anthropic sitúa el costo medio en despliegues empresariales entre $150 y $250 por desarrollador al mes, con el 90% de los usuarios por debajo de $30 por día activo. Las cifras de Uber estaban en el mismo rango, con sus usuarios más intensivos entre $500 y $2,000 al mes, según Quartz. Usa los promedios publicados para comprobar que tus propias cifras son razonables.
2. Fija asignaciones por rol. Una sola cifra para toda la empresa es demasiado estrecha para quienes usan agentes de código y demasiado holgada para quien abre un asistente de chat unas pocas veces al día.
| Grupo de roles | Uso principal de IA | Cómo fijar la asignación |
|---|---|---|
| La mayoría del personal | Chat y ayuda para redactar | El uso incluido en el plan por puesto |
| Analistas y operaciones | Documentos largos e investigación | Mediana medida más un margen |
| Ingenieros de software | Agentes de código | Un presupuesto mensual por herramienta |
| Responsables de automatizaciones | Agentes programados y pipelines | Un presupuesto de carga por tarea |
El tope de Uber es una buena referencia para la fila de ingeniería. Con $1,500 por herramienta al mes, está entre seis y diez veces por encima de los $150 a $250 habituales, así que recorta la cola larga y deja intacto el uso normal.
3. Haz que el modelo más barato sea el predeterminado. Buena parte de la factura de herramientas por puesto la decide el modelo que usa la herramienta cuando nadie elige uno. Pon un modelo de nivel medio como predeterminado para programar y uno de nivel bajo para el chat sencillo, y deja el nivel superior como una elección deliberada para problemas difíciles. La documentación de Anthropic atribuye los gastos inesperadamente altos en Claude Code a dos hábitos: sesiones largas que nunca se limpiaron y Opus como modelo predeterminado.
4. Deja por escrito qué pasa en el límite. Decide si quien agota su asignación espera al reinicio, pasa a un modelo más barato o pide más, y mantén ese trámite en un día o menos. Las herramientas ya lo permiten a octubre de 2026: los miembros de los planes Team y Enterprise de Claude pueden pedir más uso a sus administradores desde Claude Code, y Cursor Enterprise y GitHub Copilot permiten a los administradores fijar límites por persona.
Trata igual las ejecuciones largas de agentes autónomos. Una ejecución que va a durar horas, o que se reparte entre muchos agentes en paralelo, merece una aprobación rápida y su propio presupuesto. La documentación de Anthropic estima que los equipos de agentes de Claude Code usan unas siete veces los tokens de una sesión normal cuando los compañeros trabajan en modo de planificación. Nuestra guía de optimización de costos de IA agéntica explica cómo los ingenieros bajan esa cifra.
¿Cómo evitar que un presupuesto de tokens frene a tus equipos?
Un presupuesto de tokens funciona cuando cada persona ve su propio gasto, el límite queda por encima del uso normal y conseguir más lleva un día o menos. Tres prácticas lo hacen posible.
Primero showback, después chargeback. El showback consiste en devolver a cada equipo, cada mes, un informe de su gasto en IA por persona, herramienta y modelo, mientras el dinero sigue en un presupuesto central. El chargeback traslada el costo al presupuesto del propio equipo. Empieza por el showback, porque la visibilidad cambia los hábitos por sí sola. El COO de Uber observó que los ingenieros que nunca ven la factura pueden tratar las herramientas de IA como si fueran prácticamente gratis, según Quartz. Pasa al chargeback cuando los equipos tengan unos meses de cifras propias con las que planificar.
Premia los resultados y deja fuera el volumen de tokens. Una clasificación de uso de tokens convierte el gasto en un símbolo de estatus. Amazon cerró una clasificación interna que medía el uso de tokens de IA después de que animara a parte del personal a ejecutar tareas solo para subir puestos, según Business Insider citado por Bloomberg. Informa de lo que entregó cada equipo y de su costo por tarea junto a su gasto.
Revisa cada mes, en treinta minutos. Una reunión, una tabla, dirigida por quien es dueño del presupuesto.
| Punto del orden del día | Pregunta a responder |
|---|---|
| Gasto frente a presupuesto | ¿Qué equipos se pasan o se quedan cortos, y por qué? |
| Usuarios principales | ¿Un flujo de trabajo para compartir o un bucle desbocado? |
| Modelos predeterminados | ¿Algún nivel más barato pasó las pruebas del equipo? |
| Límites ampliados | ¿Valieron la pena las aprobaciones del mes pasado? |
| Cargas de trabajo | ¿Se movió el costo por tarea? |
Los usuarios más intensivos suelen ser las personas con flujos de trabajo dignos de copiar, y a veces los dueños de una tarea programada que nadie se acordó de detener. Vale la pena encontrar ambos casos.
¿Cómo reducir el uso de tokens en Claude Code, Cursor y Copilot?
Enseña unos pocos hábitos de sesión, usa por defecto un modelo de nivel medio y aprovecha los controles de gasto que ahora ofrece cada proveedor. Los agentes de código son la mayor partida de herramientas por puesto en casi todos los equipos de ingeniería, porque cada mensaje lleva los archivos leídos, la salida de los comandos y la conversación hasta ese momento.
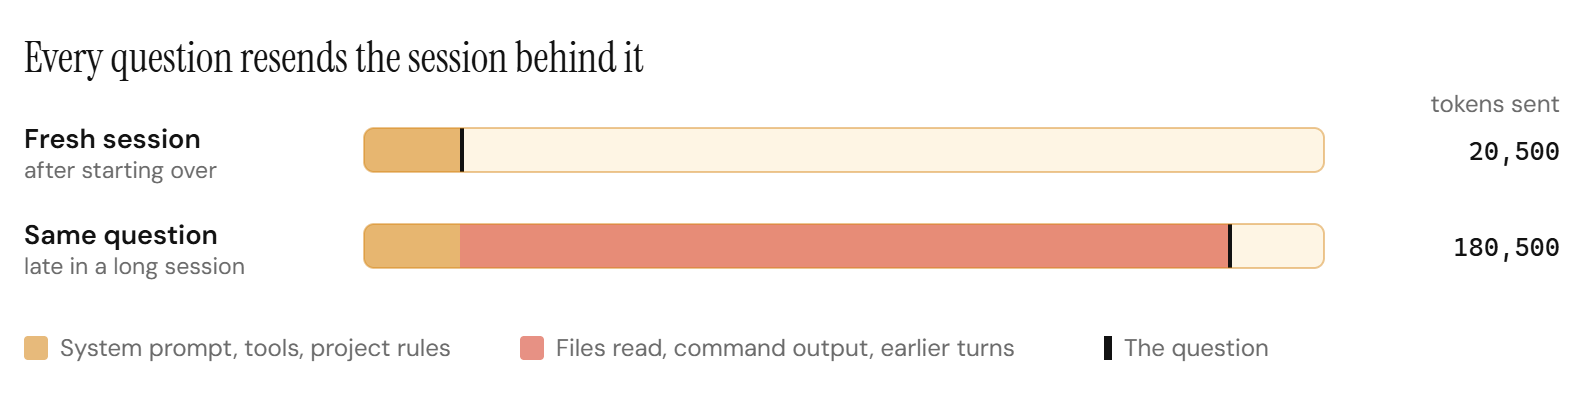
Estos hábitos vienen de la guía de Claude Code de Anthropic, y los mismos principios valen en Cursor y Copilot:
- Empieza una sesión nueva entre tareas no relacionadas. En Claude Code es
/clear. Una pregunta de una línea en una sesión abierta todo el día sigue pagando por el contexto de todo el día. - Usa por defecto el nivel medio. Reserva el modelo superior para decisiones de arquitectura y depuraciones difíciles.
- Mantén cortas las instrucciones que se cargan siempre. Los archivos de reglas del proyecto entran en cada sesión. Anthropic sugiere mantener CLAUDE.md por debajo de 200 líneas y mover las instrucciones especializadas a skills que solo se cargan cuando se usan.
- Baja el esfuerzo de razonamiento en trabajo sencillo. Los tokens de razonamiento se facturan como tokens de salida, los más caros.
- Pide cambios concretos. Pedir que se añada validación a una función con nombre lee unos pocos archivos. Pedir que se mejore el código base lee muchos.
- Vigila el trabajo en segundo plano. Los bucles programados, los agentes en paralelo y los equipos de agentes siguen gastando mientras nadie mira.
En el lado de la administración ya hay buenas herramientas. Así se ve el gasto en cada una y así se limita, a octubre de 2026.
| Herramienta y plan | Dónde se ve el gasto | Cómo limitarlo |
|---|---|---|
| Claude Code, Team o Enterprise | Informe de gasto por usuario y modelo | Límites por organización, grupo o miembro |
| Claude Code, Console (API) | Página de uso y panel de Console | Límites de gasto por workspace |
| Cursor, Teams | Panel de administración, por usuario | Un límite mensual para todo el equipo |
| Cursor, Enterprise | Panel de administración, por usuario | Límites por equipo, grupo y miembro |
| GitHub Copilot, Business o Enterprise | Uso en créditos de IA | Presupuestos por empresa, centro de costos o usuario |
Tres detalles importan al configurarlos. En los planes Team y Enterprise de Claude, el uso consume primero la asignación incluida en cada puesto, y los límites de gasto rigen el uso que va más allá. Desde junio de 2026, GitHub Copilot factura el uso de Business y Enterprise por tokens, en créditos de IA de un centavo cada uno, y agrupa los créditos incluidos de cada puesto en un fondo común de la organización, así que unos pocos usuarios intensivos pueden vaciarlo para todos si no hay presupuestos por usuario. Cursor factura el uso de modelos de terceros que supera lo incluido a precios de lista de la API más una tarifa de $0.25 por millón de tokens.
¿Cómo presupuestar las cargas de trabajo de IA?
Presupuesta cada carga de trabajo como tareas al mes multiplicadas por el costo por tarea, y pon la alerta en el costo por tarea. El total crece cuando crece el negocio, lo que suele ser una buena noticia. El costo por tarea crece cuando algo se volvió menos eficiente, como un prompt más largo, un modelo más caro o un agente que da más pasos.
Toma una carga de soporte que clasifica 200,000 tickets al mes a $0.06 por ticket, una partida de $12,000.
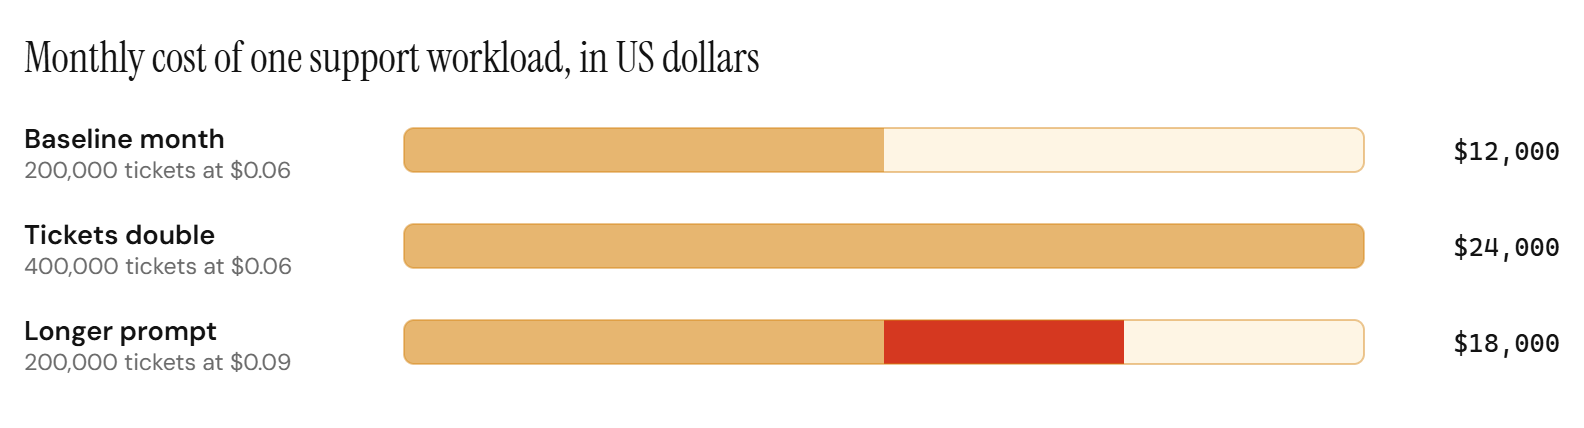
Por eso un presupuesto de carga de trabajo tiene dos partes:
- Una previsión de volumen, a cargo del negocio, tomada del mismo plan que prevé tickets, reclamaciones o pedidos.
- Un costo objetivo por tarea, a cargo de ingeniería, con una alerta cuando se desvía más de un margen acordado, por ejemplo un 10%.
Bajar el costo por tarea empieza por la configuración: procesar por lotes el trabajo que puede esperar, cachear el contexto repetido y pasar cada tarea al modelo más barato que supere sus pruebas, todo ordenado en optimización de costos de LLM: 12 técnicas. Nuestra guía sobre costo por tarea y economía unitaria de la IA explica cómo fijar el objetivo.
Cuando una sola tarea ocupa la mayor parte de una partida de carga de trabajo, como clasificar tickets o extraer campos de reclamaciones, la palanca más grande es el precio de esa tarea. Un modelo personalizado entrenado para ella puede responder la parte rutinaria con un costo por tarea mucho menor, mientras los modelos de frontera se quedan con los casos difíciles.
¿Dónde encaja un modelo personalizado en un presupuesto de tokens?
Un modelo personalizado pertenece al lado de cargas de trabajo del presupuesto, en una tarea de volumen alto y estable, con una definición estable de lo que es una buena respuesta y una evaluación para comprobarla. Baja el costo por tarea de esa partida, y los modelos de frontera siguen en el presupuesto para los casos difíciles y para todo lo demás.
Para eso existe el endpoint de modelo adaptativo. Un endpoint de modelo adaptativo es un único endpoint de API para una de tus tareas: al principio responden los modelos de frontera, un modelo personalizado entrenado con tus solicitudes y los comentarios de tu equipo toma el relevo cuando supera tus evaluaciones, y los casos difíciles se quedan en los modelos de frontera.
Cada solicitud que responde el modelo personalizado sale de la partida de frontera de tu presupuesto, y las difíciles siguen llegando a un modelo de frontera.
Para quien es dueño del presupuesto, se siguen tres cosas.
La partida más grande se reduce. En nuestro estudio QMSum publicado, un modelo entrenado para una tarea de resumen de reuniones tuvo un costo estimado de servicio de $0.00053 por consulta, frente a $0.104 de Claude Opus 5 y $0.0130 de GPT-5.6 Luna con precios de lista síncronos, y respondió en 0.39 segundos frente a 9.0 segundos de Claude Opus 5. La estimación excluye el costo de entrenamiento, y cada tarea es distinta, por eso cada cambio espera a tus evaluaciones.
La partida se vuelve más predecible. La parte rutinaria de la tarea corre en un modelo que es tuyo, así que su costo por tarea se mantiene cuando cambian las listas de precios o los modelos predeterminados de frontera.
Tu equipo mantiene el control. Cada versión nueva corre primero en segundo plano con solicitudes reales, y nada cambia sin tu aprobación. Supervisamos el modelo y lo reentrenamos a medida que cambia tu tarea. Funciona gestionado por Ertas, en tu nube o en tus instalaciones, y es tuyo. Por ahora el endpoint funciona solo por invitación, y estamos desarrollando una versión más ágil para abrirlo a más empresas.
Para ver cómo encaja esta partida en el plan del año próximo, consulta nuestra guía de planificación del presupuesto de IA empresarial.
Preguntas Frecuentes
¿Qué es un presupuesto de tokens?
Un presupuesto de tokens es un límite a lo que una persona, un equipo o una tarea puede gastar en uso de modelos de IA en un periodo, normalmente un mes. Se fija en dólares, porque los precios por token cambian hasta 100 veces entre modelos, y se reporta en dólares y en tokens para que los equipos vean qué impulsó el gasto.
¿Cuánto deberíamos presupuestar por empleado para herramientas de IA?
Fíjalo a partir de tu propio uso medido, por rol. Como referencia, Anthropic reporta un costo medio de Claude Code de $150 a $250 por desarrollador al mes en despliegues empresariales a octubre de 2026, y Uber limita las herramientas de programación agéntica a $1,500 por empleado, por herramienta y por mes. La mayor parte del personal que no es de ingeniería necesita mucho menos, a menudo solo el uso incluido en su plan por puesto.
¿Un presupuesto de tokens se fija en tokens o en dólares?
Fíjalo en dólares y reporta ambos. Un millón de tokens de salida puede costar $0.50 o $50 según el modelo, así que un presupuesto en tokens dice poco del costo. Los recuentos de tokens siguen siendo útiles en el informe, porque muestran si el gasto subió por más uso o por un modelo más caro.
¿Los presupuestos de tokens frenarán a nuestros ingenieros?
Un presupuesto bien fijado queda por encima del uso normal, así que la mayoría de los ingenieros nunca lo alcanza. El tope de Uber de $1,500 por herramienta equivale a entre seis y diez veces el costo mensual típico que Anthropic reporta para Claude Code. Acompaña el límite con un trámite rápido para pedir más y con showback, y evita premiar el volumen de tokens, porque fomenta el desperdicio.
¿Qué diferencia hay entre showback y chargeback?
El showback devuelve a cada equipo un informe de su gasto en IA mientras el dinero sigue en un presupuesto central. El chargeback traslada el costo al presupuesto de cada equipo. Empieza por el showback para crear hábitos y una línea base, y pasa al chargeback cuando los equipos puedan prever su propio uso.
¿Cómo afecta un modelo personalizado al presupuesto de una carga de trabajo?
Baja el costo por tarea de la carga que atiende, que suele ser la partida más grande del presupuesto. Con un endpoint de modelo adaptativo, los modelos de frontera responden al principio y se quedan con los casos difíciles, y el modelo personalizado asume la parte rutinaria cuando supera tus evaluaciones. El modelo funciona gestionado por Ertas, en tu nube o en tus instalaciones, y es tuyo.
La Versión Corta
Un presupuesto de tokens de IA fija cuánto puede gastar en IA cada equipo y cada tarea en un mes. Mide primero, fija asignaciones por rol, usa por defecto el modelo más barato, muestra a cada equipo su propio gasto y presupuesta las cargas de trabajo por costo por tarea. Cuando una sola tarea domina la partida de cargas de trabajo, dale un modelo entrenado para ella.
Si una sola carga de trabajo ya se lleva la mayor parte de tu presupuesto de tokens, agenda una llamada y la revisamos contigo.
Fuentes: Quartz, Bloomberg sobre los topes de Uber, Bloomberg vía Transport Topics, documentación de costos de Claude Code, límites de gasto de Cursor, precios de Cursor Teams, facturación por uso de GitHub Copilot y precios de la API de OpenAI. Precios y controles de producto verificados el 6 de octubre de 2026.