


La IA cuesta tanto porque las empresas usan muchos más tokens por tarea y hacen muchas más tareas. Las solicitudes llevan más contexto y razonamiento, los agentes convierten una solicitud en muchas llamadas a la API, el uso llega a todos los equipos y casi todo corre en los modelos más nuevos, que siguen caros mientras la capacidad antigua se abarata.
Los líderes ya lo notan en el presupuesto. En Google I/O, en mayo de 2026, Sundar Pichai contó que a Google le habían llegado noticias de muchas empresas que ya estaban agotando su presupuesto anual de tokens, cuando el año ni siquiera iba por la mitad. Un mes antes, Axios informó de que los presupuestos de TI se estaban desbordando porque algunas empresas ya gastaban más en IA que en salarios.
Esta guía explica por qué crece la factura, cómo juzgar si el gasto está rindiendo y qué pueden hacer los líderes al respecto. Para el plan paso a paso para recortar la factura, consulta cómo reducir los costos de tokens de IA en tu empresa.
¿Por qué suben los costos de la IA si el precio por token baja?
El precio de cualquier nivel fijo de capacidad de IA cae muy rápido. En noviembre de 2024, a16z estimó que, para un modelo de rendimiento equivalente, el costo baja unas 10 veces cada año: alcanzar la puntuación que GPT-3 obtuvo en 2021 en un benchmark costaba entonces $60 por millón de tokens, y $0.06 tres años después. Epoch AI halló en 2025 que el precio de alcanzar una puntuación fija en un benchmark bajó entre 9 y 900 veces por año, según el benchmark y la puntuación.
Aun así, las facturas suben, porque esas cifras describen el precio de quedarse quieto. Tu factura de IA multiplica tres números:
- El precio por token de los modelos que realmente usas. Las empresas pasan una y otra vez a los modelos más nuevos, así que la capacidad que compran rara vez es la que se está abaratando.
- Los tokens por tarea. Más contexto, más razonamiento y más pasos de agente hacen cada tarea más grande.
- El número de tareas. La IA ha salido de los pilotos y ha entrado en los productos, los flujos de trabajo y las herramientas diarias de todos los equipos.
El primer número puede subir incluso mientras la capacidad se abarata. En julio de 2026, J.P. Morgan informó de que el precio de los tokens en el mercado de LLM había subido más de un 60% desde diciembre de 2025, según un índice de Bloomberg del precio efectivo por millón de tokens, a medida que se disparaba la demanda de cómputo en centros de datos. Los otros dos números son los que más han crecido.
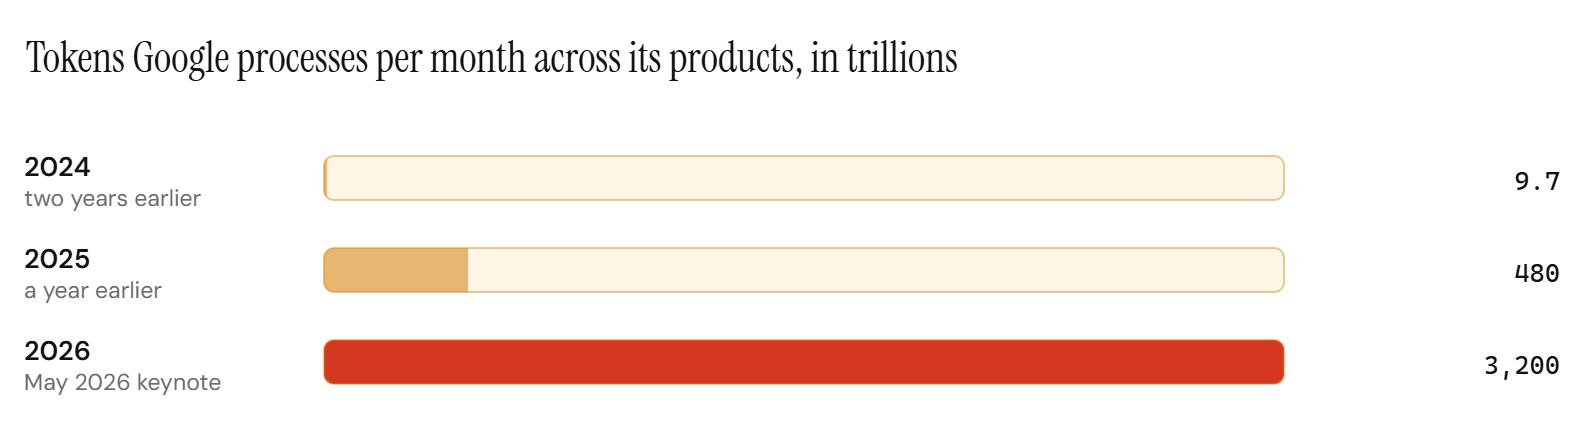
Las cifras de Google abarcan productos de consumo y de empresa, así que muestran la dirección de la demanda más que la factura de una empresa concreta. La misma conferencia aportó un dato de empresa: más de 375 clientes de Google Cloud habían procesado cada uno más de un billón de tokens en los doce meses anteriores.
¿Qué está impulsando el aumento de los costos de la IA?
Cinco fuerzas empujan la factura hacia arriba, y la mayoría de las empresas están expuestas a todas a la vez. Cada una sube el costo sin ningún cambio en la lista de precios del proveedor, y por eso es fácil pasarlas por alto en una revisión del presupuesto.
El trabajo corre en el nivel más nuevo y más caro
Los equipos construyen el prototipo con el modelo más potente disponible, lanzan la función y casi nunca revisan esa elección. Cada actualización a un modelo más nuevo mantiene el trabajo a precio de gama alta, aunque un modelo más pequeño ya superaría la misma prueba por una fracción del costo.
La diferencia es grande. A octubre de 2026, Anthropic fija la salida de Claude Opus 5 en $25 por millón de tokens y la de Claude Haiku 4.5 en $5, y OpenAI fija la salida de GPT-6 Astra en $50 y la de GPT-6 Luna en $0.50. La capacidad cuyo precio se desploma es la frontera del año pasado, y la mayoría de los equipos compra la de este año.
Cada solicitud lleva más contexto
Las aplicaciones envían ahora documentos completos, código, historiales de conversación y archivos recuperados en cada solicitud. Un estudio de OpenRouter y a16z sobre más de 100 billones de tokens halló que la longitud media del prompt se multiplicó aproximadamente por cuatro, de unos 1,500 tokens por solicitud a principios de 2024 a más de 6,000 a finales de 2025. La salida casi se triplicó en el mismo periodo, de unos 150 tokens a 400.
La lista de precios no avisa de este crecimiento. A octubre de 2026, Anthropic factura toda su ventana de contexto de 1M de tokens a las tarifas estándar por token, así que una solicitud cuarenta veces más larga cuesta, sin más, cuarenta veces más.
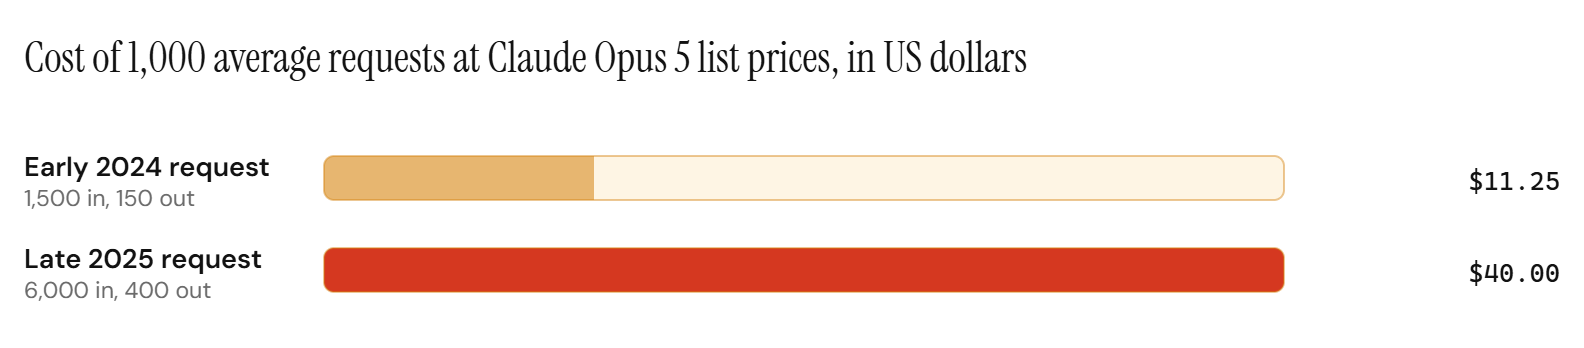
Los modelos piensan antes de responder
Los modelos de razonamiento analizan el problema antes de contestar, y ese razonamiento se factura. La documentación de OpenAI indica que los tokens de razonamiento se facturan como tokens de salida, y la salida es la parte cara de la factura: a octubre de 2026, el precio de salida de Claude Opus 5 es cinco veces el de entrada.
El cambio fue rápido. El mismo estudio de OpenRouter halló que los modelos de razonamiento procesaban una parte insignificante de los tokens de la plataforma a principios de 2025 y más de la mitad a finales de ese año, y atribuye al razonamiento la mayor parte del aumento en la longitud de la salida.
Los agentes convierten una solicitud en muchas llamadas a la API
Un agente que atiende una sola solicitud planifica, busca, usa herramientas y revisa su propio trabajo. Cada paso es una llamada a la API propia que arrastra todo lo anterior, así que el costo de una solicitud depende de cuántos pasos dé el agente. Ese número varía de una ejecución a otra y depende más de cómo se comporta el agente que de lo que preguntó el usuario.
Además, los agentes trabajan sin que nadie escriba. Un agente de soporte o un agente de código puede hacer miles de llamadas a la API por hora en todo un equipo. Nuestra guía de optimización de costos de IA agéntica explica cómo los ingenieros mantienen acotada cada ejecución.
La IA ha pasado de los pilotos a todos los equipos
Hace dos años, la pregunta abierta era si las empresas usarían la IA siquiera, como lo resumió J.P. Morgan en julio de 2026. Hoy está en las colas de soporte, las herramientas de ventas, los flujos de documentos y los editores de los ingenieros, y cada nuevo uso añade su propia línea a la factura.
Los precios han seguido al uso. J.P. Morgan señaló que los proveedores están pasando los planes empresariales de un cobro por puesto a precios que crecen con la actividad, de modo que para muchas empresas la IA ya se factura como un suministro. Un gasto que antes estaba limitado por el número de licencias ahora crece con cada tarea.
¿La IA cuesta más que los empleados?
Para algunos equipos, ya es así. Fortune informó de que Bryan Catanzaro, vicepresidente de aprendizaje profundo aplicado en Nvidia, dijo a Axios en abril de 2026 que, para su equipo, el costo del cómputo supera con creces el costo de los empleados.
La comparación da para un titular y responde a una pregunta muy concreta. Un grupo de investigación que construye modelos siempre gastará mucho en cómputo. En una empresa operativa, el gasto en IA por empleado mide el tamaño de la factura. Lo que un líder necesita saber es qué produce cada unidad de ese gasto.
La comparación útil se hace por tarea: cuánto cuesta con IA un ticket resuelto, un contrato revisado o un informe redactado, frente a lo que costaba antes y a lo que vale para el negocio. Nuestra guía sobre el costo por tarea de la IA explica cómo definir esa cifra y hacerle seguimiento.
¿Cómo saber si el gasto en IA vale la pena?
Pon precio al trabajo tarea por tarea. Los tokens que consume una tarea varían muchísimo según el tipo de trabajo, así que una sola media para toda la empresa oculta a dónde va el dinero.
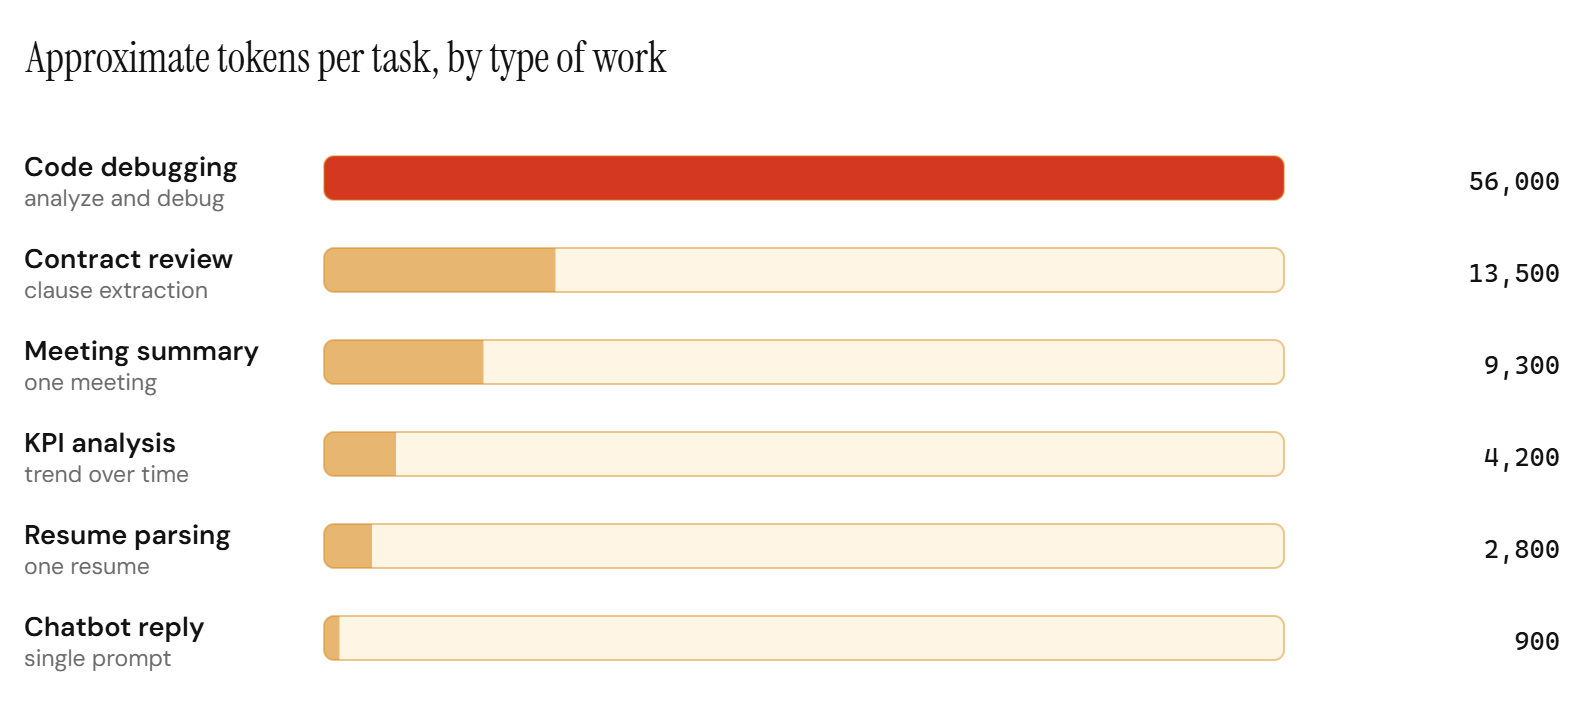
Para cada tipo de tarea importante, tres números deciden si el gasto se justifica.
| Número | Qué te dice |
|---|---|
| Costo por tarea completada | Cuánto cuesta una unidad de trabajo de IA |
| Valor por tarea completada | Tiempo ahorrado, ingresos ganados o riesgo evitado |
| Tareas completadas al mes | Cuánto pesa la diferencia en total |
Una tarea cuyo valor por ejecución supera con holgura su costo merece escalarse, y su costo merece gestionarse a medida que escala. Una tarea con un margen estrecho o desconocido necesita una forma más barata de ejecutarse, o una medida más clara de su valor, antes de crecer. La mayoría de las facturas que sorprenden al equipo de finanzas crecieron justo en ese hueco: subió el volumen de tareas cuyo costo por ejecución nadie había medido.
¿Qué pueden hacer los líderes ante el aumento de los costos de la IA?
Cada causa anterior tiene una respuesta, y todas dejan funcionando el trabajo útil.
| Causa | Medida del líder | Por dónde empezar |
|---|---|---|
| Gasto que nadie sabe explicar | Medir el costo por tarea de las cargas principales | Costo por tarea |
| Uso extendido a todos los equipos | Fijar presupuestos de tokens y niveles por defecto | Presupuestos de tokens |
| Nivel más caro por defecto | Probar niveles más baratos con una evaluación | Reducir costos de tokens |
| Contexto y razonamiento | Usar caché, recortar contexto, limitar el razonamiento | 12 técnicas |
| Pasos de agente | Limitar pasos y tokens por ejecución | Costos de IA agéntica |
| Una tarea con enorme volumen | Darle un modelo personalizado | Mira la sección siguiente |
La mayoría son cambios de configuración y de política que un equipo puede hacer en un trimestre. El último cambia el precio del propio trabajo, y eso pesa más cuando una sola tarea se lleva gran parte de la factura.
¿Cuándo cambia un modelo personalizado la curva de costos?
Cuando una tarea se ejecuta miles de veces al día en un modelo de frontera, cada repetición paga el precio de frontera, y la mayoría de esas solicitudes son rutinarias. Un modelo personalizado entrenado para esa tarea puede encargarse de la parte rutinaria a un costo por tarea mucho menor, mientras los modelos de frontera se quedan con los casos difíciles. El costo por tarea baja en tu carga de trabajo más grande y se vuelve más predecible, porque la parte rutinaria la atiende un modelo que es tuyo.
Esto es lo que construye Ertas con el endpoint de modelo adaptativo: un único endpoint de API para una de tus tareas. Al principio, los modelos de frontera responden todas las solicitudes. Un modelo personalizado entrenado con tus solicitudes y con los comentarios de tu equipo se ejecuta en segundo plano con tráfico real, y toma el relevo cuando supera tus evaluaciones y das tu aprobación. Los casos difíciles siguen en los modelos de frontera. Por ahora el endpoint funciona solo por invitación, y estamos desarrollando una versión más ágil para abrirlo a más empresas.
A medida que crece el volumen, el tráfico adicional llega al modelo personalizado, así que el gasto en frontera solo crece con los casos difíciles.
Tus ingenieros apuntan la tarea al endpoint cambiando un nombre de modelo. Nosotros supervisamos el modelo y lo reentrenamos a medida que cambia tu trabajo, y cada nueva versión supera las mismas evaluaciones antes de atender tráfico. Funciona gestionado por Ertas, en tu nube u on-premise, y es tuyo.
El ahorro viene de servir un modelo construido para un solo trabajo. En nuestro estudio QMSum, un modelo entrenado para una tarea de resumen de reuniones tuvo un costo estimado de servicio de $0.00053 por consulta, frente a $0.104 de Claude Opus 5 y $0.0130 de GPT-5.6 Luna a precios de lista síncronos, y respondió en 0.39 segundos frente a 9.0 segundos de Claude Opus 5. Esa estimación no incluye el costo de entrenamiento. Cada tarea tiene su propio nivel de calidad, y por eso cada cambio espera a tus evaluaciones.
Preguntas Frecuentes
¿Por qué son tan altos los costos de la IA en 2026?
Las empresas usan muchos más tokens que hace un año. Las solicitudes llevan más contexto, los modelos de razonamiento facturan su razonamiento como salida, los agentes hacen muchas llamadas a la API por solicitud y la IA se ha extendido por equipos y productos. Buena parte de ese trabajo corre en modelos de gama alta, cuya salida cuesta entre $25 y $50 por millón de tokens a octubre de 2026.
¿El precio de los tokens de IA sube o baja?
Las dos cosas, según lo que midas. El precio de un nivel fijo de capacidad ha caído 10 veces o más por año, según a16z y Epoch AI. El precio efectivo que paga el mercado por token subió más de un 60% entre diciembre de 2025 y julio de 2026 en un índice de Bloomberg citado por J.P. Morgan, a medida que se disparaba la demanda de cómputo.
¿De verdad la IA cuesta más que los trabajadores?
Para algunos equipos, sí. Un responsable de investigación de Nvidia dijo a Axios en abril de 2026 que el costo de cómputo de su equipo supera con creces el de sus empleados. Para la mayoría de las empresas, la prueba más útil es por tarea: cuánto cuesta una tarea completada con IA, frente a lo que costaba antes y a lo que vale.
¿Por qué creció nuestra factura de IA si no sumamos usuarios?
Creció el uso por solicitud y por persona. Los prompts más largos, el razonamiento, los pasos de agente y los cambios de modelo elevan los tokens detrás de cada tarea, y ninguno aparece como un puesto nuevo. Pide a tu equipo de ingeniería los tokens por tarea de cada carga de trabajo en los últimos seis meses para ver cuál se movió.
¿Bajarán solos los costos de la IA?
Si siguen las tendencias que midieron a16z y Epoch AI, el precio de cualquier capacidad concreta seguirá cayendo. Las facturas bajan cuando alguien mueve el trabajo a una capacidad más barata: un nivel más pequeño, un prefijo en caché, un trabajo por lotes o un modelo personalizado. Si nadie lo hace, el uso nuevo suele absorber la bajada de precios.
¿Cómo reduce los costos de IA un modelo personalizado?
Un modelo entrenado para una sola tarea lleva solo lo que esa tarea necesita, así que cuesta mucho menos servir cada solicitud. Con un endpoint de modelo adaptativo, se encarga de la parte rutinaria de una tarea de alto volumen cuando supera tus evaluaciones, y los casos difíciles siguen yendo a los modelos de frontera.
La Versión Corta
Las facturas de IA suben aunque el precio por token baje, porque las empresas compran la capacidad más nueva, ponen más tokens en cada tarea y hacen más tareas cada mes. Mide el costo por tarea, fija presupuestos y niveles por defecto, aprovecha los ahorros de configuración y luego dale a tu tarea de mayor volumen un modelo entrenado para ella.
Si una sola tarea ya se lleva la mayor parte de tu factura, agenda una llamada y revisamos los números contigo.
Fuentes: a16z sobre LLMflation, Epoch AI sobre la evolución de los precios de inferencia, J.P. Morgan (incluidas las cifras de tareas de Wolfe Research), estudio State of AI de OpenRouter y a16z, conferencia de Google I/O 2026, Fortune, Axios, precios de Anthropic y guía de razonamiento de OpenAI. Precios verificados el 6 de octubre de 2026.